3. 常见数据偏差总览
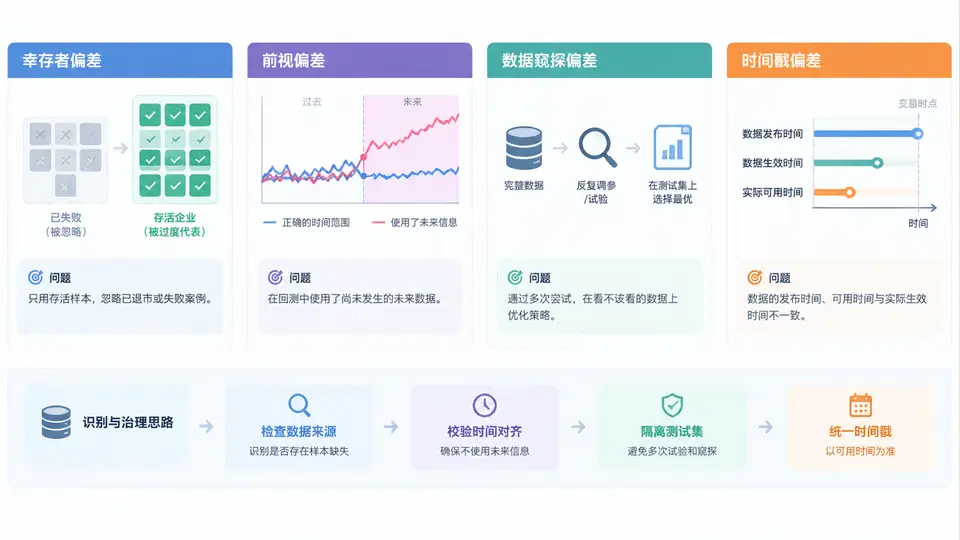
在量化回测中,策略逻辑本身正确,却因为数据偏差导致回测结果虚高,是最常见也最危险的失败模式。数据偏差的本质是:回测所使用的数据,与策略在真实交易时点能够获得的信息不一致。这种不一致可能来自样本筛选、时间对齐、信息泄露或反复试验。本节将系统梳理四类高频偏差,并给出可落地的识别方法。
一、核心原理:偏差来自“信息集错配”
任何回测都可以抽象为一个决策函数:在时刻 t,策略依据信息集 I(t) 生成信号 s(t),并在 t+Δ 执行。若回测中使用的 I'(t) 包含了真实时刻 t 无法获得的信息,或样本空间被事后筛选,回测收益就会被系统性高估。四类偏差分别对应信息集错配的不同来源:
- 幸存者偏差:样本空间被“当前仍存活”这一未来条件筛选。
- 前视偏差:信息集包含了未来才发布或未来才可知的数据。
- 数据窥探偏差:研究者通过反复试验,隐式地把测试集信息注入策略选择。
- 时间戳偏差:数据记录时间与真实可获取时间不一致,导致对齐错误。
统一识别原则:对每一个信号,追问三个问题——这个数据在真实时刻 t 是否已经存在?是否已经发布?我是否已经知道它?三者任一为“否”,就存在偏差风险。
二、四类偏差的分类与识别方法
| 偏差类型 | 典型来源 | 识别信号 | 治理方向 |
|---|---|---|---|
| 幸存者偏差 | 股票池仅含当前上市标的;基金库仅含存续产品 | 回测标的数量随时间只增不减;退市、清盘样本缺失 | 使用历史成分股、含退市样本的全量数据库 |
| 前视偏差 | 用当日收盘价决策并当日成交;财报用报告期而非公告日 | 信号与成交同日;财务字段日期为报告期 | 信号滞后一日;财务数据按公告日对齐 |
| 数据窥探偏差 | 反复调参、多次回测后选最优;同一数据既调参又验证 | 参数在样本内极优、样本外骤降;回测次数无记录 | 样本内外隔离、滚动前推、记录试验次数 |
| 时间戳偏差 | 时区不统一;数据入库时间被当作事件时间;复权价回溯修改 | 跨市场对齐错位;复权因子覆盖历史 | 统一时区、区分事件时间与入库时间、使用点对点复权 |
三、方法流程:从数据到信号的对齐检查
建议在回测前执行一套固定的对齐检查流程,把偏差识别前置到数据准备阶段:
- 确定决策时点:明确策略在每日何时决策、何时下单,形成时间基线。
- 标注数据可用时点:为每个字段记录“事件时间”和“可获取时间”,财务数据以公告日为准。
- 构建历史样本空间:按每个历史时点的真实成分股或存续产品构建标的池。
- 信号与成交分离:信号使用
t时刻可得信息,成交使用t+1或更晚价格。 - 隔离验证集:调参只在训练段进行,验证段仅用于评估,且记录试验次数。
- 统一时间基准:所有数据转换为同一时区,并保留原始时间戳以便审计。
# 示例:财务数据按公告日对齐,避免前视偏差
# 错误做法:用报告期直接 merge
df = price.merge(financial, on=['code', 'report_date'])

# 正确做法:按公告日对齐,且公告日必须早于或等于决策日
df = price.merge(
    financial,
    left_on=['code', 'trade_date'],
    right_on=['code', 'announce_date'],
    how='left'
)
df = df[df['announce_date'] <= df['trade_date']]
四、案例与场景:一次“完美回测”的复盘
某策略在 2018—2023 年回测年化收益 35%,最大回撤仅 8%。上线后实盘三个月亏损 12%。复盘发现三个叠加问题:
- 幸存者偏差:股票池取自当前沪深 300 成分股,期间被剔除的弱势股全部未进入回测,收益被抬高。
- 前视偏差:财务因子使用报告期数据,而财报实际在报告期后 1—3 个月才公告,相当于提前使用了未来信息。
- 数据窥探偏差:策略参数经过约 200 次网格搜索,最终选出的参数在样本内最优,但样本外无稳定性。
复盘结论:三类偏差同时存在时,回测收益会被多重放大。修正后该策略年化降至 9%,最大回撤扩大到 22%,才接近真实水平。偏差治理不是“优化”,而是“还原真相”。
五、常见误区与自查清单
实践中,很多团队只关注前视偏差,却忽略幸存者偏差和数据窥探偏差。以下清单可用于快速自查:
- 回测标的池是否按历史时点动态构建,而非使用当前名单?
- 财务、公告、舆情等数据是否以“可获取时间”而非“事件时间”对齐?
- 信号与成交是否至少间隔一个可交易周期?
- 参数调优是否只在训练段进行,验证段是否从未参与选择?
- 是否记录了回测试验次数,以评估数据窥探风险?
- 跨市场数据是否统一时区,并区分事件时间与入库时间?
- 复权价是否使用点对点复权,避免未来复权因子污染历史?
教学提示:识别偏差的最有效方式不是记忆定义,而是对每个信号做“时间旅行测试”——假设自己站在历史时刻 t,只允许使用当时能看到的数据,重新生成信号。凡是无法复现的信号,都值得怀疑。
掌握这四类偏差的分类与识别,是后续时间对齐治理和回测可信度评估的基础。只有在数据层面先做到“当时可见、当时可用”,策略评估才有意义。