1. 课程导入
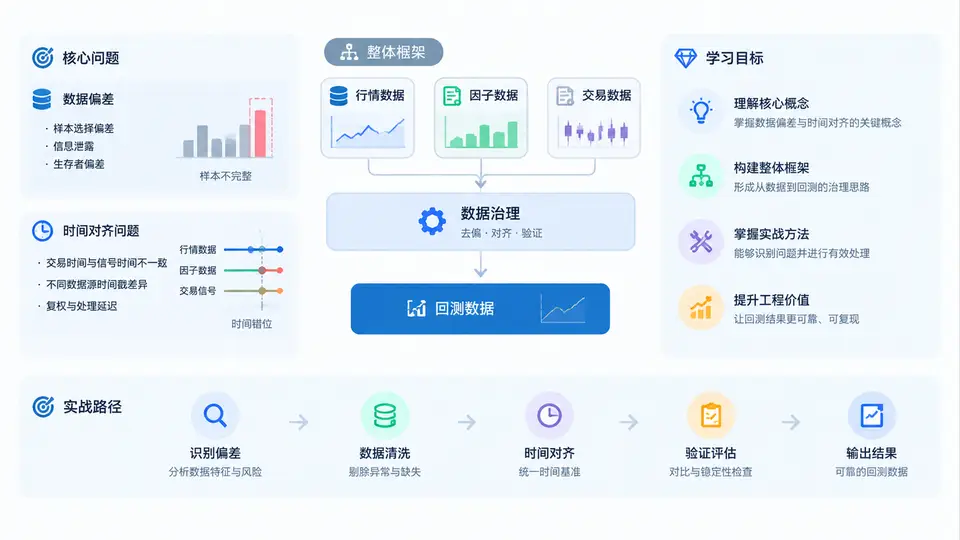
在量化研究与策略开发中,回测是连接假设与实盘的第一道关口。然而,大量策略在回测中表现优异,上线后却迅速失效,根源往往不在模型本身,而在于回测数据偏差与时间对齐错误。本课程的第一章不急于写代码,而是先建立一套完整的认知框架:明确学习目标,厘清核心概念,给出整体治理框架,并说明它在真实工程中的价值。
一、学习目标:从“能跑回测”到“可信回测”
本课程的学习目标分为四个层次,层层递进:
- 认知层:理解回测偏差的常见类型及其产生机理,能识别未来函数、幸存者偏差、前视偏差、数据窥探等典型问题。
- 方法层:掌握时间对齐的基本原则,包括事件时间与处理时间的区分、时区统一、频率对齐、发布延迟建模。
- 工程层:能够设计并实现数据治理流水线,用可复现的方式清洗、对齐、校验回测数据。
- 复盘层:建立偏差审计清单,在策略上线前完成系统性自查,降低“回测幻觉”带来的决策风险。
核心判断标准:一个可信的回测,不是收益曲线最漂亮的回测,而是在信息可得性、时间顺序、样本选择上都经得起推敲的回测。任何使用了“当时不可能知道的信息”的回测,无论收益多高,都不具备实盘参考价值。
二、核心概念:偏差、对齐与治理
要治理问题,先要定义问题。本课程围绕三个核心概念展开:
| 概念 | 定义 | 典型表现 | 后果 |
|---|---|---|---|
| 回测数据偏差 | 回测中使用的数据或信息,与实盘决策时点实际可获得的信息不一致 | 使用收盘价决策却按当日开盘价成交;使用修正后财报数据回测历史 | 回测收益虚高,策略实盘失效 |
| 时间对齐 | 将不同来源、不同频率、不同时区的数据,映射到统一且符合因果顺序的时间轴上 | 日频信号与分钟频成交错配;跨市场时区未统一 | 信号与执行脱节,产生虚假收益 |
| 数据治理 | 对数据采集、清洗、对齐、校验、版本管理进行制度化控制 | 无数据版本记录;清洗规则散落在脚本中 | 结果不可复现,问题难以定位 |
三者关系可以概括为:偏差是病症,对齐是手术,治理是医疗制度。只做单点修复而不建立治理机制,偏差会反复出现。
三、整体框架:四层治理体系
本课程将回测数据治理拆解为四个层次,后续章节将逐一展开:
- 数据层:原始数据的采集、存储与版本管理,确保数据可追溯、可回滚。
- 对齐层:时间轴统一、频率对齐、发布延迟建模,确保信息因果顺序正确。
- 校验层:偏差检测规则、异常值识别、回测前审计清单,确保问题在回测前暴露。
- 应用层:将治理后的数据接入回测引擎,形成可复现、可审计的回测流程。
工程提示:治理框架的价值不在于“一次性修好”,而在于把隐性假设显性化。例如,把“财报数据在发布日才可用”写成配置项,而不是藏在研究员脑中,这样任何回测都能自动遵守该约束。
四、实战价值:为什么这门课值得投入
回测数据偏差与时间对齐治理的实战价值,体现在三个层面:
- 降低试错成本:一个因未来函数导致的虚假策略,可能消耗数周开发与大量资金。治理机制能在早期拦截这类问题。
- 提升研究效率:统一的数据对齐与校验流程,让研究员不必重复处理脏数据,把精力集中在策略逻辑本身。
- 增强决策可信度:当回测结果具备可复现性和审计记录时,投委会与风控部门才能对策略建立真正的信任。
下面用一个简化的配置示例,说明“发布延迟”如何被显性化表达。这类配置是后续对齐层实现的基础:
# data_alignment_config.yaml
datasets:
  financial_report:
    source: "warehouse.financials"
    event_time_field: "report_period_end"
    available_time_field: "publish_datetime"
    timezone: "Asia/Shanghai"
    alignment_rule: "use_available_time"   # 关键:按可得时间对齐,而非报告期
    lag_policy:
      type: "explicit"
      max_lag_days: 90
  market_price:
    source: "warehouse.prices"
    event_time_field: "trade_datetime"
    timezone: "Asia/Shanghai"
    frequency: "1min"
    alignment_rule: "forward_fill_to_signal_time"
这段配置的核心思想是:任何数据都必须声明“它在什么时间点变得可用”。如果只记录事件发生时间而忽略可得时间,回测就会在不知不觉中引入前视偏差。
五、常见误区与复盘视角
在课程开始前,先列出几个高频误区,作为后续学习的“预警清单”:
- 误区一:只要数据源权威,回测就可靠。权威数据同样存在发布延迟、修订和幸存者偏差,数据源质量不等于回测质量。
- 误区二:时间对齐就是统一时区。时区只是第一步,频率对齐、发布延迟、事件顺序同样关键。
- 误区三:偏差检测可以靠人工抽查。人工抽查无法覆盖大规模数据,必须建立自动化校验规则。
- 误区四:治理是一次性工作。数据源、市场规则、策略频率都会变化,治理需要持续维护和版本管理。
复盘提醒:当你发现一个策略回测收益异常高时,第一反应不应是“找到了圣杯”,而应是“我是否用了未来信息”。这种条件反射式的怀疑,是量化研究员最重要的职业习惯之一。
六、本章小结与行动指引
本章建立了课程的整体认知框架:回测数据偏差是核心风险,时间对齐是关键技术手段,数据治理是制度保障。学习目标覆盖认知、方法、工程与复盘四个层次,整体框架分为数据层、对齐层、校验层与应用层。
在进入后续章节前,建议你完成一项准备工作:梳理你当前回测流程中所有数据的时间字段,区分“事件发生时间”与“信息可得时间”。如果发现某些数据只有前者而没有后者,那么你已经找到了第一个需要治理的偏差点。
核心结论:可信回测的起点,不是更复杂的模型,而是更严谨的数据时间观。把“当时能知道什么”作为回测的第一约束,后续所有策略研究才有意义。