3. 风险模型概述
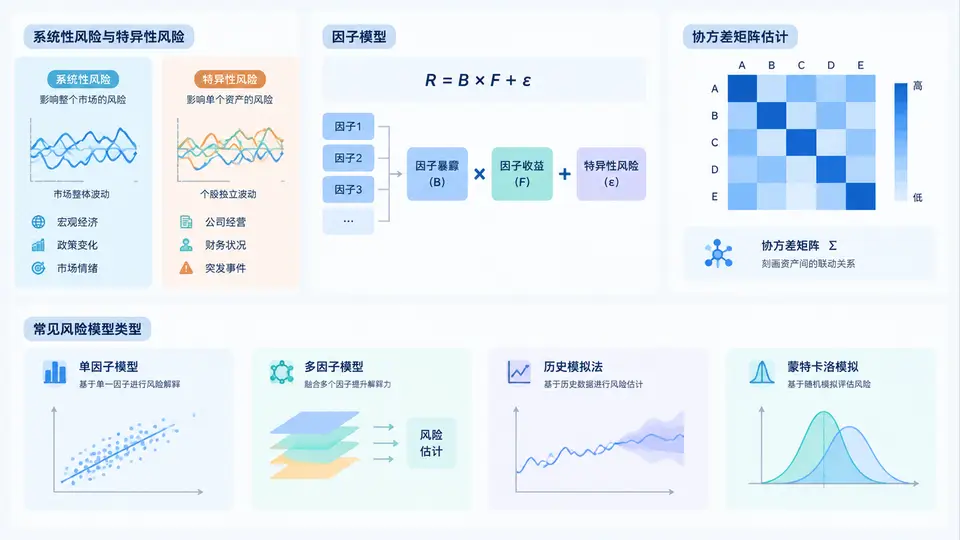
在组合管理中,风险模型不是用来预测收益的“水晶球”,而是用来回答一个更基础的问题:组合的波动和回撤究竟从哪里来?只有把收益的不确定性拆解成可解释、可估计、可管理的部分,组合优化才有稳定的输入。本节从风险的分解讲起,逐步过渡到因子模型、协方差矩阵估计,并梳理业界常见的风险模型类型。
一、核心原理:把风险拆成系统性风险与特异性风险
任何一只股票的收益都可以写成市场共同因素与个股自身因素之和。系统性风险(systematic risk)来自宏观经济、利率、行业景气、市场情绪等共同驱动,无法通过分散化消除;特异性风险(specific risk,也称残差风险、idiosyncratic risk)来自公司经营、管理层变动、突发事件等个体因素,理论上可以通过持有足够多的股票分散掉。
用公式表达,单只股票的收益分解为:
r_i = α_i + Σ_k (β_ik · f_k) + ε_i

其中:
  r_i   : 股票 i 的收益率
  f_k   : 第 k 个共同因子的收益
  β_ik  : 股票 i 对因子 k 的暴露(载荷)
  ε_i   : 股票 i 的特异性收益(残差)
组合层面的风险同样可以分解。若组合权重为 w,因子暴露为 X,因子协方差矩阵为 F,特异性风险对角矩阵为 Δ,则组合总方差为:
σ²_p = wᵀ · (X F Xᵀ + Δ) · w
     = wᵀ X F Xᵀ w   +   wᵀ Δ w
       └── 系统性风险 ──┘   └─ 特异性风险 ─┘
这个分解是风险模型的核心价值:它让优化器知道,哪些风险是“值得承担的”(因子暴露带来的预期补偿),哪些风险是“应该被约束或分散掉的”(特异性风险)。
二、因子模型:从单因子到多因子
因子模型是估计协方差矩阵的降维工具。直接估计 N 只股票的 N×N 协方差矩阵,在 N 很大时样本不足、噪声巨大,甚至不可逆。因子模型假设收益由少数 K 个因子驱动(K ≪ N),从而把估计问题从 N(N+1)/2 个参数降到 N·K + K(K+1)/2 个参数。
常见的因子模型演进路径如下:
- 单因子模型(CAPM):只用市场因子解释收益,β 衡量市场暴露。简单但解释力有限。
- 宏观因子模型:用 GDP、利率、通胀、信用利差等宏观变量作为因子,经济含义清晰,但频率低、估计滞后。
- 基本面因子模型:用估值、成长、质量、动量等风格因子,如 Barra 系列,业界应用最广。
- 统计因子模型:用主成分分析(PCA)从收益数据中提取因子,无需先验假设,但因子含义不直观。
- 机器学习因子模型:用自编码器、树模型等提取非线性因子,灵活但可解释性和稳定性面临挑战。
在 Qlib 中,因子暴露通常以 DataFrame 形式组织,行是交易日,列是股票,值是对应因子暴露。风险模型训练时,先通过横截面回归估计因子收益,再计算因子协方差和特异性风险。
# 伪代码:因子收益的横截面估计
for each date t:
    r_t = X_t · f_t + ε_t
    f_t = (X_tᵀ W X_t)⁻¹ X_tᵀ W r_t   # WLS 估计
    ε_t = r_t - X_t · f_t
三、协方差矩阵估计:从样本协方差到稳健估计
因子模型给出结构,但因子协方差矩阵 F 和特异性风险 Δ 仍需估计。直接使用历史样本协方差会遇到三个问题:噪声大、维度高、非平稳。因此业界发展出一系列稳健估计方法。
| 方法 | 核心思想 | 适用场景 | 主要缺点 |
|---|---|---|---|
| 样本协方差 | 直接用历史收益计算 | 样本充足、维度低 | 高维下噪声大、易不可逆 |
| 指数加权(EWMA) | 近期数据权重更高 | 波动率时变明显 | 衰减因子需调参 |
| 收缩估计(Ledoit-Wolf) | 向结构化目标矩阵收缩 | 高维、样本不足 | 收缩强度依赖假设 |
| 因子模型协方差 | X F Xᵀ + Δ 结构化分解 | 股票池大、风格驱动强 | 因子选择影响大 |
| Newey-West 调整 | 修正自相关与异方差 | 因子收益序列相关 | 滞后阶数需选择 |
实际工程中,通常组合使用:先用因子模型降维,再对因子协方差做 EWMA 或收缩估计,最后对特异性风险做波动率加权和 Newey-West 调整。Qlib 的风险模型模块提供了这些估计器的接口,便于在配置中切换。
四、常见风险模型类型与选型对比
不同风险模型适用于不同目标和数据条件。选型时需权衡解释力、稳定性、计算成本和可获取性。
- Barra 类基本面风险模型:因子含义清晰,覆盖国家、行业、风格三层,适合机构组合归因与风险预算,但因子数据获取成本高。
- 统计风险模型:纯数据驱动,适合量化选股和快速迭代,但因子不稳定、换手高,需定期重新估计。
- 宏观风险模型:适合自上而下的资产配置和压力测试,但对个股组合的解释力较弱。
- 混合风险模型:结合基本面因子与统计因子,兼顾解释力和拟合度,是当前较为主流的方向。
五、案例复盘:一次因子暴露失控的教训
假设某组合优化时只约束了总波动率,未对行业和风格暴露设限。优化器发现“低估值+高动量”因子近期表现好,于是把组合大量集中到少数几个行业。结果市场风格切换,这些行业集体回撤,组合波动远超预期。复盘发现:总波动率约束虽然生效,但风险被错误地集中在了系统性因子上,特异性风险反而被压缩到很低——这正是风险模型分解要解决的问题。
改进方案是在优化中加入因子暴露约束和特异性风险约束:
# 组合优化中的风险约束示例
约束1:组合总波动率 ≤ 目标波动率
约束2:每个风格因子暴露 |β_p,k| ≤ 上限
约束3:行业暴露偏离基准 ≤ 阈值
约束4:特异性风险占比 ≥ 最低比例
目标:最大化预期收益 - 风险惩罚
通过这样的约束,优化器不会把风险全部押注在少数因子上,组合的稳健性显著提升。这也说明,风险模型的价值不仅在于估计协方差,更在于为组合优化提供可解释、可约束的风险维度。
本节从系统性风险与特异性风险的分解出发,介绍了因子模型的结构、协方差矩阵的稳健估计方法,以及常见风险模型的类型与选型逻辑。理解这些内容,是后续在 Qlib 中实际构建风险模型、进行组合优化的必要基础。