1. 课程导入
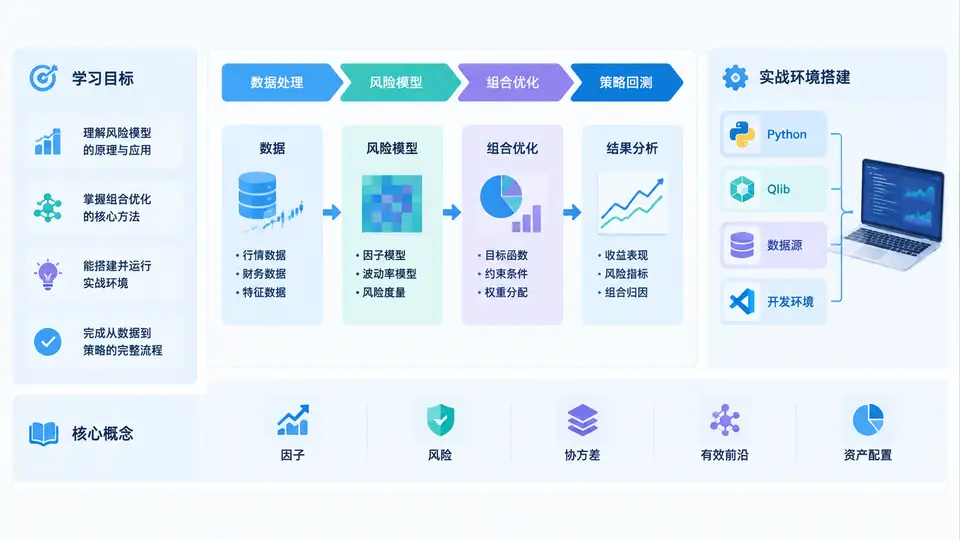
欢迎进入《Qlib风险模型与组合优化实战》。在正式动手之前,我们需要先建立一张清晰的“地图”:这门课到底解决什么问题、用到哪些核心概念、整体流程如何串联,以及我们需要准备怎样的实战环境。很多学习者一上来就急着调参、跑回测,结果往往陷入“策略看起来很美、实盘却大幅回撤”的困境。根本原因在于:没有把风险模型与组合优化放在量化流程的正确位置。本章的目标,就是帮你把这条链路一次性打通。
一、学习目标:你学完能做什么
本课程不是单纯讲理论,也不是只教API调用,而是围绕“可落地的风险控制与组合构建能力”展开。完成学习后,你应当能够:
- 理解风险模型在量化投资中的定位:它解决的是“收益从哪来、风险从哪来、如何归因”的问题。
- 掌握多因子风险模型的基本结构:因子暴露、因子收益、特异性风险与协方差矩阵估计。
- 使用Qlib完成数据准备、因子计算、风险模型训练与组合优化求解。
- 构建带约束的均值—方差优化、风险平价或最大分散化组合,并评估其样本外表现。
- 识别常见陷阱:过拟合、约束冲突、协方差矩阵病态、交易成本忽略等。
一句话总结:风险模型负责“看清风险”,组合优化负责“配置风险”,二者结合才能把预测信号转化为可管理的投资组合。
二、核心概念:先统一语言
在后续章节中,我们会反复使用以下概念。请先建立直觉,不必死记公式。
| 概念 | 含义 | 在实战中的作用 |
|---|---|---|
| 因子暴露 | 资产对某个风险因子(如市值、动量、波动率)的敏感度 | 解释收益来源,控制风格偏离 |
| 因子收益 | 因子单位暴露带来的收益 | 估计风险溢价,进行收益预测 |
| 特异性风险 | 无法被共同因子解释的个体风险 | 决定分散化收益与组合残差风险 |
| 协方差矩阵 | 资产间风险联动关系的数学表达 | 组合优化的核心输入 |
| 组合优化 | 在约束下求解最优权重 | 把信号转化为可执行持仓 |
其中,协方差矩阵是连接风险模型与组合优化的桥梁。如果直接使用样本协方差,在资产数量多、历史窗口短时极易出现估计误差,导致优化器给出极端权重。风险模型的价值,正是通过结构化分解来提升协方差估计的稳定性。
三、整体框架:从数据到组合的流水线
本课程遵循一条完整的量化流水线,你可以把它理解为一条“工厂产线”:
- 数据层:行情、财务、因子数据清洗与对齐,使用Qlib的DataHandler管理。
- 风险模型层:计算因子暴露,估计因子收益与特异性风险,合成协方差矩阵。
- 信号层:基于Alpha因子或机器学习模型生成预期收益。
- 优化层:在权重、行业、风格、换手率等约束下求解最优组合。
- 回测与归因层:评估收益、风险、换手与归因,迭代改进。
学习建议:不要跳过数据层和风险模型层直接学优化。优化器只是“放大器”,输入有偏,输出必然失真。
四、实战环境搭建:一次配置,全程复用
我们使用Qlib作为核心框架。建议使用Python 3.8~3.10,并创建独立虚拟环境。以下命令适用于Linux/macOS,Windows用户可将激活命令替换为对应脚本。
# 创建并激活虚拟环境
python -m venv qlib_env
source qlib_env/bin/activate

# 安装Qlib核心包
pip install pyqlib

# 安装组合优化常用依赖
pip install numpy pandas scipy cvxpy

# 验证安装
python -c "import qlib; print(qlib.__version__)"
Qlib首次使用需要初始化数据。我们通常使用官方提供的小型数据集进行快速验证:
# 下载并初始化示例数据
python -m qlib.run.get_data qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn

# 在代码中初始化
import qlib
from qlib.constant import REG_CN

qlib.init(provider_uri="~/.qlib/qlib_data/cn_data", region=REG_CN)
如果初始化成功,你会看到类似日志:
[INFO] qlib.data - data provider uri: /home/user/.qlib/qlib_data/cn_data
[INFO] qlib.data - region: cn
[INFO] qlib.data - calendar range: 2008-01-02 ~ 2020-12-31常见坑:路径中的~在部分环境下不会被自动展开,建议写成绝对路径;另外,数据下载需要网络,若失败可先检查代理或改用离线数据包。
五、案例场景:一个最小可运行示例
为了让你立刻感受到“风险模型+组合优化”的闭环,我们给出一个极简场景:假设已有三只股票的预期收益和因子暴露,我们希望在总权重为1、单票权重不超过0.6的约束下,最小化组合方差。
import numpy as np
import cvxpy as cp

# 预期收益
mu = np.array([0.08, 0.10, 0.06])

# 协方差矩阵(可由风险模型估计得到)
Sigma = np.array([
    [0.04, 0.01, 0.00],
    [0.01, 0.09, 0.02],
    [0.00, 0.02, 0.05]
])

w = cp.Variable(3)
objective = cp.Minimize(cp.quad_form(w, Sigma))
constraints = [cp.sum(w) == 1, w <= 0.6, w >= 0]
prob = cp.Problem(objective, constraints)
prob.solve()

print("最优权重:", np.round(w.value, 4))
print("组合方差:", round(prob.value, 6))运行后你会得到一组分散化的权重。这个例子虽然简单,但它已经包含了组合优化的全部要素:目标函数、约束条件、求解器。后续章节只是把mu和Sigma换成更真实的估计结果。
六、误区与复盘:新手最容易踩的四个坑
- 误区一:把风险模型当成收益模型。风险模型解释风险,不直接预测收益。用它选股,方向就错了。
- 误区二:忽略约束的现实意义。没有约束的均值—方差优化会给出极端权重,实盘无法执行。
- 误区三:用全样本估计协方差。这会引入未来信息,导致回测虚高。必须滚动窗口或使用风险模型。
- 误区四:只看收益不看换手。高换手会吞噬利润,优化时必须加入换手率惩罚或约束。
复盘要点:每次优化后,问自己三个问题——权重是否可执行?风险是否被正确归因?样本外是否稳定?这三个问题贯穿本课程始终。
现在,你已经拥有了本课程的“全局地图”和“实战工具箱”。接下来,我们将从数据层开始,一步步搭建属于你自己的风险模型与组合优化系统。