3. 量化研究工作流与Qlib定位
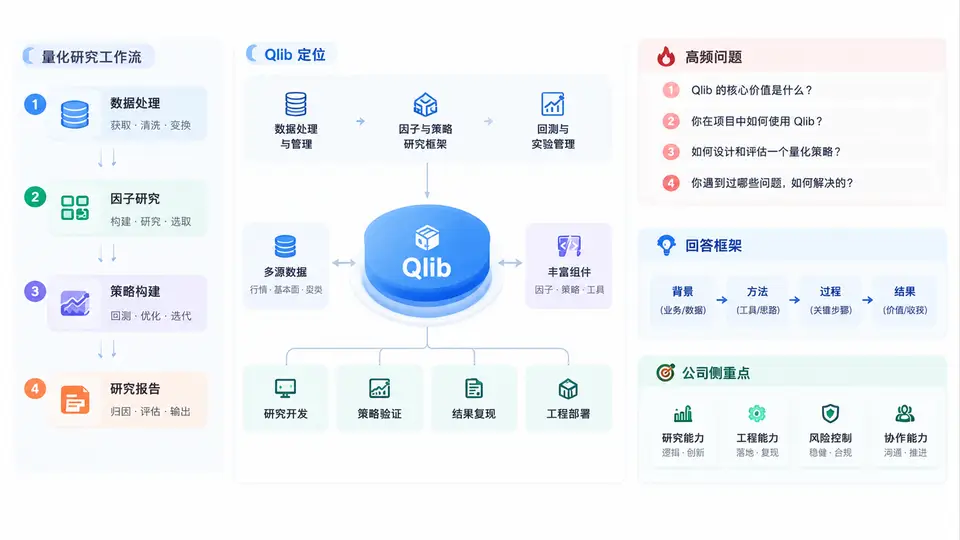
在Qlib量化研究岗面试中,面试官几乎不会只问“Qlib怎么用”,而是通过工作流问题判断你是否真正理解从数据到信号、从信号到组合、从组合到归因的完整闭环。Qlib在这条链路中的定位,不是替代研究员的“黑箱”,而是把数据、模型、回测、执行和归因标准化,让研究员把精力放在因子逻辑与风险控制上。因此,回答这类问题的核心不是背API,而是展示你对研究流程的掌控力。
一、核心原理:Qlib不是回测框架,而是研究工作流操作系统
很多候选人把Qlib当成“一个能跑回测的库”,这是最大的认知偏差。Qlib的设计哲学是把量化研究中的重复劳动工程化:数据以统一格式落盘,因子表达式可版本化,模型训练与预测解耦,回测与执行分离。面试官想听到的是:你理解Qlib的DataHandler、Dataset、Model、Strategy、Executor各自解决什么问题,以及它们如何串成可复现的实验。
核心原理可以概括为三点:第一,数据与计算分离,避免每次实验都重新清洗数据;第二,配置驱动实验,用YAML或代码固定随机种子、时间切分和股票池;第三,滚动训练与样本外验证,确保信号在真实交易中不会因为未来函数而虚高。
二、方法流程:从数据到归因的标准回答路径
当被问到“请描述你的量化研究流程”时,建议按以下五步展开,每一步都点出Qlib的对应模块和你的控制点:
- 数据准备:确定股票池、时间范围、频率和字段。使用Qlib的
dump_bin.py或自定义脚本将行情、财务、另类数据转为二进制格式,并做复权、停牌、涨跌停标记。 - 因子与特征工程:用表达式引擎定义Alpha因子,例如
Ref($close, 1)/$close - 1,并做去极值、标准化、中性化。强调因子逻辑先于代码。 - 模型训练与预测:按时间滚动切分训练集、验证集、测试集。Qlib的
Dataset支持TSDataset和DataLoader,模型可选LightGBM、LSTM、Transformer等。关键控制点是避免标签泄漏。 - 组合构建与回测:用
TopkDropoutStrategy或自定义策略生成持仓,设置交易成本、滑点、换手率约束。回测结果要看夏普、最大回撤、IC、换手率,而不是只看收益。 - 归因与复盘:按行业、市值、因子暴露拆解收益,判断收益来自选股还是风格暴露。Qlib的
analysis模块可辅助生成报告。
面试加分句:“我会把每次实验的配置、数据版本、随机种子和回测区间记录在实验管理工具中,确保任何一次结果都能复现。Qlib的配置化设计正好支持这一点。”
三、高频问题与回答框架
以下表格整理了Qlib工作流相关的高频问题、回答要点和公司侧重点,建议在面试前逐条模拟:
| 高频问题 | 回答框架 | 公司侧重点 |
|---|---|---|
| Qlib在你的研究流程中扮演什么角色? | 定位为工作流操作系统,覆盖数据、因子、模型、回测、归因;强调可复现和标准化。 | 大厂关注工程化能力与团队协作效率。 |
| 如何避免未来函数和数据泄漏? | 时间切分、滚动训练、标签对齐、停牌与涨跌停处理;用样本外测试验证。 | 私募与自营关注实盘稳健性,容错率低。 |
| 因子失效了怎么办? | 先归因:是逻辑失效、拥挤还是市场风格切换;再决定剔除、正交化或调整权重。 | 量化对冲基金关注因子生命周期管理。 |
| 回测收益很好但实盘差,怎么排查? | 检查交易成本、滑点、流动性、涨跌停无法成交、过拟合、样本外衰减。 | 所有公司都关注回测与实盘的一致性。 |
| Qlib的模型和策略如何解耦? | 模型只输出预测分数,策略负责仓位与风控;便于替换模型和策略做对比实验。 | 大厂关注模块化与快速迭代能力。 |
四、案例场景:一次因子研究复盘
假设你发现一个动量因子在回测中IC很高,但实盘表现平平。面试官希望听到你如何用Qlib工作流定位问题。你可以这样回答:
- 数据层:检查是否使用了未来复权数据,停牌股票是否被错误纳入。
- 因子层:计算因子与常见风格因子的相关性,判断是否只是市值或行业暴露的代理。
- 模型层:查看训练集与测试集的IC衰减曲线,判断是否过拟合。
- 组合层:分析换手率和交易成本,高换手可能吃掉大部分收益。
- 归因层:按行业和市值拆解,确认收益来源是否可持续。
这个案例的价值在于展示你用流程定位问题,而不是凭感觉调参。Qlib在这里的作用是让每一层都有可检查的输出。
常见误区:只讲Qlib的API调用,不讲研究逻辑;只讲收益,不讲风险和成本;只讲单次回测,不讲滚动样本外验证。面试官一旦追问“实盘为什么不一样”,就会暴露短板。
五、公司侧重点与表达策略
不同公司对Qlib工作流的关注点不同。大厂平台型团队更关注工程化、可复现、协作效率,回答时多提配置管理、实验追踪和模块解耦;私募与自营更关注实盘稳健性、交易成本和风险控制,回答时多提样本外验证、滑点建模和归因分析;量化对冲基金则关注因子生命周期和组合优化,回答时多提因子拥挤度、正交化和风险模型。
无论哪类公司,表达时都建议用“结论先行 + 流程展开 + 风险收尾”的结构。例如:“我认为Qlib的核心价值是把研究流程标准化,具体分五步……其中我最关注的是样本外验证和交易成本,因为这两点决定策略能否实盘。”这样的回答既有框架,又有个人判断。
练习建议:用Qlib跑通一个最小工作流,从数据准备到回测归因,记录每一步的输入输出和踩坑点。面试时用这个真实案例替代泛泛而谈,说服力会大幅提升。
# Qlib最小工作流示例(伪代码)
from qlib.data import D
from qlib.contrib.model.gbdt import LGBModel
from qlib.contrib.strategy import TopkDropoutStrategy
from qlib.backtest import backtest

# 1. 数据与因子
data = D.features(["SH600000"], ["$close", "$volume"], freq="day")

# 2. 模型训练与预测
model = LGBModel()
model.fit(dataset)
pred = model.predict(dataset)

# 3. 策略与回测
strategy = TopkDropoutStrategy(topk=50, n_drop=5)
report = backtest(strategy, pred, cost=0.0005, slippage=0.0002)

# 4. 归因
print(report.analysis)
掌握Qlib工作流的本质,是让面试官相信你不仅能跑通代码,更能设计可复现、可归因、可实盘的研究流程。这才是量化研究岗真正稀缺的能力。