1. 岗位能力画像与简历优化模板
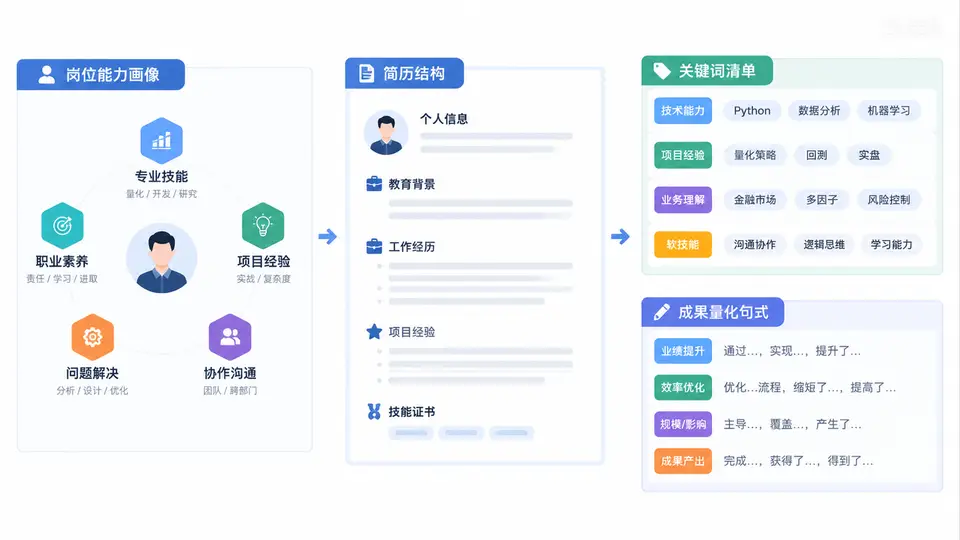
Qlib量化研究岗位的面试,本质上不是“考你会不会用Qlib”,而是验证你是否具备“把市场问题转化为可回测、可归因、可迭代的研究工程”的能力。很多候选人简历上写满因子、模型、收益率,却在面试中被追问三轮就露出破绽,原因往往不是技术不够,而是能力画像与岗位要求错位,简历没有把真正的研究价值表达出来。本章先解决两个前置问题:Qlib量化研究岗到底要什么人,以及你的简历如何用岗位语言重新组织。
一、核心原理:岗位能力画像的四层结构
结合Qlib生态与一线量化机构招聘要求,量化研究岗的能力可以拆成四层:数据与工程基础、因子与模型研究、回测与归因验证、研究与协作表达。前三层决定你能不能干活,第四层决定你能不能进团队。
这张图的关键在于:面试官不会孤立地问“你会不会Qlib”,而是沿着这条链路连续追问。你的简历和回答必须能支撑这条链路,而不是只展示某个单点技能。
二、方法流程:从岗位画像到简历重构
简历优化的流程不是“改措辞”,而是“重新对齐”。建议按以下四步操作:
- 拆解目标岗位JD:把JD中的动词和名词圈出来,例如“因子挖掘”“回测框架”“风险归因”“Python”“Qlib”“多因子模型”。
- 映射自身经历:每条经历对应到能力画像的哪一层,缺失的层级用课程项目、开源贡献或竞赛补齐。
- 用成果量化句式重写:把“负责因子研究”改成“构建12个量价因子,在Qlib回测框架下年化超额收益8.6%,最大回撤降低3.2%”。
- 关键词自然嵌入:确保简历通过ATS筛选,同时让面试官一眼看到Qlib、因子、回测、归因等核心词。
简历不是自传,而是“岗位能力画像的证明文件”。每一行都要回答:这能证明我具备目标岗位的哪一层能力?
三、简历结构模板与关键词清单
推荐采用“一页纸+模块化”结构,顺序为:个人信息、教育背景、技能清单、量化研究经历、项目经历、论文/竞赛/开源。其中量化研究经历是核心,建议用STAR-C结构:情境、任务、行动、结果、复盘。
| 模块 | 必填内容 | 关键词示例 | 量化句式 |
|---|---|---|---|
| 技能清单 | 语言、框架、数据库、工具 | Python、Qlib、Pandas、SQL、Git | 熟练使用Qlib搭建因子回测流水线 |
| 研究经历 | 因子逻辑、数据范围、模型、回测 | Alpha158、LightGBM、IC、换手率 | 基于Alpha158构建因子集,IC均值0.045 |
| 项目经历 | 问题、方案、结果、复盘 | 多因子、风险模型、归因、迭代 | 回测年化收益18.3%,夏普1.42,回撤9.7% |
| 成果量化 | 数字、对比、影响 | 提升、降低、覆盖、迭代 | 因子覆盖率提升22%,回测效率提升3倍 |
关键词清单建议按优先级排列:Qlib、因子挖掘、多因子模型、回测框架、风险归因、Python、机器学习、时间序列、数据清洗、绩效评估。不要堆砌,每个关键词都要有对应经历支撑。
四、案例场景:一段简历的优化前后对比
优化前:
负责量化因子研究,使用Python进行数据分析,参与回测系统开发,撰写研究报告。优化后:
基于Qlib构建量价因子研究流水线,覆盖A股全市场2018-2023年数据;
独立挖掘12个量价因子,经IC检验与分层回测筛选出6个有效因子;
在多因子组合中引入LightGBM非线性加权,回测年化收益18.3%,夏普1.42;
完成收益归因分析,定位动量与波动率因子为主要收益来源,并输出迭代建议。
优化后的版本同时覆盖了数据工程、因子研究、模型、回测、归因五层能力,面试官可以沿着任意一层深入追问,而你都有准备。
五、误区与复盘
- 误区一:只写“使用了Qlib”。面试官关心的是你用Qlib解决了什么问题,而不是你装过这个库。
- 误区二:只写收益率,不写风险。量化研究岗更看重夏普、回撤、换手率、容量等风险调整后指标。
- 误区三:经历与岗位画像脱节。如果你投的是因子研究岗,却大篇幅写数据爬虫,会被认为方向不匹配。
- 误区四:量化数字造假或模糊。写“显著提升”不如写“IC从0.02提升到0.045”,但必须经得起追问。
复盘时问自己三个问题:这段经历能证明我哪一层能力?面试官会从哪里追问?我能否用三分钟讲清楚数据、方法、结果和迭代?如果答案是否定的,就需要重新组织表达。
完成本章的能力画像与简历重构后,你才具备进入后续Qlib技术追问、因子研究、回测归因等章节的基础。简历是面试的“第一张答卷”,岗位能力画像则是你所有回答的底层坐标系。