3. Qlib平台概览
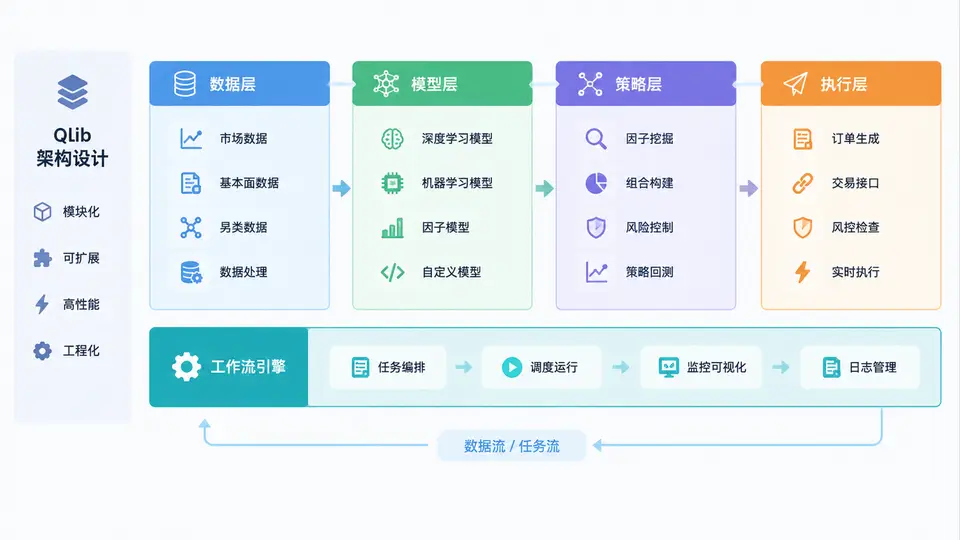
在正式动手写第一行量化策略之前,必须先建立对 Qlib 的整体认知。很多初学者拿到 Qlib 后直接复制示例代码跑通,却说不清数据从哪来、模型在哪训练、信号如何变成订单,一旦需要替换因子或接入自有数据就无从下手。本节从架构视角拆解 Qlib,帮助你形成一张可复用的“平台地图”。
一、核心原理:分层解耦的量化工作流
Qlib 的设计哲学是把量化研究拆成职责清晰的若干层,每层只暴露标准接口,层与层之间通过约定好的数据结构通信。这样做的直接好处是:你可以只替换模型层而保留数据层,也可以只改策略层而沿用已有模型,无需推倒重来。
整体上,Qlib 可划分为五个层次,外加一个贯穿全局的工作流引擎:
- 数据层(Data Layer):负责原始行情、财务数据的存储、表达式计算与高效读取,核心是
DataHandler与表达式引擎。 - 模型层(Model Layer):封装从线性模型到深度学习的各类预测器,统一
fit/predict接口。 - 策略层(Strategy Layer):把模型输出的预测分数转化为具体的目标持仓或交易信号。
- 执行层(Execution Layer):模拟或对接真实交易,处理成交、滑点、手续费与仓位约束。
- 工作流引擎(Workflow):以
qrun和 YAML 配置为入口,把上述各层编排成可复现的端到端流程。
核心思想:Qlib 不是一个大而全的黑盒,而是一组可插拔组件的集合。理解每一层的输入输出契约,比记住 API 名称更重要。
二、方法流程:一次完整运行的数据流
下面这张图展示了从原始数据到回测结果的完整链路,是理解 Qlib 架构最直观的方式:
对应到实际代码,一次典型运行由 YAML 配置驱动,核心字段如下:
qlib_init:
    provider_uri: "~/.qlib/qlib_data/cn_data"
    region: cn
market: &market csi300
benchmark: &benchmark SH000300

data_handler_config: &data_handler_config
    start_time: 2015-01-01
    end_time: 2021-12-31
    fit_start_time: 2015-01-01
    fit_end_time: 2018-12-31
    instruments: *market

task:
    model:
        class: LGBModel
        module_path: qlib.contrib.model.gbdt
    dataset:
        class: DatasetH
        kwargs:
            handler:
                class: Alpha158
                kwargs: *data_handler_config
    record:
        class: SignalRecord
执行 qrun workflow_config.yaml 后,Qlib 会依次完成数据加载、特征计算、模型训练、信号生成、策略决策与回测记录,最终输出收益曲线与风险指标。
三、核心模块速查表
| 层次 | 关键类/模块 | 职责 |
|---|---|---|
| 数据层 | DataHandler、Alpha158、Alpha360 |
加载行情、计算因子表达式、生成训练样本 |
| 模型层 | LGBModel、LinearModel、DEnsembleModel |
拟合特征与标签,输出预测分数 |
| 策略层 | TopkDropoutStrategy、WeightStrategy |
将预测分数转为目标持仓权重 |
| 执行层 | SimulatorExecutor、NestedExecutor |
模拟成交、计算成本、更新组合状态 |
| 工作流 | qrun、QlibRecorder |
编排流程、记录实验、复现结果 |
四、案例场景:替换模型层验证架构解耦
假设你已用 LGBModel 跑通基线,现在想换成线性模型对比效果。得益于分层设计,你只需修改 YAML 中 model 一段:
model:
    class: LinearModel
    module_path: qlib.contrib.model.linear
    kwargs:
        estimator: Ridge
        alpha: 0.05
数据层、策略层、执行层配置完全不动,重新执行 qrun 即可得到新结果。这正是 Qlib 架构价值的体现:变更被限制在单层内部,实验成本大幅降低。
建议在初期就养成用 YAML 管理实验的习惯,把每次改动的配置连同
QlibRecorder 生成的实验 ID 一起归档,后续复盘时能快速定位“哪次改动带来了收益提升”。
五、常见误区与复盘
- 误区一:把 Qlib 当成单一模型库。实际上模型只是其中一层,忽略数据层与执行层会导致回测结果严重失真。
- 误区二:忽视数据层的时间对齐。特征计算若引入未来信息,模型指标会虚高,务必确认
fit_end_time与回测区间严格分离。 - 误区三:跳过执行层直接看预测分数。预测准确率高不等于策略盈利,滑点与手续费会显著侵蚀收益。
- 误区四:不用工作流引擎,手写脚本串联。短期看似灵活,长期难以复现,实验管理会迅速失控。
复盘要点:当你发现回测收益异常亮眼时,优先检查三处——数据层是否存在未来函数、执行层成本参数是否过于乐观、策略层是否使用了当日收盘价成交。这三处是量化回测中最常见的“虚假繁荣”来源。