1. 课程导入
一、什么是AI量化投资
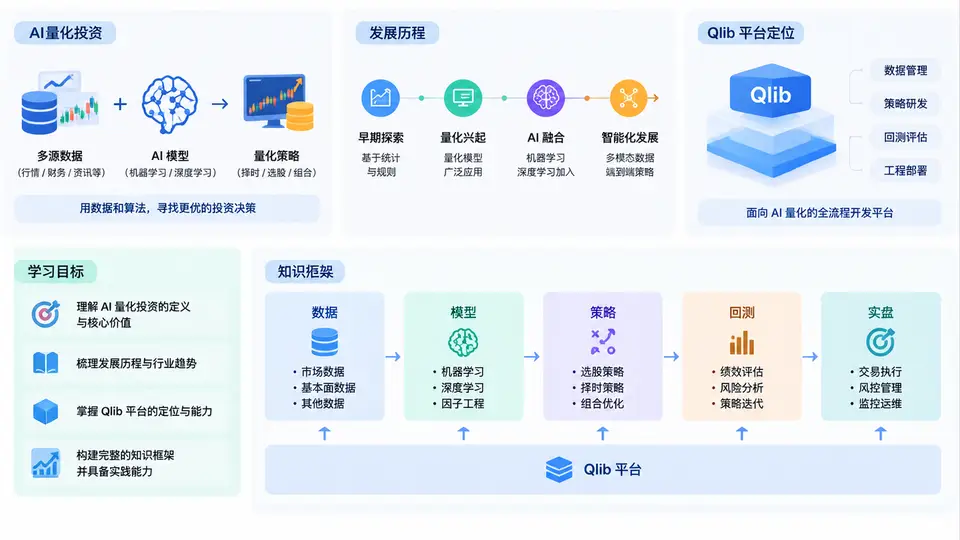
量化投资的核心,是用可计算、可复现的规则替代主观判断,把投资逻辑转化为数据、模型与执行流程。传统量化多依赖人工构造因子与线性模型,而AI量化投资则进一步引入机器学习与深度学习,让模型从海量历史数据中自动学习非线性规律,并输出预测信号、仓位建议或交易决策。
它并不是“让AI自动炒股”这么简单。一个完整的AI量化系统通常包含数据获取与清洗、特征工程、模型训练、信号生成、组合构建、回测评估与实盘执行等环节。AI的价值在于提升预测能力与适应市场变化的能力,但它同样受限于数据质量、过拟合风险与交易成本。
二、发展历程:从规则到学习
理解AI量化的演进,有助于我们看清Qlib所处的位置。其发展大致可分为四个阶段:
- 规则化阶段:以均线、动量、均值回归等手工规则为主,逻辑清晰但容量有限。
- 因子模型阶段:以多因子模型为代表,通过横截面回归筛选有效因子,强调可解释性。
- 机器学习阶段:引入随机森林、梯度提升树等模型,自动学习因子与收益之间的非线性关系。
- 深度学习与端到端阶段:使用LSTM、Transformer、图神经网络等处理时序与关系数据,并逐步走向从数据到信号的端到端流水线。
这一演进背后有两个驱动力:一是算力与数据规模的增长,二是市场对策略迭代速度的要求越来越高。Qlib正是在这样的背景下,试图把研究、回测与工程化流程统一到一个平台中。
三、Qlib平台定位与核心能力
Qlib是微软开源的AI量化投资平台,定位为面向AI量化的端到端研究框架。它并不只是一个回测工具,而是覆盖数据管理、模型训练、策略回测与结果分析的完整工作流。其核心能力包括:
- 统一数据层:提供标准化的金融数据存储与访问接口,支持多种数据源接入。
- 模型库与工作流:内置多种量化模型与训练流程,支持自定义模型扩展。
- 回测与评估:提供贴近真实交易约束的回测引擎,支持多策略对比与归因分析。
- 可复现性:通过配置化实验管理,让研究结果可追踪、可复现。
下面是一个典型的Qlib工作流配置片段,展示了从数据到模型的基本组织方式:
qlib_init:
    provider_uri: "~/.qlib/qlib_data/cn_data"
    region: cn
market: &market csi300
benchmark: &benchmark SH000300
data_handler_config: &data_handler_config
    start_time: 2015-01-01
    end_time: 2021-12-31
    fit_start_time: 2015-01-01
    fit_end_time: 2018-12-31
    instruments: *market
task:
    model:
        class: LGBModel
        module_path: qlib.contrib.model.gbdt
        kwargs:
            loss: mse
            learning_rate: 0.05
    dataset:
        class: DatasetH
        module_path: qlib.data.dataset
        kwargs:
            handler:
                class: Alpha158
                module_path: qlib.contrib.data.handler
                kwargs: *data_handler_config
            segments:
                train: [2015-01-01, 2018-12-31]
                valid: [2019-01-01, 2020-12-31]
                test: [2021-01-01, 2021-12-31]
这段配置体现了Qlib的设计哲学:用声明式配置描述实验,把数据、模型、训练与评估解耦,便于快速替换与对比。
四、课程学习目标与知识框架
本课程的目标不是让你记住某个模型的参数,而是让你具备独立搭建、调试与评估AI量化项目的能力。具体包括:
- 理解AI量化投资的基本原理与常见误区。
- 掌握Qlib的数据组织、工作流配置与核心组件。
- 能够基于Qlib完成从数据准备到模型回测的完整流程。
- 具备分析回测结果、识别过拟合与改进策略的能力。
整体知识框架可以概括为“三层一闭环”:
| 层次 | 核心内容 | 关键产出 |
|---|---|---|
| 数据层 | 行情数据、特征工程、数据处理器 | 干净可用的训练数据集 |
| 模型层 | 模型选择、训练调参、预测信号 | 可复现的预测结果 |
| 策略层 | 组合构建、回测评估、风险控制 | 策略绩效与归因报告 |
| 闭环 | 实验管理、迭代优化、复盘 | 持续改进的研究流程 |
五、常见误区与学习建议
误区一:把回测收益当作真实收益。回测中存在幸存者偏差、未来函数与交易成本低估,实盘表现往往大打折扣。
误区二:过度追求复杂模型。在数据噪声极大的金融市场,复杂模型更容易过拟合,简单模型配合严谨流程往往更稳健。
误区三:忽视数据质量。缺失值、复权错误、停牌处理不当,都会让模型学到错误规律。
学习建议是:先跑通一个最小可用流程,再逐步替换组件。不要一开始就追求高收益策略,而要先确保流程正确、评估可信。Qlib的价值正在于它提供了一套相对规范的工程骨架,让你把精力集中在策略逻辑本身,而不是重复搭建基础设施。