3. 量化投资中的滚动训练
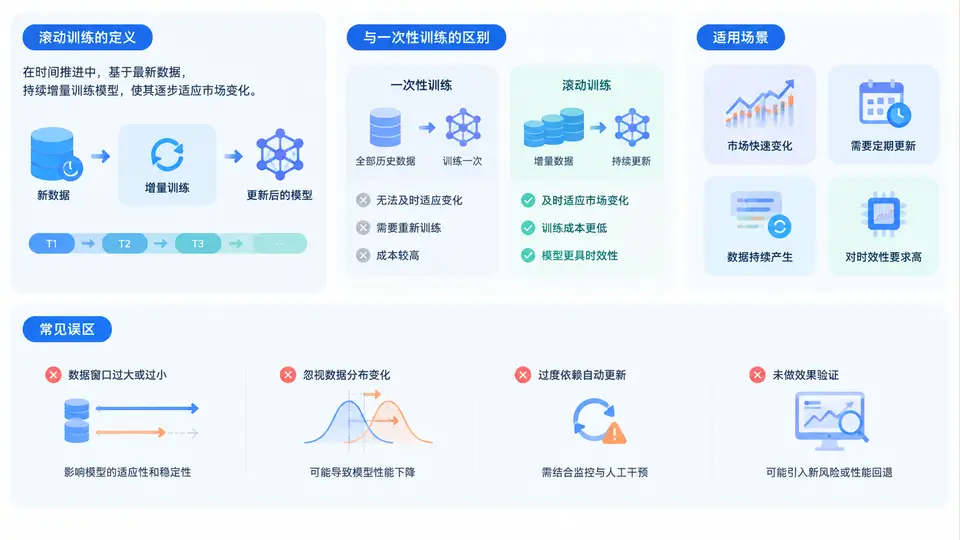
在量化投研中,模型不是一次性交付的“成品”,而更像一条需要持续校准的生产线。滚动训练(Rolling Training)正是让模型随时间推移不断吸收新信息、适应市场状态变化的核心机制。理解它,是构建可持续量化策略的前提。
一、滚动训练的定义与核心原理
滚动训练,指在时间序列上按固定或动态窗口,反复执行“训练—验证—预测”的循环:每次只用截至当前时点的历史数据训练模型,然后对下一段未见数据做预测,随后窗口向前滚动,纳入新数据、剔除旧数据,重新训练。其本质是用时间切片模拟真实投研中“只能看到过去”的信息约束,从而得到更接近实盘的样本外表现。
核心原理可概括为三点:
- 信息因果性:任何时刻的训练集都不得包含未来数据,避免前视偏差(Look-ahead Bias)。
- 分布适应性:市场风格、波动率、流动性会漂移,滚动训练让模型参数随最新分布更新。
- 评估真实性:通过多段样本外预测拼接,得到近似实盘的连续净值曲线,而非单次留出法的偶然结果。
滚动训练不是“把数据切几段分别训练”这么简单,它要求训练、验证、预测在时间轴上严格单向推进,且每次滚动都重新执行完整的特征工程与模型拟合流程。
二、与一次性训练的关键区别
一次性训练(One-shot Training)通常把全部历史数据一次性投入,训练一个固定模型后长期使用。两者在数据使用、评估方式和运维成本上差异显著:
| 对比维度 | 一次性训练 | 滚动训练 |
|---|---|---|
| 数据使用 | 全部历史数据一次性参与 | 按时间窗口分段,逐段纳入新数据 |
| 信息约束 | 易无意引入未来信息 | 严格保证因果性 |
| 样本外评估 | 单次留出,方差大 | 多段滚动拼接,更稳定 |
| 市场适应 | 静态,风格切换后失效 | 动态,随分布更新 |
| 计算与运维 | 成本低,一次完成 | 成本高,需自动化流水线 |
| 典型风险 | 过拟合历史、实盘衰减快 | 窗口选择不当、更新过频 |
需要强调:滚动训练并不必然优于一次性训练。若数据量小、市场结构稳定、因子逻辑长期有效,一次性训练配合定期复核可能更经济。选择取决于数据规模、市场漂移速度与算力预算三者的平衡。
三、方法流程与典型场景
一个标准的滚动训练流程如下:
- 确定时间轴与滚动步长(如每月滚动一次)。
- 划分训练窗口、验证窗口与预测窗口,确保三者时间不重叠且顺序推进。
- 在每个滚动点上,用训练窗口拟合特征处理与模型参数。
- 用验证窗口做超参选择或早停。
- 对预测窗口生成信号,记录样本外表现。
- 窗口前移,重复上述步骤,直至覆盖全部评估区间。
# 以 Qlib 风格伪代码示意滚动训练循环
for start in range(train_start, test_end, step):
    train_slice = data[start : start + train_len]
    valid_slice = data[start + train_len : start + train_len + valid_len]
    test_slice  = data[start + train_len + valid_len : start + train_len + valid_len + test_len]

    model.fit(train_slice, valid_slice)
    pred = model.predict(test_slice)
    record(pred, test_slice.label)
典型适用场景包括:
- 高频或中频价量策略:市场微观结构变化快,模型需频繁更新。
- 宏观驱动或多因子选股:风格轮动明显,滚动训练可捕捉因子有效性漂移。
- 实盘模型监控:用滚动样本外曲线判断模型是否衰减,触发再训练。
实践建议:先用较长的训练窗口保证统计稳定性,再用较短的验证窗口快速响应;滚动步长不宜过短,否则交易成本与过拟合风险会抵消更新收益。
四、常见误区与复盘要点
滚动训练在落地时容易踩以下坑:
- 误区一:窗口越短越“灵敏”。窗口过短会导致模型方差剧增,样本外表现反而更差。应通过实验确定最小有效窗口。
- 误区二:滚动步长等于调仓频率。训练频率与交易频率是两回事,频繁重训不等于频繁交易。
- 误区三:忽略特征工程的滚动一致性。标准化、缺失值填充等若用全量数据统计,会引入未来信息。
- 误区四:只看平均 IC,不看分段稳定性。应检查每段滚动样本外的收益、回撤与换手,识别模型在特定市场状态下的失效。
- 误区五:把滚动训练当作“万能解”。若因子逻辑本身不成立,滚动只会更快地拟合噪声。
复盘时务必核对:训练窗口末端与预测窗口起点之间是否存在时间重叠或数据泄露;验证集是否被重复用于多次超参选择;滚动结果是否扣除了真实交易成本。
总结来看,滚动训练是一种以时间因果性为底线、以分布适应性为目标的模型更新范式。它不能保证盈利,但能显著提升评估的真实性与策略的鲁棒性。掌握其定义、差异、流程与误区,是进入 Qlib 实战前必须打牢的基础。