1. 课程导入
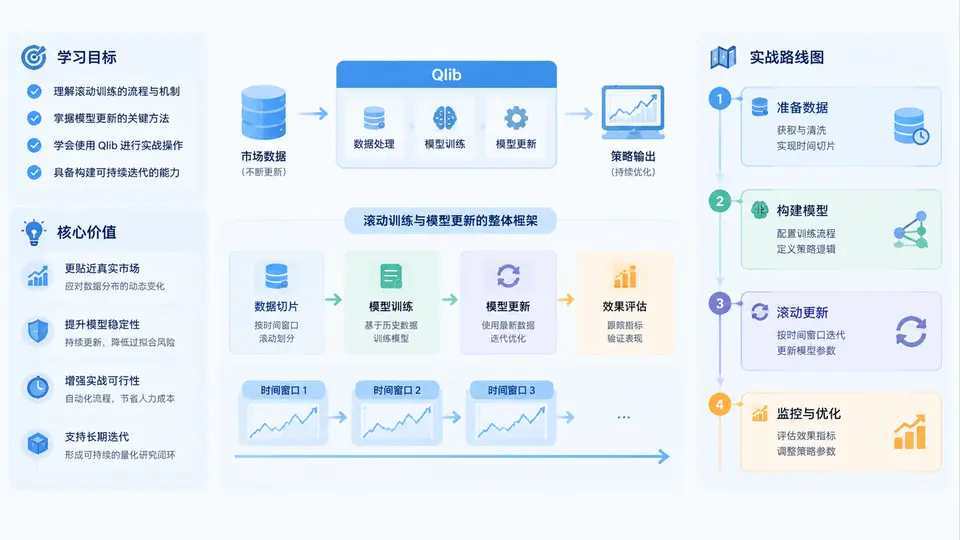
在量化投资的实际生产环境中,一个模型从研究到上线,往往不是“训练一次、部署一年”的静态过程。市场风格切换、因子有效性衰减、交易成本结构变化、数据分布漂移,都会让一个在历史回测中表现优异的模型在实盘中迅速失效。Qlib作为微软开源的AI量化投资平台,提供了从数据处理、特征工程、模型训练到回测评估的完整工具链,而滚动训练与模型更新正是连接“研究原型”与“持续可用生产系统”的关键工程环节。
本课程的目标不是简单介绍Qlib的API用法,而是帮助学习者建立一套可落地、可复现、可监控的滚动训练工程体系。第1章作为课程导入,将明确学习目标、核心价值、整体知识框架与实战路线图,为后续29章的深入实践奠定认知基础。
一、学习目标:从“会跑通”到“能上线”
完成本课程后,学习者应达到以下四个层次的目标:
- 理解原理:掌握滚动训练、扩展窗口、滑动窗口、在线学习、增量更新等概念的区别与适用场景,理解模型衰减的成因与检测方法。
- 掌握流程:能够基于Qlib的
workflow、qrun、Rolling生成器与TaskManager,设计并实现日频、周频或月频的滚动训练流水线。 - 工程落地:能够将滚动训练任务接入调度系统,管理模型版本、数据快照、实验记录与回滚策略,避免“训练成功但上线失败”。
- 评估复盘:能够通过IC、RankIC、回撤、换手率、因子暴露等指标判断模型是否需要更新,并形成更新决策的量化依据。
核心判断标准:一个合格的滚动训练系统,不是“每天自动跑一次训练脚本”,而是能够在数据漂移、模型衰减、资源约束和版本管理之间取得平衡,并让每一次模型更新都有据可查、可回滚、可解释。
二、核心价值:为什么滚动训练是量化生产的刚需
静态模型在实盘中面临三大挑战。第一,市场非平稳性:因子收益的分布随时间变化,历史最优参数未必适用于未来。第二,数据分布漂移:宏观环境、行业结构、投资者行为的变化会导致特征分布偏移。第三,过拟合与信息衰减:模型在训练集上的表现会随着时间推移而下降,尤其是高频因子和短周期策略。
滚动训练的核心价值在于:通过定期或触发式地重新训练模型,使模型始终“贴近”最新市场状态,同时通过验证集和回测机制控制过拟合风险。在Qlib中,这一过程可以借助Rolling、DataHandler、Model和Record等组件实现标准化,从而把研究人员的精力从重复的工程劳动中解放出来,聚焦于因子挖掘与模型结构创新。
| 对比维度 | 静态训练 | 滚动训练 |
|---|---|---|
| 训练频率 | 一次训练,长期使用 | 按日/周/月或事件触发 |
| 数据使用 | 固定历史区间 | 滑动或扩展窗口 |
| 模型衰减应对 | 被动,依赖人工发现 | 主动,定期更新 |
| 工程复杂度 | 低 | 中高,需调度与版本管理 |
| 适用场景 | 低频、稳定因子 | 中高频、动态市场 |
三、整体知识框架:四层结构
本课程的知识框架可以概括为“数据层—训练层—评估层—工程层”四层结构。数据层负责数据快照、特征生成与窗口划分;训练层负责模型定义、滚动策略与超参管理;评估层负责样本外验证、回测与衰减检测;工程层负责调度、日志、版本控制与上线部署。
四、实战路线图:八步闭环
为了让学习路径清晰可执行,本课程将滚动训练实战拆解为八个步骤,每一步都对应后续章节的具体任务:
- 数据准备:使用Qlib的
dump_bin.py或get_data.py构建行情与特征数据,明确训练、验证、测试的时间边界。 - 基线模型:先跑通一个静态模型(如LightGBM或Linear),建立可对比的基线指标。
- 滚动窗口设计:选择扩展窗口或滑动窗口,确定训练长度、验证长度与更新频率。
- 自动化训练:通过
qrun配置或Python脚本,将滚动训练封装为可重复执行的任务。 - 样本外评估:在每一轮滚动中保留严格的样本外区间,计算IC、RankIC、多空收益等指标。
- 衰减检测:设定阈值,当指标连续低于阈值时触发告警或强制更新。
- 版本管理:为每个模型版本记录数据快照、参数、指标和训练时间,支持回滚。
- 上线与回滚:将最优模型推送到预测服务,并保留快速回滚到上一稳定版本的能力。
学习建议:不要试图一次性实现全部八步。建议先完成“数据准备→基线模型→滚动窗口设计”三步,确保单次滚动训练可复现,再逐步引入自动化调度和版本管理。工程复杂度应随策略容量和资金规模逐步提升。
五、常见误区与复盘
在滚动训练的实践中,初学者最容易陷入以下误区:
- 误区一:滚动频率越高越好。高频滚动会显著增加计算成本和过拟合风险,尤其是当训练数据不足时,模型可能学到噪声。应根据策略换手率和因子衰减速度选择频率。
- 误区二:忽略样本外验证。如果每一轮滚动都用全部历史数据训练,再用同一区间评估,指标会严重高估。必须严格划分训练、验证和测试区间。
- 误区三:只关注收益,不关注换手与成本。滚动更新可能导致持仓频繁变动,交易成本会吞噬超额收益。评估时必须纳入换手率和成本假设。
- 误区四:没有版本管理和回滚机制。一旦新模型上线后表现异常,无法快速定位和恢复,会造成实盘损失。
复盘要点:滚动训练的本质是用工程手段对抗模型衰减,而不是追求“永远最优”。一个稳健的滚动系统,应该允许模型在某些阶段表现平庸,但整体风险可控、更新可解释、回滚可执行。
本章作为课程导入,已经勾勒出滚动训练与模型更新的学习目标、核心价值、知识框架和实战路线图。接下来的章节将沿着这条路线,从数据准备开始,逐步深入到Qlib的滚动训练配置、自动化调度、评估体系与生产部署。掌握这套方法,意味着你不仅能让模型“跑起来”,更能让它在真实市场中“活得久”。