3. Qlib核心架构解析
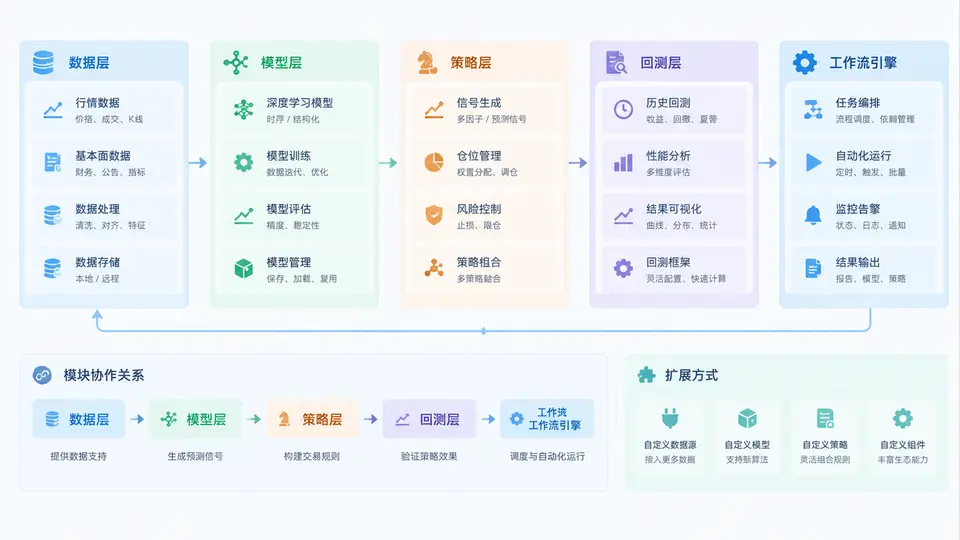
Qlib 的工程价值不在于某个单点模型,而在于它把量化研究从“数据清洗—特征工程—模型训练—信号生成—组合构建—回测评估”串成了一条可复现、可扩展、可并行的流水线。理解这条流水线的分层结构,是后续做深度学习预测与策略迭代的前提。Qlib 的核心架构可以概括为五层:数据层、模型层、策略层、回测层与工作流引擎。它们之间通过统一的接口与配置驱动协作,而不是靠硬编码耦合。
一、核心原理:五层职责与协作关系
数据层负责把原始行情、财务、文本等异构数据整理成统一的时间序列格式,并提供表达式引擎与数据集划分能力。模型层只关心“给定特征,输出预测分数”,不关心数据从哪来、策略怎么用。策略层把预测分数转化为可执行的投资组合或交易信号,例如 TopK 选股、权重分配、风险约束。回测层模拟真实交易环境,计算收益、回撤、换手率等指标,并处理涨跌停、停牌、手续费等细节。工作流引擎则负责编排整个流程,支持记录实验、并行执行与结果复现。
五层之间的数据流是单向且清晰的:数据层输出 Dataset,模型层消费后输出 prediction score,策略层消费分数后输出 order/position,回测层消费订单后输出 portfolio metrics,工作流引擎贯穿始终并记录每一步的配置与产物。这种设计让研究者可以只替换其中一层,而不影响其他层。
workflow 配置文件中同时声明数据、模型、策略与回测参数,执行后自动生成带时间戳的实验目录,保证结果可追溯。
二、方法流程:从配置到回测的完整链路
下面以一个典型的深度学习预测任务为例,展示五层如何协作。假设我们要用 LSTM 预测未来 5 日收益率,并做 TopK 选股回测。
# workflow_config.yaml 核心片段
qlib_init:
    provider_uri: "~/.qlib/qlib_data/cn_data"
    region: cn

market: &market csi300
benchmark: &benchmark SH000300

data_handler_config: &data_handler_config
    start_time: 2015-01-01
    end_time: 2021-12-31
    fit_start_time: 2015-01-01
    fit_end_time: 2019-12-31
    instruments: *market
    infer_processors:
        - class: RobustZScoreNorm
          kwargs: {fields_group: feature}
        - class: Fillna
          kwargs: {fields_group: feature}
    learn_processors:
        - class: DropnaLabel
        - class: CSRankNorm
          kwargs: {fields_group: label}
    label: ["Ref($close, -5) / Ref($close, -1) - 1"]

model:
    class: LSTM
    module_path: qlib.contrib.model.pytorch_lstm
    kwargs:
        d_feat: 20
        hidden_size: 64
        num_layers: 2
        dropout: 0.1
        n_epochs: 50
        lr: 0.001
        batch_size: 1024

strategy:
    class: TopkDropoutStrategy
    kwargs:
        topk: 50
        n_drop: 5
        signal: &signal "&model"

backtest:
    start_time: 2020-01-01
    end_time: 2021-12-31
    account: 10000000
    benchmark: *benchmark
    exchange_kwargs:
        limit_threshold: 0.095
        deal_price: close
        open_cost: 0.0005
        close_cost: 0.0015
        min_cost: 5
执行时,工作流引擎按顺序完成:数据层加载并预处理数据,模型层训练 LSTM 并输出预测分数,策略层根据分数生成每日持仓,回测层模拟交易并计算指标。整个过程可以通过一条命令启动:
qrun workflow_config.yaml运行结束后,实验目录下会生成 prediction.pkl、portfolio_analysis、mlflow 等产物,便于复盘与对比。
三、案例/场景:各层扩展方式与典型用法
Qlib 的扩展性体现在每一层都可以被替换或增强。下表总结了常见扩展点与对应做法。
| 层级 | 扩展目标 | 典型做法 | 关键接口/类 |
|---|---|---|---|
| 数据层 | 接入新数据源或自定义特征 | 编写表达式或自定义 Processor | DataHandler、Processor |
| 模型层 | 替换为自定义深度学习模型 | 继承 Model 并实现 fit/predict | qlib.model.base.Model |
| 策略层 | 实现新的组合构建逻辑 | 继承 BaseStrategy 并重写 generate_trade_decision | qlib.strategy.base.BaseStrategy |
| 回测层 | 调整交易成本或撮合规则 | 配置 exchange_kwargs 或自定义 Exchange | Exchange、Executor |
| 工作流引擎 | 批量实验或超参搜索 | 使用 qrun 配合多配置文件或 MLflow | qrun、MLflow |
例如,若想用自定义的 Transformer 模型替换 LSTM,只需在模型层实现 fit 与 predict 方法,并在配置中修改 module_path 与 class,数据层、策略层与回测层完全无需改动。这正是分层架构带来的解耦收益。
四、误区/复盘:常见问题与排查思路
在实际使用中,初学者容易陷入几个典型误区。第一,混淆数据层与模型层的职责,把特征工程写进模型代码,导致数据泄漏或复现困难。正确做法是把所有与特征相关的处理放在 DataHandler 与 Processor 中,模型只接收标准化后的特征矩阵。第二,忽略回测层的交易约束,直接用预测分数计算收益,导致回测结果虚高。Qlib 的 Exchange 已经内置涨跌停、停牌、手续费等处理,务必在配置中显式声明。
第三,策略层与回测层的信号对齐问题。策略层输出的交易决策必须与回测层的时间索引严格对齐,否则会出现“未来函数”或信号滞后。建议在策略层使用 signal 字段时,明确指定预测分数的日期偏移。第四,工作流引擎的并行与复现问题。Qlib 支持多进程与 MLflow 记录,但若配置文件中的路径使用相对路径,在不同机器上可能无法复现。建议使用绝对路径或环境变量。
ValueError: The data of the instrument is not enough,通常是数据层的时间范围与模型训练范围不匹配,或 instruments 配置的股票池在指定区间内数据缺失。检查 start_time、end_time 与 fit_start_time、fit_end_time 是否合理。
复盘时,建议按“数据—模型—策略—回测”的顺序逐层检查:先确认数据层输出的特征与标签无缺失、无泄漏;再确认模型层训练损失收敛且预测分数分布合理;然后确认策略层持仓数量与换手率符合预期;最后确认回测层的成本参数与基准一致。只有每一层都正确,整体流程才能产出可信的量化预测结果。