1. 课程导入
1.1 量化预测的基本概念
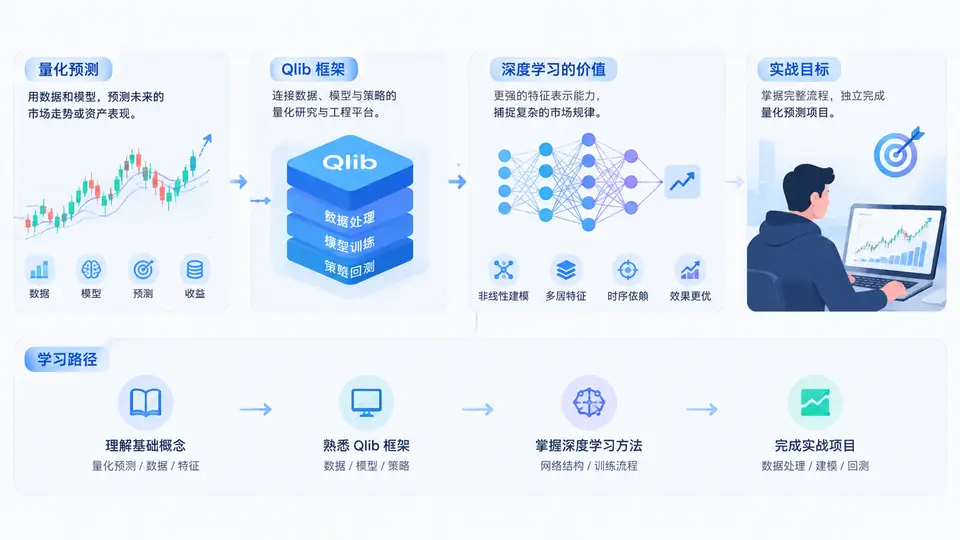
量化预测,是指用可计算、可复现的方式,从历史市场数据中提取规律,并对未来收益、风险或价格方向做出概率性判断。它不等同于“预测明天涨跌”这种单点猜测,而是建立一套数据—特征—模型—信号—组合的闭环流程。在A股、或期货市场中,量化预测通常输出三类结果:收益率预测(如未来5日收益)、排序预测(如横截面打分)、风险预测(如波动率或回撤概率)。
与主观投资相比,量化预测的核心优势在于:可回测、可归因、可迭代。但它的边界也很明确:市场存在非平稳性、交易成本、冲击成本与制度变化,任何模型都只是对历史规律的条件性近似。因此,本课程强调“预测—评估—交易”一体化,而不是孤立追求IC或准确率。
1.2 Qlib框架定位:面向AI的量化研究基础设施
Qlib是微软开源的、面向人工智能的量化投资平台。它并非一个“策略黑箱”,而是一套覆盖数据管理、特征工程、模型训练、回测评估、在线服务的研究基础设施。其典型定位可以概括为:
- 数据层:统一管理日频/分钟频行情、财务数据与因子,支持高效二进制存储与增量更新。
- 学习层:内置LightGBM、LSTM、GRU、Transformer、TCN、GATs等模型,并支持自定义PyTorch模型。
- 工作流层:通过YAML配置驱动“数据准备—训练—回测—分析”全流程,降低实验管理成本。
- 评估层:提供IC、ICIR、Rank IC、年化收益、信息比率、最大回撤等标准指标。
对深度学习量化而言,Qlib最大的价值在于把“数据对齐、标签构造、滚动训练、回测撮合”这些脏活标准化,让研究者把精力集中在模型结构与特征表达上。
workflow_config_*.yaml命名,核心字段包括qlib_init、market、benchmark、handler、model、strategy。后续章节会逐项拆解。
1.3 深度学习在量化投资中的价值与边界
深度学习在量化中的价值,主要体现在对高维、非线性、时序依赖数据的建模能力。传统线性因子模型难以捕捉因子交互与 regime 切换,而LSTM、Transformer等结构可以自动学习时序表征;图神经网络还能建模股票间关联。但深度学习并非万能,量化场景有其特殊约束:
| 维度 | 传统机器学习 | 深度学习 | 量化场景关注点 |
|---|---|---|---|
| 特征工程 | 依赖人工因子 | 可端到端学习 | 可解释性与因子暴露 |
| 样本量 | 中等即可 | 通常需要更多样本 | 金融数据信噪比低 |
| 过拟合风险 | 相对可控 | 较高 | 滚动回测与正则化 |
| 训练成本 | 低 | 高 | 实验迭代效率 |
| 上线稳定性 | 较强 | 需监控漂移 | 实盘衰减与风控 |
因此,本课程不会把深度学习包装成“圣杯”,而是强调用正确的方法论驾驭它:先建立可靠的基线(如LightGBM+Alpha158),再引入深度模型做增量改进,并用严格的样本外回测验证。
1.4 课程学习路径与实战目标
本课程共30章,遵循“概念—数据—模型—回测—优化—实战”的递进路径。第1阶段打基础:理解量化预测与Qlib架构;第2阶段做数据与特征:掌握Alpha158/360、自定义因子与数据处理;第3阶段进入模型:从LightGBM到LSTM、Transformer、GATs;第4阶段做回测与评估:掌握TopkDropout、IC分析、风险归因;第5阶段做实战优化:滚动训练、超参搜索、模型集成与实盘模拟。
完成本课程后,你应能独立完成以下实战目标:
- 在Qlib中完成一份端到端量化研究流程:数据初始化、特征配置、模型训练、回测评估。
- 基于PyTorch实现一个自定义深度学习预测模型,并接入Qlib工作流。
- 读懂并修改workflow YAML配置,完成滚动训练与多模型对比。
- 对回测结果进行IC、分组收益、换手率与回撤分析,识别过拟合与数据泄露。
1.5 一个最小可运行示例:Qlib工作流初体验
为了让你对Qlib的工作方式有直观感受,下面给出一个典型的工作流配置片段。它定义了数据源、特征处理器、模型与回测策略。你不需要现在完全理解每个字段,后续章节会逐一展开。
qlib_init:
    provider_uri: "~/.qlib/qlib_data/cn_data"
    region: cn
market: &market csi300
benchmark: &benchmark SH000300
data_handler_config: &data_handler_config
    start_time: 2008-01-01
    end_time: 2020-08-01
    fit_start_time: 2008-01-01
    fit_end_time: 2014-12-31
    instruments: *market
task:
    model:
        class: LGBModel
        module_path: qlib.contrib.model.gbdt
        kwargs:
            loss: mse
            learning_rate: 0.05
            num_leaves: 64
    dataset:
        class: DatasetH
        module_path: qlib.data.dataset
        kwargs:
            handler:
                class: Alpha158
                module_path: qlib.contrib.data.handler
                kwargs: *data_handler_config
            segments:
                train: [2008-01-01, 2014-12-31]
                valid: [2015-01-01, 2016-12-31]
                test: [2017-01-01, 2020-08-01]
    record:
        - class: SignalRecord
          module_path: qlib.workflow.record_temp
这段配置体现了Qlib的核心设计哲学:用声明式配置描述实验,用模块化组件替换模型与数据。当你把LGBModel替换为LSTM或自定义PyTorch模型时,整个训练与回测流程仍然保持一致。这正是本课程能够高效推进深度学习实战的基础。