3. Qlib 数据层架构
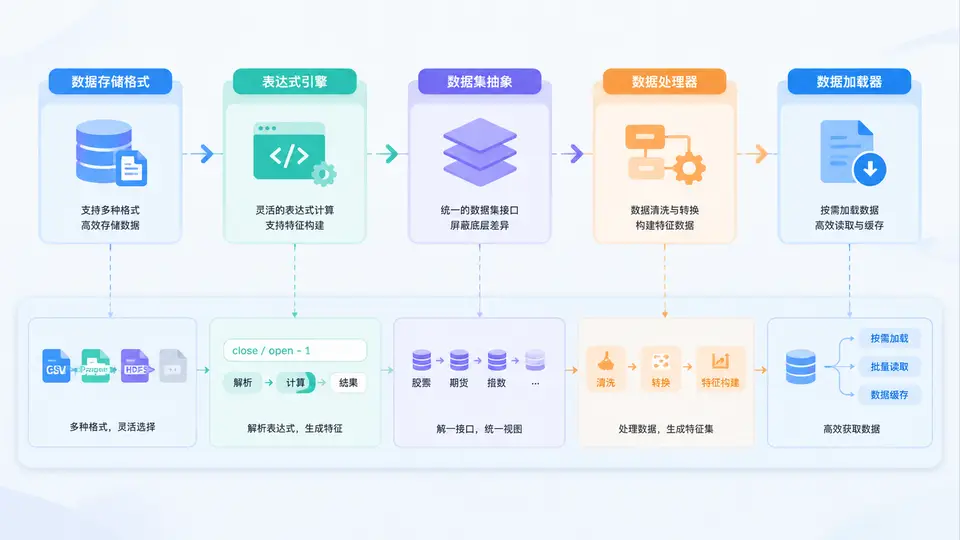
在 Qlib 中,数据层并不是一个简单的“读 CSV 文件”的模块,而是一套围绕高性能、可扩展、可复现目标设计的完整架构。它由五个核心组件构成:数据存储格式、表达式引擎、数据集抽象、数据处理器和数据加载器。理解它们各自的作用与协作关系,是后续做特征工程和模型训练的基础。
一、核心原理:五层职责与数据流
Qlib 数据层的设计遵循“存储与计算分离、表达式驱动、按需加载”的原则。五个组件在数据流中依次承担不同职责:
- 数据存储格式:决定原始数据如何落盘。Qlib 默认使用
.bin格式,按股票和字段分片存储,支持内存映射,读取速度远高于 CSV。 - 表达式引擎:用字符串表达式描述特征计算,如
Ref($close, 1)、Mean($volume, 5),由引擎解析并执行。 - 数据集抽象:定义“取哪些股票、哪些时间段、哪些字段”的逻辑视图,屏蔽底层存储细节。
- 数据处理器:对原始数据做归一化、缺失值填充、标签对齐等预处理,形成模型可用的样本。
- 数据加载器:按批次将处理后的数据送入模型训练或推理,控制内存与并行效率。
它们的关系可以概括为:存储格式是地基,表达式引擎是计算语言,数据集抽象是查询接口,数据处理器是加工流水线,数据加载器是最终出口。上层组件依赖下层,但下层不感知上层。
关键理解:Qlib 的数据层不是“先全部加载再计算”,而是“表达式定义计算,数据集圈定范围,处理器按需加工,加载器分批输出”。这种设计让 Qlib 能在单机上处理多年、数千只股票的高频数据。
二、方法流程:一次特征请求的完整路径
假设我们要训练一个模型,使用 $close 的 5 日均线和 $volume 的 10 日均量作为特征。整个流程如下:
- 定义表达式:在配置中写入
Mean($close, 5)和Mean($volume, 10)。 - 数据集抽象:通过
Dataset或DataHandler指定股票池、时间范围和字段列表。 - 表达式引擎解析:将表达式字符串解析为抽象语法树,识别
Mean算子、$close字段和窗口参数。 - 存储层读取:根据字段名和股票代码,从
.bin文件中按时间切片读取原始数据。 - 数据处理器加工:执行窗口计算、归一化、缺失值处理,生成特征矩阵和标签。
- 数据加载器输出:按
batch_size和shuffle策略,将数据分批送入模型。
下面是一个典型的 Qlib 初始化与数据加载配置示例:
import qlib
from qlib.data import D

qlib.init(provider_uri="~/.qlib/qlib_data/cn_data", region="cn")

# 通过表达式引擎获取特征
features = D.features(
    instruments=["SH600000", "SH600519"],
    fields=["Mean($close, 5)", "Mean($volume, 10)"],
    start_time="2020-01-01",
    end_time="2020-12-31"
)
print(features.head())
这段代码背后,D.features 会依次触发数据集抽象、表达式解析、存储读取和处理器计算。开发者只需关注表达式和范围,无需关心底层文件格式。
三、案例场景:从原始数据到训练样本
以 Alpha158 数据集为例,它预定义了 158 个特征表达式,覆盖动量、波动率、成交量等维度。其工作流程是:
| 阶段 | 组件 | 输入 | 输出 |
|---|---|---|---|
| 存储 | .bin 文件 | 原始行情数据 | 按股票/字段分片 |
| 表达式 | Expression Engine | 特征表达式字符串 | 计算指令树 |
| 数据集 | Dataset / DataHandler | 股票池、时间范围 | 逻辑数据视图 |
| 处理器 | Processor | 原始特征值 | 归一化/对齐后的样本 |
| 加载器 | DataLoader | 处理后的样本 | 批次张量 |
在实际训练中,DataHandler 负责“取数+算特征”,Processor 负责“清洗+对齐”,DataLoader 负责“分批+打乱”。三者串联后,模型才能稳定地消费数据。
四、误区与复盘:常见理解偏差
误区一:把表达式引擎当成普通函数调用。 表达式引擎支持算子组合、窗口计算和跨字段引用,但并非所有 Python 函数都能直接写入表达式。自定义算子需要注册后才能使用。
误区二:认为数据集抽象就是“读文件”。 数据集抽象的核心是“逻辑视图”,它决定取哪些数据、如何对齐时间索引,而不是直接操作文件。存储格式的变更不应影响上层数据集定义。
误区三:忽略处理器与加载器的顺序。 处理器必须在加载器之前完成归一化和标签对齐,否则加载器输出的批次会包含未处理数据,导致训练不稳定。
复盘建议: 调试数据层问题时,按“存储→表达式→数据集→处理器→加载器”的顺序逐层排查。先用 D.features 验证表达式结果,再检查 DataHandler 的配置,最后确认 DataLoader 的批次形状和标签对齐。