1. 课程导入
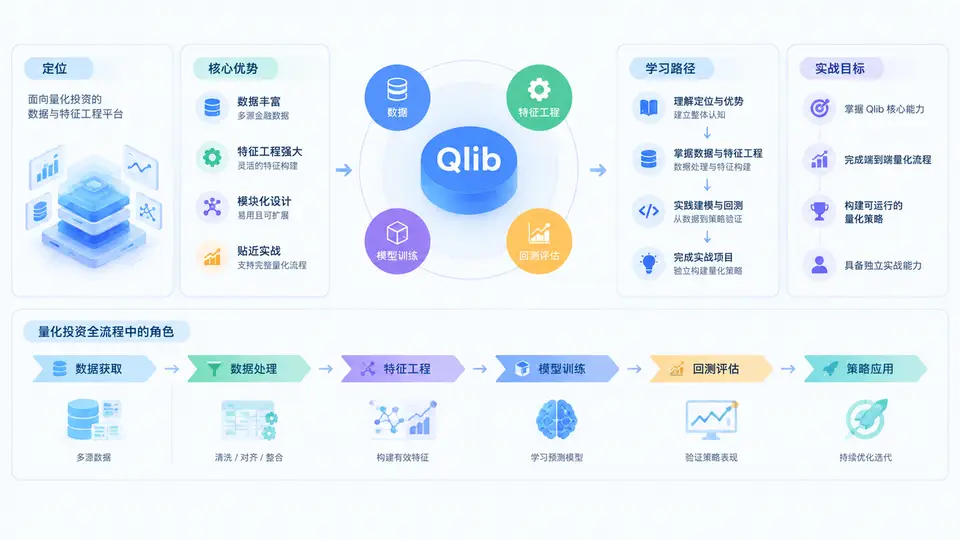
欢迎进入《Qlib数据与特征工程实战》。在动手写第一行数据处理代码之前,我们需要先建立一张清晰的“地图”:Qlib 到底是什么、它解决量化投资中的哪些问题、它在整个量化流程中处于什么位置,以及我们这门课最终要达成什么目标。只有把定位想清楚,后面的数据加载、特征计算、标签构造和数据集切分才不会变成零散的知识点。
一、Qlib 的定位:面向 AI 的量化投资框架
Qlib 是微软开源的、面向人工智能的量化投资平台。它的核心定位不是“一个回测工具”,也不是“一个数据下载脚本”,而是一套覆盖数据管理、特征工程、模型训练、组合构建与回测评估的端到端框架。它试图回答一个量化研究中的关键问题:如何把原始市场数据,稳定、可复现地转化为可供机器学习模型使用的监督学习数据集,并进一步完成预测与策略评估。
从工程视角看,Qlib 提供了三层能力:
- 数据层:统一的数据存储格式与表达式引擎,支持高效读取、缓存和增量更新。
- 特征层:通过表达式(Expression)和处理器(Processor)定义因子、标签与数据变换。
- 模型与策略层:内置多种模型接口、工作流(Workflow)和回测组件,支持从研究到评估的闭环。
因此,Qlib 在量化投资全流程中的角色可以概括为:它是连接“原始数据”与“AI 模型”的基础设施。没有它,研究者往往需要自己维护数据表、处理停牌与复权、对齐时间索引、防止未来函数;有了它,这些重复且易错的工程工作被标准化,研究者可以把精力集中在因子逻辑和模型设计上。
二、核心优势:为什么选择 Qlib 做特征工程
量化特征工程最大的痛点不是“算不出来”,而是“算得对、算得快、算得可复现”。Qlib 的优势正围绕这三点展开。
| 能力维度 | 传统做法 | Qlib 的做法 | 实际收益 |
|---|---|---|---|
| 数据存储 | CSV/数据库逐表读取 | 统一二进制格式 + 表达式引擎 | 读取更快,内存占用更可控 |
| 特征定义 | 手写 Pandas 代码 | 表达式 + 处理器配置 | 逻辑清晰,易于复用与版本管理 |
| 时间对齐 | 人工 shift、merge | 内置时间索引与标签构造机制 | 降低未来函数与错位风险 |
| 数据集切分 | 手动划分训练/验证/测试 | 基于时间段的 Dataset 配置 | 避免随机切分导致的数据泄漏 |
| 可复现性 | 依赖脚本与中间文件 | 配置驱动的工作流 | 实验可追踪、可重跑 |
其中,表达式引擎是 Qlib 数据与特征工程中最具代表性的设计。它允许你用类似公式的方式描述因子,例如“收盘价除以五日均价”,而不必逐行编写循环。表达式会被解析、计算并缓存,从而在多次实验中复用中间结果。
# 一个典型的 Qlib 表达式示例(概念示意)
# 收盘价相对5日均价的偏离
$close / Mean($close, 5) - 1

# 成交量加权均价与收盘价的关系
$vwap / $close - 1
这类表达式看起来简单,但背后涉及时间窗口、缺失值处理、股票池过滤和计算顺序。理解这些机制,正是本课程的重点之一。
三、量化投资全流程中的位置
为了更直观地理解 Qlib 的位置,我们可以把量化研究流程拆成六个阶段:
- 数据获取与清洗:行情、财务、基本面等原始数据进入系统。
- 特征工程:构造因子、标签,处理缺失值与标准化。
- 数据集构建:按时间切分训练集、验证集、测试集。
- 模型训练:使用机器学习或深度学习模型进行收益预测。
- 组合构建:根据预测分数生成持仓权重。
- 回测与评估:计算收益、风险与换手率等指标。
Qlib 覆盖了第 1 到第 6 阶段的工程支撑,但本课程集中火力在第 2 和第 3 阶段。原因很简单:特征和数据集的质量,直接决定模型效果的上限。如果标签构造错误、时间对齐错位、股票池包含未来信息,再复杂的模型也只会得到虚假的漂亮回测。
四、学习路径与实战目标
本课程共 30 章,整体遵循“先数据、后特征、再数据集、最后实战复盘”的路径。第 1 章建立全局认知,后续章节会逐步深入数据格式、表达式、处理器、标签构造、数据集切分和特征评估。
学习路径可以概括为四个台阶:
- 台阶一:理解数据底座。掌握 Qlib 的数据目录结构、二进制格式和初始化方式。
- 台阶二:掌握表达式与处理器。能够独立定义因子、标签和预处理流程。
- 台阶三:构建规范数据集。能够按时间切分数据,配置训练、验证和测试集。
- 台阶四:实战与复盘。能够完成一个完整的特征工程案例,并识别常见错误。
实战目标不是“记住多少 API”,而是形成三种能力:第一,看到一段因子逻辑,能判断它是否引入了未来信息;第二,拿到一份新数据,能设计出可复现的特征工程流程;第三,跑完一次实验后,能通过数据诊断定位问题,而不是盲目调参。
接下来,我们将从 Qlib 的数据初始化与目录结构开始,逐步进入真正的数据与特征工程实战。请带着一个问题进入后续学习:我构造的每一个特征,在真实交易时点是否真的可得?这个问题会贯穿整个课程。