3. 强化学习核心概念
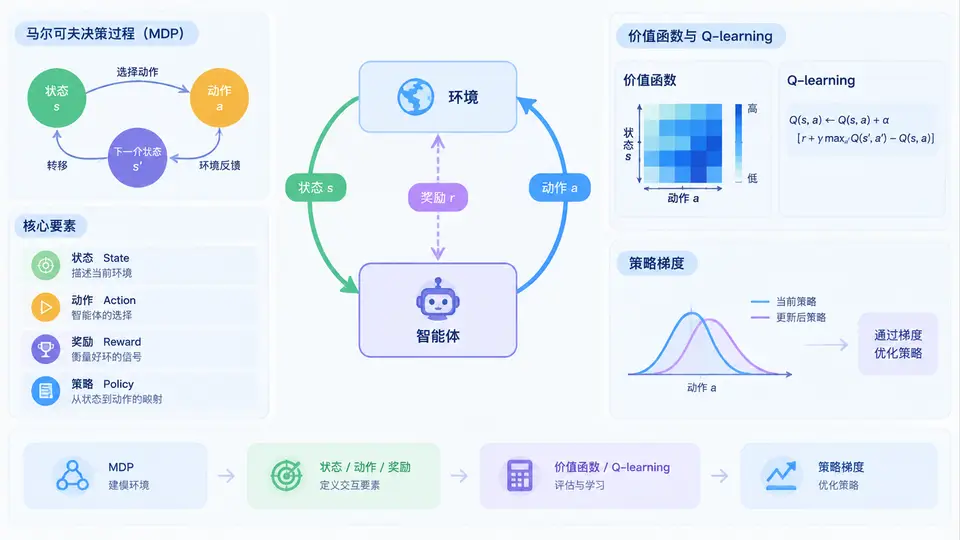
在订单执行场景中,我们面对的不是一次性决策,而是一连串随时间推进的决策:每一分钟、每一笔成交、每一次挂单撤单,都会改变剩余库存、市场状态和后续可选动作。强化学习(Reinforcement Learning, RL)正是为这类序贯决策问题设计的框架。理解RL的核心概念,是后续把订单执行建模为可训练智能体的前提。
一、核心原理:马尔可夫决策过程(MDP)
强化学习的问题通常被形式化为马尔可夫决策过程,用五元组表示:(S, A, P, R, γ)。其中:
- S(状态空间):智能体观察到的环境信息,例如剩余库存、剩余时间、当前盘口价差、成交量、波动率等。
- A(动作空间):智能体可执行的操作,例如“买入/卖出多少股”“挂限价单还是市价单”“是否等待”。
- P(状态转移概率):执行动作后,环境从当前状态转移到下一状态的概率分布。在订单执行中,它由市场微观结构决定,通常未知。
- R(奖励函数):即时反馈,例如成交价与基准价的偏差、冲击成本、未完成惩罚等。
- γ(折扣因子):衡量未来奖励的重要性,取值0到1之间。
“马尔可夫”意味着:下一状态只依赖当前状态和当前动作,与更早的历史无关。这个假设让问题可解,但在真实市场中需要谨慎设计状态,使关键信息被包含进来。
状态:剩余库存比例、剩余时间比例、当前价差、近期成交量、波动率;
动作:市价卖出、限价卖出、继续等待;
奖励:成交价格相对到达价的改善减去冲击成本与未完成惩罚。
二、策略、价值函数与Q-learning
策略(Policy)是智能体的行为规则,记为 π(a|s),表示在状态s下选择动作a的概率。策略可以是确定性的,也可以是随机性的。强化学习的目标就是找到最优策略,使长期累积奖励最大。
为了评价策略好坏,引入两个价值函数:
- 状态价值函数 Vπ(s):从状态s出发,按策略π行动所能获得的期望回报。
- 动作价值函数 Qπ(s,a):在状态s先执行动作a,再按策略π行动所能获得的期望回报。
Q-learning是一种经典的值方法,它直接学习最优动作价值函数 Q*(s,a),并利用贝尔曼最优方程迭代更新:
Q(s,a) ← Q(s,a) + α [ r + γ · max Q(s',a') − Q(s,a) ]
                              a'
其中α是学习率。Q-learning属于离线策略(off-policy)方法:它可以使用探索性行为产生的数据,却学习贪婪策略对应的价值。在订单执行中,这意味着我们可以用历史成交或模拟撮合数据来训练,而不必完全依赖在线试错。
三、策略梯度简介
与Q-learning学习价值再间接导出策略不同,策略梯度(Policy Gradient)直接对策略参数θ进行优化,目标是最大化期望回报 J(θ)。其核心思想是:让带来高回报的动作概率上升,让低回报动作概率下降。
最基础的REINFORCE算法更新形式为:
θ ← θ + α · ∇θ log πθ(a|s) · G
其中G是从当前时刻起的累积回报。策略梯度天然适合连续动作空间,例如直接输出“卖出比例”或“挂单价格偏移量”,这在订单执行中非常实用。它的缺点是方差较大,因此常引入基线(baseline)或Actor-Critic结构来稳定训练。
| 对比维度 | Q-learning / 值方法 | 策略梯度 / 策略方法 |
|---|---|---|
| 学习对象 | 动作价值函数Q(s,a) | 策略参数πθ(a|s) |
| 动作空间 | 适合离散、有限动作 | 适合连续、高维动作 |
| 策略类型 | 通常为确定性贪婪策略 | 天然随机策略 |
| 订单执行适用性 | 离散动作选择,如买/卖/等 | 连续执行比例、价格偏移 |
| 典型问题 | 连续动作难以直接处理 | 方差大、收敛慢 |
四、案例场景:把订单执行写成RL问题
假设我们需要在30分钟内卖出10万股某股票。可以这样建模:
- 状态:剩余库存比例、剩余时间比例、当前买卖价差、过去1分钟成交量、短期波动率。
- 动作:市价卖出、限价卖出(可设不同价格档位)、等待。
- 奖励:每步成交带来的价格改善,减去冲击成本,再减去期末未完成库存的惩罚。
- 策略:在库存高、时间充裕时偏向限价单;在库存高、时间紧迫时偏向市价单。
训练完成后,智能体应学会在“等待更好价格”和“避免未完成风险”之间权衡。这正是强化学习相对于静态规则的优势:它能根据状态动态调整行为。
五、常见误区与复盘
误区2:奖励函数与业务目标不一致。只奖励成交价改善,可能导致大量未完成库存;只惩罚未完成,又可能过度激进交易。
误区3:忽视模拟环境与真实市场的差异。在回测中表现好的策略,可能因滑点、延迟、部分成交而在实盘失效。
误区4:把Q-learning直接用于连续动作。连续动作空间下max操作不可行,应改用策略梯度或Actor-Critic方法。
复盘时建议检查三点:状态是否满足马尔可夫性、奖励是否真正反映执行目标、训练数据是否覆盖了不同市场状态。只有这三者对齐,强化学习智能体才能在订单执行中稳定发挥作用。