1. 课程导入
1.1 订单执行问题的定义
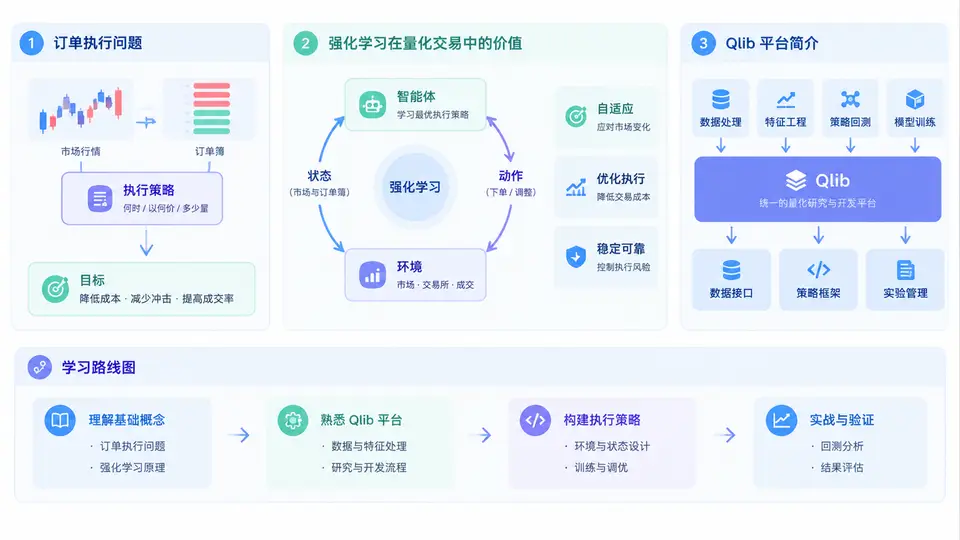
在量化交易中,订单执行是指将投资决策转化为实际成交的过程。假设某只股票当前价格为10.00元,你计划买入100万股,如果直接以市价单一次性提交,可能会因为冲击成本将成交均价推高到10.05元甚至更高;如果拆分成小单慢慢买入,又可能面临价格反向波动、未完成建仓的风险。订单执行要解决的核心问题就是:在给定时间窗口内,如何以尽可能低的成本、尽可能小的风险完成指定数量的买卖。
订单执行问题通常包含以下要素:
- 目标数量:需要买入或卖出的总股数,例如50万股。
- 时间约束:必须在某个时间段内完成,例如当日收盘前或未来30分钟。
- 市场环境:包括买卖价差、成交量、波动率、流动性等。
- 成本与风险:冲击成本、机会成本、价格波动风险、未成交风险。
传统方法如TWAP(时间加权平均价格)和VWAP(成交量加权平均价格)将订单均匀拆分,逻辑简单但缺乏对市场状态的动态适应。当市场波动加剧或流动性骤降时,固定节奏的执行策略往往表现不佳。
1.2 强化学习在量化交易中的价值
强化学习(Reinforcement Learning, RL)通过智能体与环境的持续交互来学习最优决策策略。在订单执行场景中,智能体每一步决定“买多少、卖多少、是否等待”,环境返回市场状态和成本反馈,智能体根据奖励信号不断优化策略。
与规则型执行算法相比,强化学习的优势体现在三个方面:
- 动态适应:策略可以根据实时市场状态调整执行节奏,而不是固定拆分。
- 目标可定制:奖励函数可以同时纳入冲击成本、机会成本和风险惩罚。
- 长期优化:RL天然适合序贯决策,能够权衡“当前多买”与“未来可能更便宜”之间的关系。
核心洞察:订单执行不是单步优化问题,而是典型的序贯决策问题。每一步的执行量都会影响剩余库存、市场冲击和后续可用流动性。这正是强化学习擅长处理的场景。
下面是一个简化的RL交互循环示意:
状态 s_t:当前价格、剩余库存、剩余时间、成交量、价差
动作 a_t:本步执行比例(如 0%、10%、30%、50%)
奖励 r_t:负的冲击成本 - 机会成本 - 风险惩罚
转移:s_{t+1} = 环境(s_t, a_t)
目标:最大化累计奖励 E[Σ r_t]
1.3 Qlib平台简介与课程学习路线图
Qlib是微软开源的AI量化投资平台,提供数据管理、因子计算、模型训练、回测和策略执行等完整工具链。对于强化学习订单执行,Qlib的优势在于:
- 统一数据接口:内置A股、等行情数据,支持高频和日频数据。
- 强化学习框架集成:提供环境封装、状态设计、奖励计算和训练循环的扩展点。
- 回测与评估:支持订单执行模拟,能够计算冲击成本、滑点和执行偏差。
- 可复现性:配置化实验管理,便于对比不同策略。
本课程共30章,围绕“订单执行”这一核心任务,从问题定义、环境搭建、策略设计到实战调优逐步展开。学习路线图如下表所示:
| 阶段 | 章节范围 | 核心内容 | 产出目标 |
|---|---|---|---|
| 基础导入 | 第1-4章 | 订单执行定义、RL基础、Qlib环境配置、数据准备 | 理解问题并跑通数据管道 |
| 环境与建模 | 第5-12章 | 状态设计、动作空间、奖励函数、市场模拟器 | 构建可训练的RL执行环境 |
| 算法与训练 | 第13-22章 | DQN、PPO、SAC等算法实现与调参 | 训练出稳定执行策略 |
| 评估与实战 | 第23-30章 | 回测评估、成本分析、实盘对接、策略迭代 | 完成端到端订单执行系统 |
1.4 案例场景与常见误区
案例场景:假设你需要在一个交易日内买入某只流动性中等的股票100万股。开盘后价格快速上涨,成交量放大;午盘后价格回落,流动性减弱。TWAP策略可能在早盘高位买入过多,而RL策略可以根据价差和成交量动态调整:早盘放慢节奏,午盘流动性恢复时加大执行比例。
常见误区:
- 误区一:把订单执行当成预测问题。执行策略的目标不是预测价格方向,而是在不确定环境中控制成本和风险。
- 误区二:奖励函数只考虑冲击成本。忽略机会成本和未成交风险,可能导致策略过度等待。
- 误区三:用历史回测直接判断策略优劣。订单执行对市场微观结构敏感,回测需考虑滑点、延迟和部分成交。
- 误区四:状态设计过于简单。仅用价格和剩余库存可能不足以刻画市场流动性变化。
复盘提醒:在课程初期就应建立“成本-风险-完成率”三角平衡的意识。任何只追求单一指标的执行策略,在真实市场中都可能失效。
为了更直观地理解订单执行中的核心权衡,下面用一张图展示“执行速度”与“成本风险”之间的关系:
这张图说明:执行过快会推高冲击成本,执行过慢会放大机会成本和未成交风险。强化学习的目标,就是学习一个能够根据市场状态动态调整执行速度的策略,使综合成本最小化。
本章作为课程导入,已经明确了订单执行问题的定义、强化学习的价值、Qlib平台的作用以及整体学习路线。接下来,课程将进入环境配置与数据准备阶段,为后续的RL建模打下工程基础。