3. 量化投资中的集成学习
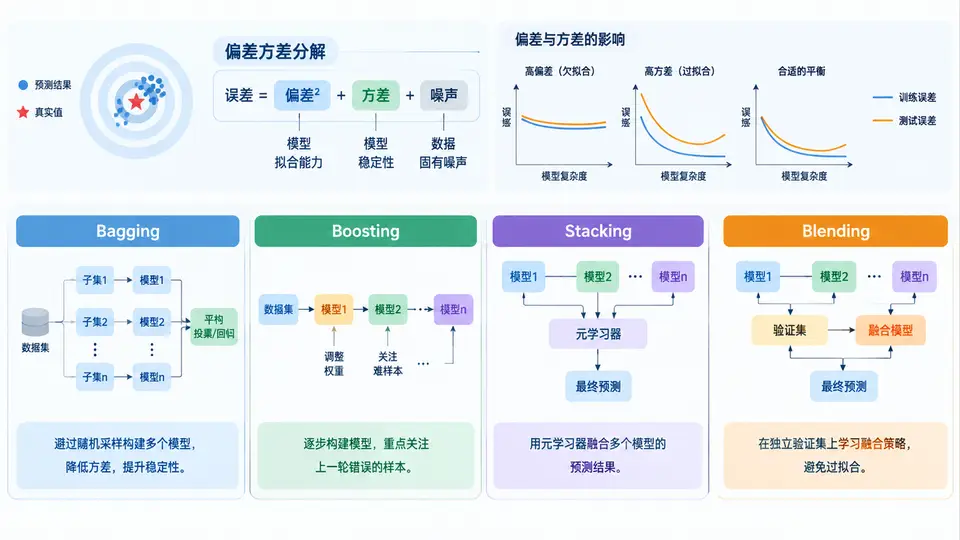
在量化投资中,单一模型往往难以同时兼顾稳定性与收益性。无论是线性回归、梯度提升树,还是LSTM、Transformer,都会受到数据噪声、市场结构变化和参数选择的影响。集成学习的核心价值,在于通过组合多个基学习器,降低整体预测的偏差与方差,从而提升信号在样本外阶段的稳健性。理解偏差—方差分解,是理解所有集成方法的起点。
一、核心原理:偏差方差分解
对于一个预测模型,其期望泛化误差可以分解为三部分:偏差、方差与不可约噪声。用公式表达为:
E[(y - f_hat(x))^2] = Bias(f_hat(x))^2 + Var(f_hat(x)) + sigma^2其中,偏差衡量模型预测均值与真实值之间的系统性偏离,方差衡量模型在不同训练集上的预测波动,噪声则是数据本身不可消除的部分。量化投资中,偏差通常来自模型假设过强,例如用线性模型拟合非线性因子关系;方差则来自模型对训练数据过度敏感,例如深度树模型在噪声较大的行情中频繁切换信号。
集成学习的基本思路,就是通过构造并组合多个基学习器,在偏差与方差之间寻找更优平衡。Bagging倾向于降低方差,Boosting倾向于降低偏差,Stacking与Blending则通过元学习器进一步修正组合权重。
二、方法流程:从Bagging到Blending
Bagging(Bootstrap Aggregating)通过对训练集进行有放回抽样,训练多个同质基模型,再通过投票或平均得到最终预测。随机森林是典型代表。其流程为:
- 从原始训练集中有放回抽取N个Bootstrap样本;
- 在每个样本上训练一个基学习器;
- 对回归任务取均值,对分类任务取投票;
- 输出集成预测结果。
Bagging对高方差、低偏差的模型效果显著,例如深决策树。但在量化中,若基模型本身偏差较高,Bagging的改善有限。
Boosting则采用串行训练方式,每个新模型重点拟合前序模型的残差或错误样本。AdaBoost、GBDT、XGBoost、LightGBM都属于这一家族。其核心流程是:
- 初始化基学习器;
- 计算当前模型的预测残差;
- 训练新模型拟合残差;
- 按学习率累加模型输出;
- 重复直到达到迭代次数或早停条件。
Boosting通常能显著降低偏差,但若迭代过多或学习率过高,容易过拟合噪声,尤其在金融数据信噪比低的环境下需要严格正则化。
Stacking使用多层模型结构:第一层是多个异质基学习器,第二层是元学习器,用于学习如何组合第一层输出。其关键点是使用交叉验证生成元特征,避免信息泄露。典型流程如下:
# 伪代码示意
base_models = [LinearRegression(), RandomForest(), XGBoost(), LSTM()]
meta_model = Ridge()

for each fold in KFold:
    train base_models on train_fold
    predict on valid_fold -> meta_features
train meta_model on meta_features
final_prediction = meta_model.predict(base_models_predictions)Blending与Stacking类似,但不使用交叉验证,而是直接留出验证集生成元特征。其实现更简单,但容易因验证集划分不当导致过拟合。
三、案例/场景:多因子选股中的集成应用
假设我们构建一个月度换仓的多因子选股模型,因子包括估值、动量、质量、波动率等。单一XGBoost模型在2018年、2022年等风格切换期容易出现较大回撤。此时可以采用Stacking集成:
| 层级 | 模型 | 作用 | 输出 |
|---|---|---|---|
| 第一层 | 线性回归 | 捕捉线性因子暴露 | 预测收益 |
| 第一层 | 随机森林 | 捕捉非线性交互 | 预测收益 |
| 第一层 | LightGBM | 处理缺失值与类别特征 | 预测收益 |
| 第二层 | Ridge回归 | 学习最优组合权重 | 最终信号 |
通过交叉验证生成元特征后,Ridge元学习器会自动给不同市场状态下表现更稳的基模型更高权重。回测中,Stacking组合的IC_IR通常高于单一模型,最大回撤也有所降低。但需注意,元学习器本身也可能过拟合,因此要控制其复杂度,并保留足够长的验证窗口。
四、误区/复盘:集成不是万能药
复盘时建议关注三点:第一,基模型之间的相关性是否足够低;第二,元学习器是否使用了严格的时序交叉验证;第三,集成后的信号换手率是否在可接受范围内。只有将统计学习原理与交易约束结合,集成学习才能真正服务于量化投资。
qlib.contrib.model下的GBDT、Linear、MLP等模型分别训练,再通过自定义Workflow将预测结果拼接为元特征,最后用Ridge或LightGBM进行Stacking融合。务必使用RollingGen或SlidingWindow划分时序数据,避免未来函数。