1. 课程导入
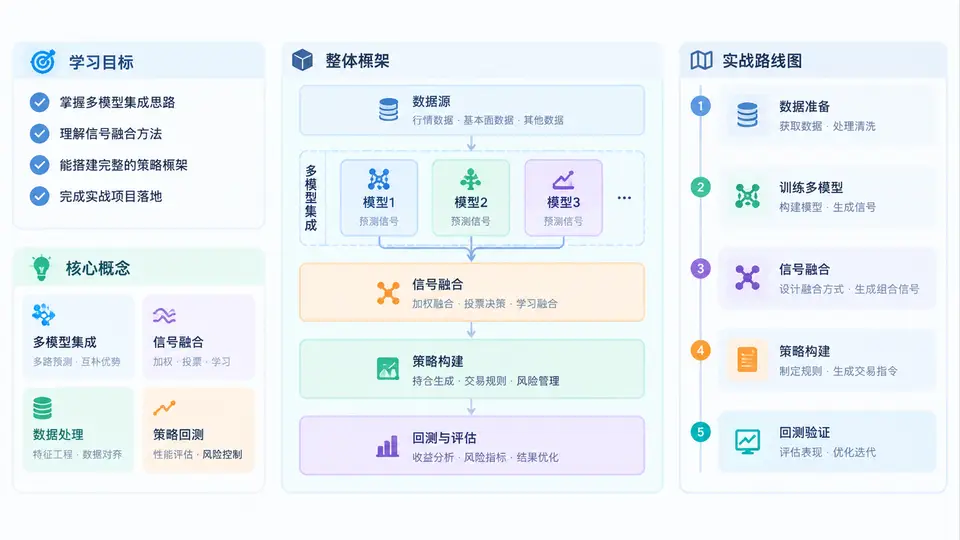
在量化投资的研究与工程实践中,单一模型往往难以稳定穿越不同的市场状态。趋势模型在震荡市回撤明显,均值回归模型在单边行情中容易逆势,机器学习模型在样本外也可能因风格切换而失效。Qlib 作为面向量化投研全流程的开源平台,提供了从数据管理、特征工程、模型训练到回测评估的完整能力。本课程的目标,是帮助你在 Qlib 之上建立一套可复现、可扩展的多模型集成与信号融合体系,把多个弱相关甚至互补的预测信号,转化为更稳健的组合决策。
学习目标
完成本章后,你应当能够清晰回答三个问题:为什么要做集成、集成什么、以及如何在 Qlib 中落地。具体目标包括:
- 理解多模型集成的核心动机:偏差-方差分解、模型多样性来源、以及信号融合对回撤与换手的影响。
- 掌握 Qlib 中模型训练、预测输出与信号拼接的标准接口,能够把多个模型的预测分数对齐到统一的时间与标的索引。
- 区分“模型集成”与“信号融合”的层次差异:前者发生在预测分数层,后者可延伸到仓位、风险与交易约束层。
- 建立从实验设计、滚动训练、权重确定到回测归因的完整实战路线图。
核心概念:集成、融合与多样性
多模型集成并不是简单地把几个模型的预测结果相加。它的有效性建立在“误差不完全相关”这一前提上。如果两个模型在同一批样本上犯同样的错误,集成收益几乎为零。因此,多样性的来源决定了集成的上限。常见多样性来源包括:
| 多样性来源 | 典型做法 | 在 Qlib 中的体现 |
|---|---|---|
| 数据视角 | 不同特征集、不同频率、不同股票池 | 配置不同 handler 与 dataset |
| 模型结构 | 线性、树模型、深度网络、时序模型 | 切换 model 配置并分别训练 |
| 目标定义 | 不同预测周期、不同标签构造 | 修改 label 与数据切分 |
| 训练随机性 | 不同随机种子、不同采样 | 多次运行并保存预测 |
信号融合则更接近决策层。它关注的是:多个预测分数如何映射为最终持仓。常见方法包括等权平均、基于历史 IC 或 ICIR 的加权、滚动窗口最优权重、以及带风险约束的优化融合。融合层需要特别警惕过拟合,因为权重估计本身也是在小样本上进行的。
关键判断:集成提升的是稳定性,而不是必然提升收益。若单模型已经过拟合,集成只会把过拟合“平均化”。因此,集成前必须确保每个基模型都经过严格的样本外验证。
整体框架与实战路线图
本课程的整体框架可以概括为“数据—模型—信号—组合—归因”五层。Qlib 在其中承担数据与模型训练的基础设施角色,而集成与融合逻辑则由我们在其之上构建。实战路线图如下:
- 环境与数据准备:初始化 Qlib,准备统一日历、标的池与特征数据,确保所有模型共享同一数据切分。
- 基模型训练:选择 3~5 个差异明显的模型,分别训练并保存验证集与测试集预测。
- 预测对齐:把各模型预测统一为 (datetime, instrument) 索引的分数矩阵,处理缺失与异常值。
- 权重确定:在滚动窗口内用 IC、ICIR 或简单等权确定融合权重,避免使用未来信息。
- 信号融合与回测:将融合分数输入策略,生成持仓并回测,对比单模型基线。
- 归因与复盘:分析收益来源、换手、回撤与风格暴露,判断集成是否真正带来增益。
在 Qlib 中,模型预测通常以 DataFrame 形式返回,索引为 datetime 与 instrument。对齐是集成中最容易出错的环节。下面是一个典型的预测对齐与等权融合片段:
import pandas as pd

# 假设 pred_a, pred_b, pred_c 均为 Qlib 预测结果
# index: (datetime, instrument), columns: score
preds = [pred_a, pred_b, pred_c]

# 对齐索引并合并
aligned = pd.concat(preds, axis=1, keys=["a", "b", "c"])
aligned = aligned.dropna(how="all")

# 等权融合
aligned["ensemble"] = aligned[["a", "b", "c"]].mean(axis=1)

# 检查覆盖率
print(aligned.notna().mean())
建议在融合前先做横截面标准化(如按日 rank 或 z-score),否则不同模型的分数尺度差异会主导等权结果。
案例场景:从单模型到三模型融合
假设你已有三个基模型:LightGBM 使用量价特征,Linear 使用基本面特征,GRU 使用时序窗口特征。单独回测显示:LightGBM 收益高但回撤大,Linear 稳定但收益低,GRU 在趋势市表现好。直接等权融合后,常见结果是收益介于两者之间,但最大回撤显著下降,夏普比率提升。这正是集成追求的“风险调整后收益改善”。
但若三个模型都基于同一套量价特征,只是换了模型结构,融合效果往往有限。此时应优先增加数据视角的多样性,而不是继续堆叠模型。
常见误区与复盘要点
误区一:用测试集选择融合权重。这会造成信息泄露,回测结果虚高。权重必须在验证集或滚动窗口内确定。
误区二:忽略换手与交易成本。融合信号可能更平滑,也可能因模型切换而增加换手,必须纳入回测评估。
误区三:只比较收益,不比较风险。集成的价值常体现在回撤、波动与尾部风险上,应同时观察夏普、卡玛与最大回撤。
复盘时建议固定一张对照表:单模型基线、等权融合、加权融合三组结果并列,记录收益、波动、夏普、最大回撤与换手。只有融合组在多数指标上稳定优于基线,才认为集成有效。否则应回到多样性来源与权重方法上继续排查。
本章建立了整体认知框架。接下来你将逐步进入数据准备、基模型训练、预测对齐与融合权重的具体实现,最终形成一套可在 Qlib 中复用的多模型集成流水线。