1. 岗位能力画像与简历优化模板
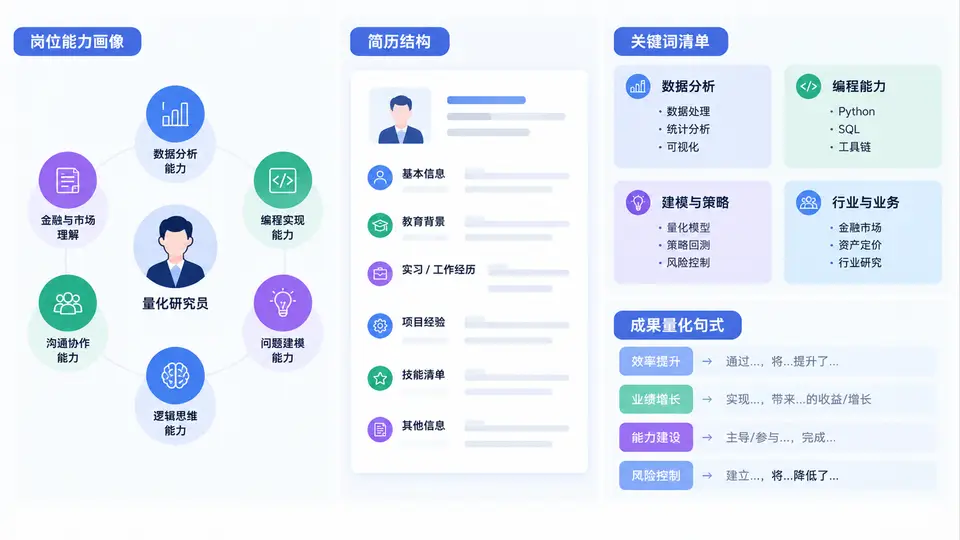
量化研究员面试的第一道门槛,往往不是现场答题,而是简历筛选。很多候选人技术功底不差,却因为简历没有对齐岗位能力画像,在初筛阶段就被淘汰。本章的核心任务是:把“我想展示什么”转换为“岗位需要什么”,再用可验证的成果句式把能力证据写清楚。你需要先建立能力画像,再重构简历结构,最后用关键词和量化句式完成表达闭环。
一、核心原理:能力画像决定简历结构
量化研究员的岗位能力画像,通常由五个维度构成:数理统计基础、编程与工程能力、策略研究能力、数据与市场理解、协作与表达。不同公司权重不同:高频机构更看重低延迟工程与微观结构,资管机构更看重因子逻辑与组合归因,私募更看重独立策略闭环。简历不是经历罗列,而是能力画像的证据映射。
这张图的关键不是五个词,而是中心节点:策略研究闭环。面试官最终判断的是你能否独立完成“提出假设—构造因子—回测验证—归因迭代—上线跟踪”的完整链路。简历中每一段经历,都应尽量指向这个闭环中的某个环节,并说明你的贡献边界。
二、方法流程:从画像到简历的四步法
- 拆解目标岗位JD:把JD中的动词和名词分类,例如“因子挖掘”“Python”“组合优化”“归因分析”,形成关键词清单。
- 建立个人能力证据表:每项能力对应一个项目、一个动作、一个结果,避免只有课程名称或工具名称。
- 重构简历结构:建议采用“教育背景—研究/实习经历—项目成果—技能证书”的顺序,研究经历放在最前。
- 用量化句式改写:把“负责因子研究”改为“独立构造12个量价因子,样本外IC均值0.045,多空组合年化夏普1.8”。
关键词清单不是堆砌,而是“岗位语言”的对齐。例如JD写“tick级数据”,简历就不要只写“高频数据”;JD写“组合归因”,简历就应出现“Brinson归因”或“风险暴露拆解”。
三、简历结构模板与关键词清单
| 模块 | 核心内容 | 关键词示例 | 量化句式 |
|---|---|---|---|
| 教育背景 | 学校、专业、GPA、相关课程 | 随机过程、时间序列、机器学习 | GPA 3.8/4.0,专业前5% |
| 研究经历 | 问题、方法、数据、结果 | 因子挖掘、回测、IC、夏普 | 构造8个因子,样本外IC 0.04,夏普1.6 |
| 工程项目 | 系统、工具、性能、协作 | Python、C++、SQL、Airflow | 回测框架提速3倍,支持日频万级标的 |
| 技能证书 | 语言、框架、数据库、竞赛 | Pandas、NumPy、Kaggle | Kaggle前5%,CFA一级 |
成果量化句式可以归纳为四类:效率类(提速、降本)、规模类(标的数、数据量)、质量类(IC、夏普、回撤)、影响类(上线、被采用、获奖)。写简历时优先使用“动作+对象+指标+对比”的结构。
差:负责多因子选股策略研究。
好:独立构建多因子选股模型,覆盖沪深300,样本外年化收益18%,最大回撤9%,夏普1.7。
差:使用Python处理数据。
好:用Python+Pandas清洗10年tick数据,将回测准备时间从6小时降至40分钟。
四、案例场景与常见误区复盘
场景:一位候选人有两段实习,一段做因子测试,一段做风险模型。原简历写成“参与因子测试和风险模型开发”,面试官无法判断能力深度。改写后:第一段写“独立测试12个量价因子,发现3个样本外失效并给出原因”,第二段写“基于Barra风险模型拆解组合暴露,将行业偏离控制在1%以内”。这样既体现独立研究能力,也体现风险意识。
常见误区有三类:一是把团队成果写成个人成果,面试追问时容易露馅;二是只写工具不写问题,例如“会用Python”没有信息量;三是指标没有口径,例如“收益很高”不如“年化18%,样本外”。复盘时逐条问自己:这个数字能否被验证?我的贡献边界是否清晰?