3. 遗传编程入门
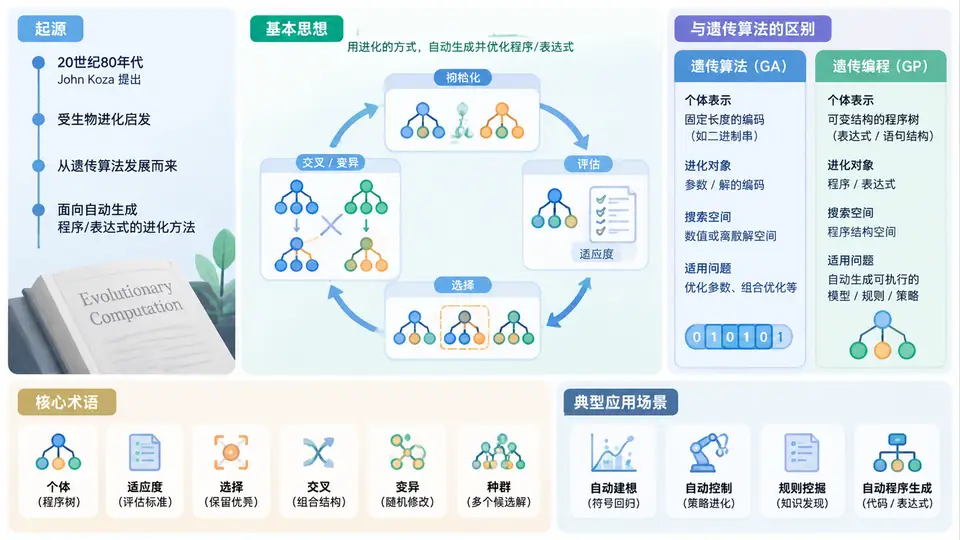
在进入 Alpha 因子挖掘之前,必须先理解遗传编程(Genetic Programming,GP)到底在“进化”什么。很多初学者会把遗传编程与遗传算法混为一谈,结果在后续设计因子表达式时,既说不清个体是什么,也说不清交叉和变异在操作什么。本节把概念边界一次讲清,并为后续实战打下术语基础。
一、起源与基本思想
遗传编程由 John Koza 在 20 世纪 90 年代初系统提出。它的思想源头来自遗传算法,但把“进化对象”从固定长度的染色体推进到了可执行程序。传统遗传算法通常优化一组参数或编码串;遗传编程则直接搜索程序结构本身,例如数学表达式、逻辑条件、树形计算流程。
其基本思想可以概括为:
- 用树形结构表示一个候选程序,叶节点是变量或常数,内部节点是运算符或函数;
- 随机生成一批初始程序,形成种群;
- 用适应度函数评价每个程序解决目标问题的好坏;
- 让适应度高的程序更大概率被选中,通过交叉、变异产生下一代;
- 重复多代,逐步逼近更优的程序结构。
在 Alpha 因子挖掘中,一个“程序”通常就是一个因子表达式,例如 (close - ts_mean(close, 20)) / ts_std(close, 20)。遗传编程要做的,不是手工写这个公式,而是让种群自动搜索出类似甚至更复杂的表达式。
核心转变:遗传算法进化的是“参数”,遗传编程进化的是“程序结构”。前者搜索空间是数值向量,后者搜索空间是表达式树。
二、与遗传算法的区别
两者共享选择、交叉、变异、种群迭代等机制,但表示方式和搜索空间差异很大。下表给出关键对比:
| 对比维度 | 遗传算法(GA) | 遗传编程(GP) |
|---|---|---|
| 个体表示 | 固定长度编码串,如二进制、实数向量 | 变长树形程序,如表达式树、语法树 |
| 搜索对象 | 参数组合或解向量 | 程序结构、运算符组合、变量选择 |
| 交叉方式 | 交换片段或混合数值 | 交换子树 |
| 变异方式 | 位翻转、数值扰动 | 替换子树、改变节点、插入新分支 |
| 典型输出 | 一组最优参数 | 一个可执行表达式或规则 |
| 因子挖掘中的角色 | 多用于参数调优、权重搜索 | 直接生成因子公式 |
理解这张表后,后续看到“种群”“个体”“树深度”“子树交叉”等术语时,就不会再与遗传算法混淆。
三、核心术语与运行流程
遗传编程有一套相对固定的术语体系。掌握它们,才能读懂后续代码和实验日志。
- 终端集(Terminal Set):叶节点集合,如
open、high、low、close、volume、常数。 - 函数集(Function Set):内部节点运算符,如
+、-、*、/、ts_mean、ts_std、rank、delay。 - 个体(Individual):一棵表达式树,代表一个候选因子。
- 种群(Population):多棵表达式树组成的集合。
- 适应度(Fitness):评价因子好坏的指标,如 IC、IR、夏普比率、换手率惩罚后的综合得分。
- 选择(Selection):按适应度挑选父代,常用锦标赛选择、轮盘赌选择。
- 交叉(Crossover):交换两个父代树的子树,生成新个体。
- 变异(Mutation):随机替换子树或节点,维持多样性。
- 精英保留(Elitism):将最优个体直接复制到下一代,防止退化。
典型运行流程如下:
- 定义终端集与函数集,确定表达式合法语法;
- 随机初始化种群,控制树深度和复杂度;
- 计算每个个体的因子值,并在训练集上评估适应度;
- 执行选择、交叉、变异,生成下一代;
- 保留精英个体,重复迭代直到达到代数或收敛条件;
- 输出最优因子表达式,并在验证集上复核稳健性。
# 伪代码:遗传编程主循环
population = init_population(size=500, max_depth=4)
for generation in range(30):
    fitness = evaluate(population, train_data)
    parents = select(population, fitness, method="tournament")
    offspring = crossover(parents, rate=0.8)
    offspring = mutate(offspring, rate=0.1)
    population = elitism(population, fitness, k=5) + offspring
best_factor = get_best(population, fitness)
print(best_factor.expression)
四、典型应用场景与常见误区
遗传编程并不只用于量化因子挖掘。它的典型应用包括:
- 符号回归:从数据中自动发现数学公式;
- 量化因子挖掘:自动生成 Alpha 表达式;
- 策略规则发现:进化买卖条件与风控规则;
- 特征工程:自动构造非线性组合特征;
- 调度与优化:进化启发式规则或决策树。
常见误区一:把遗传编程当成“万能公式生成器”。如果不限制函数集和树深度,搜索空间会爆炸,且极易过拟合。
常见误区二:只看训练集适应度,不做样本外验证。遗传编程擅长拟合噪声,必须配合滚动窗口、交叉验证和复杂度惩罚。
常见误区三:忽略因子经济含义。纯数学上优秀的表达式,可能对应极高换手率或不可交易逻辑,实盘表现会大幅衰减。
复盘建议:每次运行后记录种群多样性、最优树深度、适应度曲线和样本外 IC。若训练集适应度持续上升而验证集下降,应优先降低树深度、收紧函数集或增加正则惩罚,而不是继续增加代数。