1. 课程导入
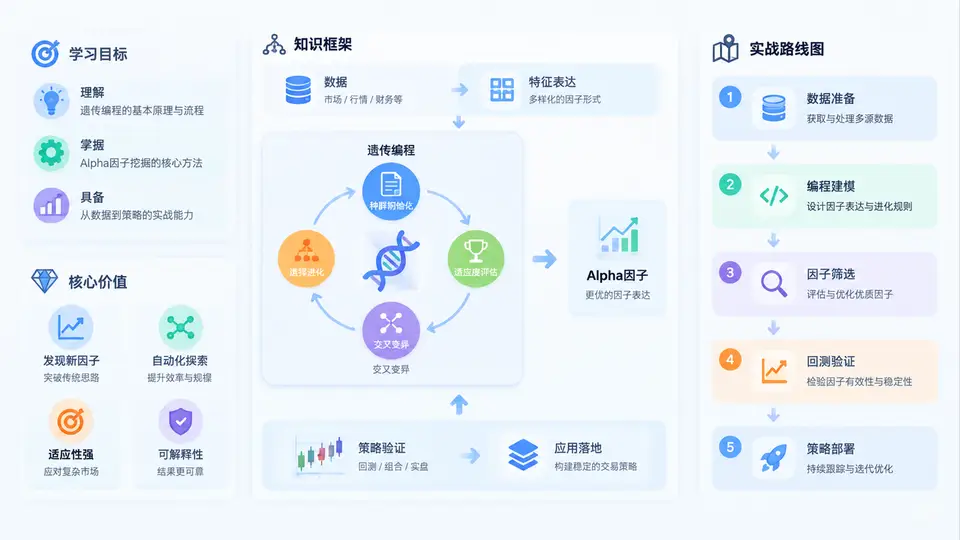
欢迎进入《遗传编程Alpha因子挖掘实战》。在量化投资领域,Alpha因子的挖掘能力直接决定了策略的收益上限。传统人工构造因子的方式依赖研究员的经验与直觉,效率低、覆盖面窄,且难以在高维非线性空间中持续发现有效信号。遗传编程(Genetic Programming, GP)作为一种自动化程序搜索技术,能够将因子表达式视为可进化的“个体”,通过选择、交叉、变异等操作,在巨大的表达式空间中自动搜索出具备预测能力的Alpha因子。本课程的目标,就是带你从零构建一套可落地、可复现、可评估的GP因子挖掘系统。
一、学习目标:从理解原理到独立交付
完成本课程后,你应当具备以下能力:
- 原理层:理解遗传编程的编码方式、适应度评估、遗传算子与收敛机制,能解释GP为何适合因子挖掘。
- 工程层:能够搭建包含数据预处理、算子库定义、种群初始化、并行评估、结果落库的完整流水线。
- 策略层:能够将挖掘出的因子接入回测框架,完成IC分析、分层测试、换手率评估与组合优化。
- 风控层:能够识别过拟合、未来函数、因子拥挤等常见陷阱,并设计样本外验证与稳健性检验方案。
二、核心价值:为什么用遗传编程挖掘因子
人工因子挖掘的典型流程是“假设—构造—验证”,研究员一次只能验证少量表达式。GP的价值在于将这一过程自动化,并在搜索过程中保留“优胜劣汰”的进化压力。具体价值体现在三个方面:
- 搜索空间大:给定算子集合与终端变量,GP可以组合出数以亿计的表达式,远超人工枚举能力。
- 非线性表达能力强:GP天然支持嵌套函数、条件分支与时间序列算子,能捕捉传统线性模型难以表达的关系。
- 可解释性优于黑箱模型:进化出的因子是一棵可读的表达式树,便于研究员理解其经济含义并进行归因。
下面这张图展示了GP因子挖掘的整体知识框架与实战路线图,建议你在学习后续章节时反复回看,明确自己当前所处的阶段。
三、方法流程:GP因子挖掘的六个关键步骤
无论使用哪种GP实现,因子挖掘的流程都可以归纳为以下六步。后续章节将逐一展开,这里先建立整体认知。
| 步骤 | 核心任务 | 关键输出 | 常见风险 |
|---|---|---|---|
| 1. 数据准备 | 清洗行情与财务数据,构造终端变量集 | 对齐后的面板数据 | 未来函数、幸存者偏差 |
| 2. 算子库定义 | 设计算术、时序、横截面、逻辑算子 | 函数集与终端集 | 算子过多导致搜索爆炸 |
| 3. 种群初始化 | 生成多样化的表达式树 | 初始种群 | 多样性不足、过早收敛 |
| 4. 适应度评估 | 计算IC、RankIC、夏普等指标 | 个体适应度值 | 评估偏差、计算资源瓶颈 |
| 5. 遗传操作 | 选择、交叉、变异、精英保留 | 新一代种群 | 表达式膨胀、语义重复 |
| 6. 结果筛选与验证 | 去相关、样本外测试、归因分析 | 候选因子清单 | 过拟合、因子拥挤 |
一个典型的GP主循环伪代码如下,你可以先感受整体节奏,后续会逐行实现:
population = initialize_population(size=500, max_depth=6)
for generation in range(50):
    fitness = evaluate(population, train_data)
    parents = select(population, fitness, method="tournament")
    offspring = crossover(parents, rate=0.7)
    offspring = mutate(offspring, rate=0.1)
    population = elitism(population, offspring, elite_size=20)
    if converged(population):
        break
best_factors = filter_by_ic(population, threshold=0.03)
validate_out_of_sample(best_factors)
四、案例场景:一个可感知的因子挖掘任务
假设我们要为A股中证500成分股挖掘日频Alpha因子。终端变量包括开盘价、收盘价、最高价、最低价、成交量、换手率、市值等。算子库包含加减乘除、滞后、差分、滚动均值、滚动标准差、排名、相关系数等。GP的任务是自动组合这些元素,生成对未来5日收益率有预测力的表达式。
一个可能被进化出的因子表达式如下:
rank(
  ts_std(close / ts_mean(close, 20) - 1, 10)
) * (-1)
该表达式可以理解为:过去10日收盘价相对20日均线偏离度的波动率,取横截面排名后反向。经济含义是:短期偏离波动越大的股票,未来收益可能越差。这类表达式人工也能构造,但GP可以在一次运行中同时评估数千个类似结构,并保留其中IC最高、相关性最低的一批。
五、常见误区与复盘要点
初学者在GP因子挖掘中容易踩以下坑,提前了解可以节省大量时间:
- 误区一:适应度只看IC。IC高不代表可交易,还需考虑换手率、容量、行业暴露。建议适应度函数加入换手惩罚项。
- 误区二:忽略样本外验证。GP在样本内搜索能力极强,若不严格划分训练/验证/测试集,几乎必然过拟合。
- 误区三:算子库设计随意。算子过多会导致搜索空间爆炸,过少则限制表达力。建议从核心算子开始,逐步扩展。
- 误区四:不做因子去相关。GP容易挖掘出高度相似的因子,直接组合会放大风险。需计算因子间相关性并做聚类筛选。
- 误区五:忽视计算成本。GP评估是计算密集型任务,需使用向量化、并行化和缓存机制。
本课程后续将围绕上述框架展开:先搭建数据与算子基础,再实现GP引擎,接着建立因子评估体系,最后完成策略回测与风控闭环。你现在需要做的,是明确自己的学习目标,并准备好一个可以运行Python的环境。接下来,我们将从数据准备与算子库设计开始,正式进入实战。