3. 统计基础
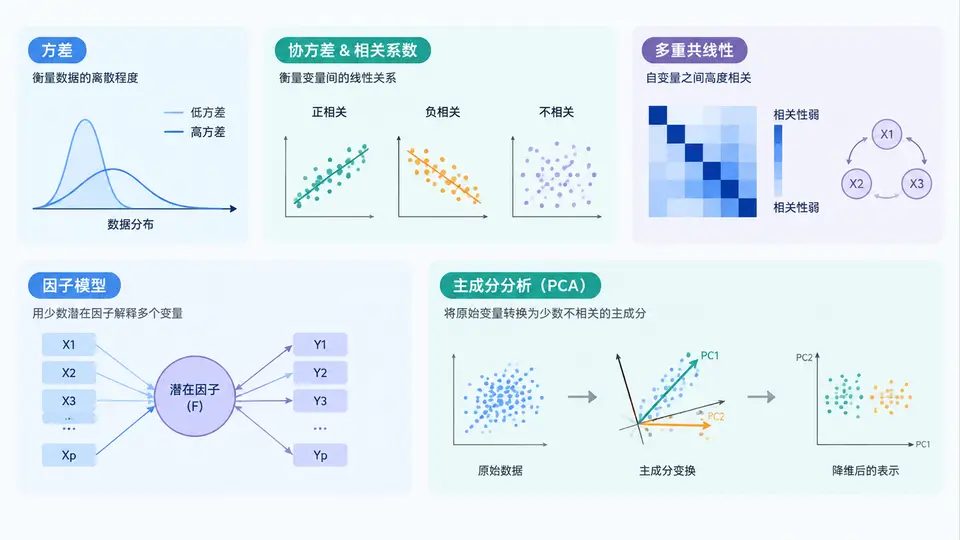
在因子正交化与PCA共线性处理的实战中,很多问题并非出在代码实现,而是出在对统计量的理解偏差。方差、协方差、相关系数、多重共线性、因子模型与主成分,这六个概念构成了后续所有操作的“度量语言”。本节把它们放在同一条逻辑链上:从单变量的波动,到双变量的联动,再到多变量的冗余,最后到降维与因子解释。
一、核心原理:从方差到协方差矩阵
方差衡量单个变量围绕均值的离散程度,公式为各观测值与均值差的平方和除以自由度。它决定了该变量在建模中“话语权”的大小。若不做标准化,方差大的因子会在PCA中占据主导,这未必代表它更重要,只代表它数值尺度更大。
协方差衡量两个变量同向或反向变动的程度。协方差为正,说明一个变量高于均值时,另一个也倾向于高于均值;为负则相反。但协方差的数值受量纲影响,无法直接比较强弱,于是引入相关系数:协方差除以两个变量标准差的乘积,得到取值在[-1,1]之间的无量纲量。
当变量超过两个时,所有两两协方差组成协方差矩阵,所有两两相关系数组成相关系数矩阵。这两个矩阵是PCA和因子分析的核心输入。PCA本质上是对协方差矩阵(或相关系数矩阵)做特征分解,特征值代表主成分解释的方差大小,特征向量代表主成分的方向。
关键等式:相关系数 = 协方差 / (变量A标准差 × 变量B标准差)。标准化后的数据,其协方差矩阵等于原始数据的相关系数矩阵。因此,做PCA前是否标准化,等价于选择分析协方差矩阵还是相关系数矩阵。
二、多重共线性:冗余信息的统计表现
多重共线性指自变量之间存在较强的线性相关关系。它并不违反模型假设,但会带来三个典型后果:回归系数估计方差膨胀、系数符号与业务直觉相反、模型对样本微小变动极度敏感。在因子投资中,市值因子与价值因子、动量因子与反转因子之间常出现中高相关,若不处理,因子暴露估计会不稳定。
检测多重共线性的常用手段包括:
- 相关系数矩阵:快速发现两两高相关,但无法捕捉三个及以上变量的联合线性关系。
- 方差膨胀因子VIF:对每个自变量做对其余自变量的回归,VIF = 1/(1-R²)。经验上VIF大于10视为严重共线性,大于5需警惕。
- 条件数:协方差矩阵最大特征值与最小特征值之比的开方。条件数过大说明矩阵接近奇异。
| 统计量 | 衡量对象 | 取值范围 | 在共线性处理中的作用 |
|---|---|---|---|
| 方差 | 单变量波动 | [0, +∞) | 判断是否需标准化 |
| 协方差 | 两变量联动 | (-∞, +∞) | 构建协方差矩阵 |
| 相关系数 | 两变量线性强度 | [-1, 1] | 初筛高相关变量对 |
| VIF | 单变量被其余变量解释程度 | [1, +∞) | 定位冗余因子 |
| 特征值 | 主成分方差贡献 | [0, +∞) | 决定保留几个主成分 |
三、因子模型与主成分:两种降维思路
因子模型假设观测变量由少数潜在因子线性组合加上噪声构成,即 X = ΛF + ε。它的目标是解释变量之间的协方差结构,因子通常具有业务含义,比如市场因子、规模因子、价值因子。因子模型允许噪声存在,因此不要求因子完全解释所有方差。
主成分分析则是纯粹的数学变换,把原始变量线性组合成互不相关的主成分,第一主成分方差最大,依次递减。PCA不假设潜在因子,也不保证主成分有业务解释。它的核心用途是降维、去相关和共线性处理。
两者的关系可以这样理解:PCA是对协方差矩阵的完全分解,保留全部方差;因子模型只保留共同方差部分,把独特方差归入误差。实战中,若目标是消除共线性后做回归,PCA更直接;若目标是构建可解释的因子暴露,因子模型更合适。
import numpy as np

# 模拟三个高度相关的因子
np.random.seed(42)
f1 = np.random.normal(0, 1, 1000)
f2 = 0.9 * f1 + np.random.normal(0, 0.3, 1000)
f3 = 0.8 * f1 + np.random.normal(0, 0.4, 1000)
X = np.column_stack([f1, f2, f3])

# 相关系数矩阵
corr = np.corrcoef(X, rowvar=False)
print("相关系数矩阵:\n", np.round(corr, 3))

# 特征分解
eigvals, eigvecs = np.linalg.eigh(corr)
print("特征值:", np.round(eigvals, 3))
print("第一主成分方差贡献率:", round(eigvals[-1] / eigvals.sum(), 3))
运行上述代码,你会看到三个因子的相关系数均在0.8以上,第一主成分方差贡献率通常超过0.9。这意味着三个因子的大部分信息可以被一个主成分概括,剩余成分主要是噪声。这正是PCA处理共线性的直观依据。
四、误区与复盘:常见理解偏差
误区一:相关系数高就必须删除变量。高相关只说明信息冗余,是否删除取决于建模目标。若做预测且样本充足,保留高相关变量未必有害;若做归因解释,则需处理。
误区二:PCA前不标准化。若变量量纲差异大,方差大的变量会主导主成分,导致结果被数值尺度而非统计结构驱动。除非所有变量同量纲且业务上认可方差权重,否则应先标准化。
误区三:把主成分直接当作业务因子。主成分是正交的数学构造,符号和方向可能随样本变化。用于回归可以,用于业务解释需谨慎,通常要结合因子旋转或改用因子模型。
复盘时建议按以下流程检查:先看相关系数矩阵和VIF定位共线性来源;再判断是删除、合并还是降维;若选PCA,确认是否标准化、保留几个主成分、主成分是否可解释;最后在样本外验证降维后的模型稳定性。把统计量当作诊断工具,而不是机械的删除规则,才能在因子正交化与共线性处理中做出可靠决策。