1. 课程导入
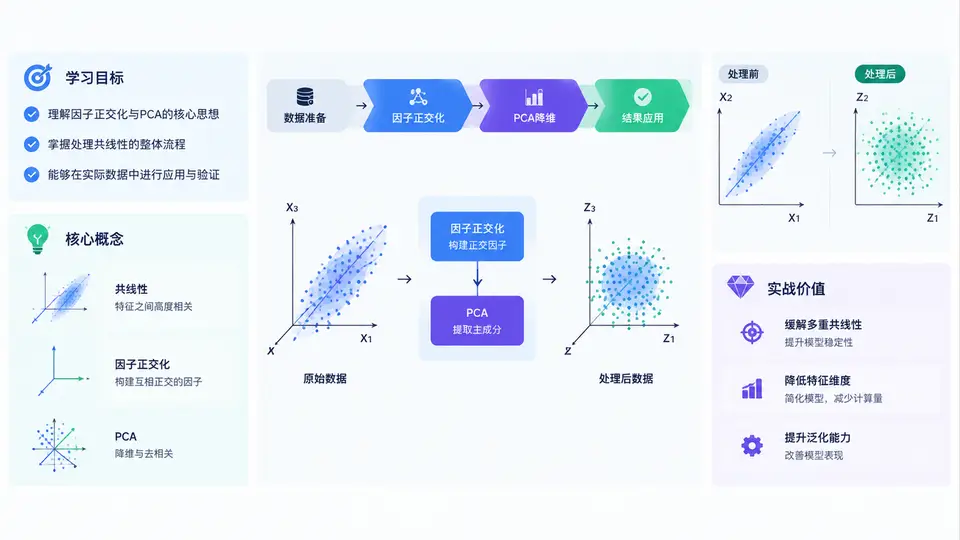
在量化投研、信用评分、宏观因子配置以及多因子选股等场景中,我们经常会遇到一个看似“技术细节”、实则决定模型成败的问题:因子之间的共线性。当两个或多个因子高度相关时,回归系数会变得极不稳定,符号可能反转,显著性检验失真,模型在样本外表现大幅波动。更隐蔽的是,共线性不会让模型报错,它只是悄悄地把可解释性、稳定性和泛化能力一点点侵蚀掉。本课程要解决的,正是这条从“发现问题”到“工程化处理”的完整链路。
一、学习目标:从“知道”到“能落地”
本课程不是单纯讲数学推导,而是围绕“可运行、可复现、可解释”三个标准设计。完成学习后,你应当能够:
- 识别共线性:熟练使用相关系数矩阵、方差膨胀因子(VIF)、条件数等指标判断共线性严重程度,而不是仅凭直觉。
- 理解正交化本质:掌握Gram-Schmidt正交化、对称正交化等方法的几何含义,理解“正交”并不等于“无关”,而是线性无关且内积为零。
- 掌握PCA降维逻辑:理解主成分分析如何通过特征值分解把相关因子转化为互不相关的主成分,并正确解释方差贡献率与载荷矩阵。
- 完成工程实现:能够用Python/NumPy/scikit-learn编写正交化与PCA处理流程,并接入回归、打分或组合优化模型。
- 规避常见误区:避免“先PCA再解释原始因子”“正交化后忘记还原”“用PCA处理类别特征”等典型错误。
二、核心概念:共线性、正交化与PCA的关系
共线性是指自变量之间存在较强的线性相关关系。完全共线性时,设计矩阵不满秩,最小二乘解不唯一;近似共线性时,解虽然存在,但方差极大。衡量共线性的常用指标包括:
| 指标 | 含义 | 经验阈值 | 适用场景 |
|---|---|---|---|
| 相关系数 |r| | 两两因子线性相关程度 | > 0.7 需警惕 | 快速初筛 |
| VIF | 某因子被其余因子解释的程度 | > 10 严重 | 回归模型诊断 |
| 条件数 κ | 设计矩阵奇异程度 | > 30 需处理 | 数值稳定性评估 |
| 特征值 | 相关矩阵的谱分布 | 接近0表示共线 | PCA前置分析 |
正交化的目标是构造一组新的变量,使它们两两内积为零。最经典的是Gram-Schmidt过程:依次将每个因子对已正交化的因子回归,取残差作为新的正交因子。这样得到的因子保留了原始因子的部分信息,同时消除了线性依赖。
PCA则从另一个角度出发:它不直接修改原始因子,而是通过线性组合生成主成分。第一主成分是方差最大的方向,第二主成分在与第一主成分正交的方向上方差最大,依此类推。由于主成分之间严格不相关,PCA天然解决了共线性问题,但代价是主成分的物理含义往往不如原始因子直观。
三、整体框架:一条从诊断到落地的流水线
本课程将围绕以下五步框架展开,后续章节会逐一深入:
- 数据准备与诊断:清洗缺失值、标准化,计算相关矩阵、VIF和条件数,判断共线性来源。
- 正交化处理:根据业务目标选择Gram-Schmidt、对称正交或PCA白化,输出正交因子矩阵。
- 模型接入:将处理后的因子输入线性回归、逻辑回归或组合优化器,对比系数稳定性与样本外表现。
- 解释与还原:对正交因子或主成分进行业务命名,必要时通过载荷矩阵还原原始因子贡献。
- 监控与迭代:在滚动窗口中持续监控VIF和主成分方差贡献率,防止共线性随市场结构变化而复发。
下面是一个最小可运行的诊断代码片段,用于快速查看共线性程度:
import numpy as np
import pandas as pd
from statsmodels.stats.outliers_influence import variance_inflation_factor

# 假设 df 是标准化后的因子矩阵
X = df.values
vif = pd.DataFrame()
vif["factor"] = df.columns
vif["VIF"] = [variance_inflation_factor(X, i) for i in range(X.shape[1])]
print(vif.sort_values("VIF", ascending=False))

# 条件数
cond = np.linalg.cond(X)
print("Condition Number:", round(cond, 2))
四、实战价值与典型场景
为什么值得花一整门课来学这件事?因为共线性处理直接关系到真金白银的决策质量。以下是三个高频场景:
- 多因子选股:估值、动量、质量因子之间常存在相关性。若不处理,回归系数可能把动量因子的正向贡献错误地归因到估值因子上,导致组合偏离预期暴露。
- 信用评分卡:收入、负债率、资产规模等变量高度相关。PCA或正交化后建模,可以提升评分卡的区分度和稳定性,同时满足监管对模型可解释性的要求。
- 宏观因子配置:增长、通胀、流动性因子相互交织。通过PCA提取宏观主成分,可以构建更稳健的风险平价组合。
五、常见误区与复盘清单
初学者最容易踩的坑,往往不是数学不会,而是流程顺序和解释逻辑出错。请对照以下清单自查:
- 误区1:先PCA再解释原始因子。主成分是线性组合,直接说“第一主成分代表估值”需要看载荷矩阵,不能凭方差大小臆断。
- 误区2:正交化后忘记还原。如果最终要输出原始因子权重,必须通过变换矩阵逆运算还原,否则业务方无法理解。
- 误区3:对类别特征做PCA。PCA基于方差和欧氏距离,类别变量需先做独热编码或改用MCA等适配方法。
- 误区4:训练集和测试集分别拟合PCA。必须用训练集的均值和主成分方向变换测试集,否则造成信息泄露。
- 误区5:只看VIF不看业务逻辑。有些因子虽然相关,但业务上必须同时保留,此时应优先考虑正则化而非强行正交化。
本章作为导入,已经勾勒出共线性问题的全貌、核心工具和落地路径。接下来,我们将从诊断指标开始,逐步进入可运行的代码实战。请记住:正交化和PCA是手段,不是目的;真正的目标是让模型更稳、更准、更可解释。