3. 数据准备
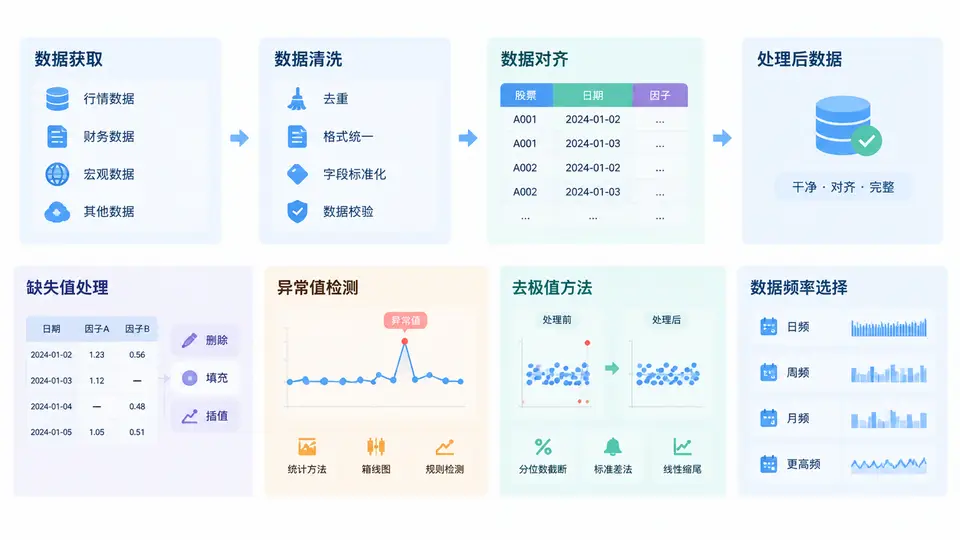
因子研究的第一道分水岭,往往不在模型,而在数据。因子检验、中性化与衰减诊断的结论是否可信,取决于输入数据是否干净、对齐是否正确、极值是否被合理处理。本章围绕数据准备的全流程展开,目标是让你建立一套可复用、可审计的数据处理规范。
一、核心原理:数据质量决定因子结论的上限
金融数据具有三个天然特征:非平稳、低信噪比、强噪声。价格序列受宏观、行业、情绪、流动性等多重因素驱动,单日收益率中真正可被因子解释的部分通常很小。若数据准备阶段引入偏差,后续无论用IC、分层回测还是回归检验,都会得到看似显著但不可复现的结论。
数据准备的核心目标可以概括为四点:可得性、一致性、可比性、稳健性。可得性指数据在时间与截面上完整覆盖;一致性指字段口径、复权方式、币种、单位统一;可比性指不同标的、不同时期可横向纵向比较;稳健性指极端值不会主导统计量。理解这四点,后续每一步操作都有明确依据。
二、方法流程:从获取到频率选择
1. 数据获取
常见来源包括行情数据库、财务数据库、另类数据接口。获取阶段要明确:复权方式(前复权、后复权、不复权)、时间戳含义(交易日、公告日、生效日)、字段单位(元、万元、百分比)。建议在获取层就保留原始字段与元数据,避免后续无法追溯。
2. 清洗与对齐
清洗包括去除重复记录、修正明显错误、统一代码与日期格式。对齐是金融数据准备中最容易被低估的环节,需区分三类对齐:
- 时间对齐:将不同频率数据映射到统一交易日历,避免未来函数。
- 截面对齐:确保同一时点所有标的字段齐全,避免幸存者偏差。
- 逻辑对齐:财务数据按公告日而非报告期对齐,防止信息提前泄露。
3. 缺失值处理
缺失并非随机。财务指标缺失可能意味着亏损、停牌或未披露。常用策略:
- 删除缺失比例过高的标的或字段;
- 截面中位数/行业中位数填充;
- 时间序列前向填充,但需限制最大填充天数;
- 保留缺失标记,作为独立特征或过滤条件。
4. 异常值检测与去极值
异常值可能来自数据错误,也可能是真实极端事件。常用检测方法包括MAD、分位数法、Z-Score。去极值常用中位数绝对偏差法(MAD)与分位数截断(Winsorize)。下面给出一个可复用的MAD去极值示例:
import numpy as np
import pandas as pd

def mad_winsorize(series, n=5):
    median = series.median()
    mad = (series - median).abs().median()
    if mad == 0:
        return series
    upper = median + n * 1.4826 * mad
    lower = median - n * 1.4826 * mad
    return series.clip(lower, upper)

# 对每个截面日期分组去极值
df['factor_clean'] = (
    df.groupby('date')['factor']
      .transform(lambda x: mad_winsorize(x, n=5))
)
5. 数据频率选择
频率选择需权衡信号衰减速度、交易成本、样本量、计算复杂度。高频数据样本多但噪声大、换手高;低频数据稳定但可能错过快速衰减的因子。实务中常见做法是:因子计算用日频,检验用周频或月频,以降低换手与噪声影响。
| 频率 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 日频 | 样本量大,反应快 | 噪声高,换手高 | 短周期因子、高频交易 |
| 周频 | 噪声与成本折中 | 样本量中等 | 多数量价因子检验 |
| 月频 | 稳定,成本低 | 样本少,衰减慢 | 基本面因子、长期配置 |
三、案例/场景:一个因子从原始数据到可用面板
假设我们要检验“20日动量因子”。原始数据包含A股全市场日行情,存在停牌、涨跌停、新股上市不足20日等问题。处理流程如下:
- 获取后复权收盘价,避免除权跳空;
- 按交易日历对齐,停牌日保留缺失;
- 剔除上市不足60日的标的,避免新股异常;
- 计算20日收益率,按日截面MAD去极值;
- 缺失值用行业中位数填充,并记录填充比例;
- 输出周频面板,用于IC与分层回测。
四、误区/复盘:数据准备中最常见的五个坑
- 未来函数:用报告期而非公告日对齐财务数据,导致回测虚高。
- 幸存者偏差:只保留当前仍上市的标的,忽略退市与停牌样本。
- 过度填充:长时间前向填充掩盖了真实缺失,使因子暴露失真。
- 去极值不一致:训练集与测试集使用不同参数,导致分布漂移。
- 频率混用:用日频因子暴露对应月频收益,却未做时间聚合,造成信息错配。
数据准备不是一次性工作,而是贯穿因子研究全生命周期的工程。把获取、清洗、对齐、缺失、异常、频率六个环节标准化,你才能在后续的中性化与衰减诊断中,把精力真正放在因子逻辑本身,而不是反复排查数据问题。