1. 课程导入
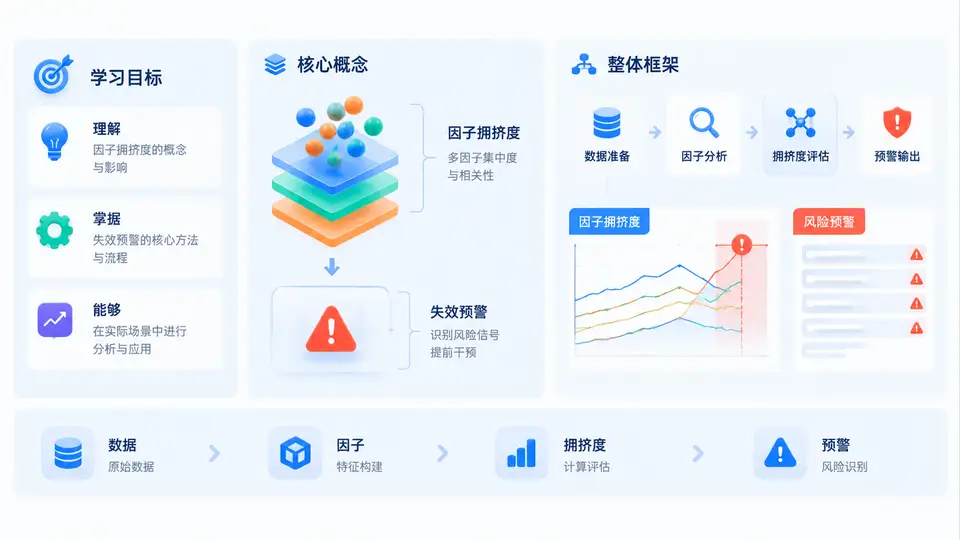
欢迎进入《因子拥挤度与失效预警实战》。在量化投资中,我们常常遇到一个令人困惑的现象:一个因子在历史回测中表现优异,逻辑清晰、IC稳定、多空收益显著,但一旦投入实盘,收益却迅速衰减,甚至出现持续回撤。问题往往不在于因子本身“错了”,而在于使用它的人太多、资金太集中、交易行为太相似——这就是因子拥挤。本课程的目标,是帮助你建立一套可量化、可监控、可预警的因子拥挤度分析体系,并在因子失效前获得可操作的信号。
1.1 学习目标
完成本课程后,你应当能够独立完成以下任务:
- 理解因子拥挤的形成机制:从资金流、持仓集中度、交易行为趋同、估值价差等维度解释拥挤如何产生。
- 构建拥挤度指标:掌握基于持仓、收益相关性、换手率、因子估值价差等数据的量化度量方法。
- 设计失效预警规则:将拥挤度指标转化为可执行的预警阈值与分级信号。
- 完成实战复盘:能够对典型因子失效案例进行归因,区分“拥挤导致失效”与“逻辑本身退化”。
- 落地监控系统:形成一套从数据采集、指标计算到预警输出的工程化流程。
1.2 核心概念
在正式进入方法之前,需要先统一几个关键概念。它们贯穿全课程,也是后续指标设计和预警规则的基础。
| 概念 | 含义 | 典型观测信号 |
|---|---|---|
| 因子拥挤 | 大量资金使用相同或高度相似的因子暴露,导致交易行为趋同、预期收益被提前透支。 | 持仓集中度上升、因子收益相关性升高、换手率异常 |
| 因子失效 | 因子对未来收益的预测能力显著下降,IC均值衰减、多空收益回撤或波动放大。 | IC连续为负、多空净值回撤、因子收益波动率抬升 |
| 拥挤度 | 对拥挤程度的量化刻画,通常由多个子指标合成,取值越高表示越拥挤。 | 综合得分、分位数、历史排名 |
| 失效预警 | 当拥挤度或因子表现指标触发阈值时,输出减仓、对冲或暂停使用的信号。 | 预警等级、触发时间、建议动作 |
| 因子估值价差 | 因子多头组合与空头组合的估值差异,价差过大往往意味着拥挤。 | PB/PE价差、股息率价差 |
需要特别区分两个容易混淆的概念:因子拥挤是“因”,因子失效是“果”之一。拥挤不一定立即导致失效,但会显著提高失效的概率和幅度;而失效也可能由宏观环境变化、制度调整或数据质量问题引起,未必与拥挤有关。本课程的重点,是识别拥挤这一可观测、可干预的前置变量。
1.3 整体框架:从监测到预警的闭环
本课程采用“数据—指标—信号—动作”的四层框架。每一层都有明确的输入、输出和工程实现方式。
- 数据层:采集持仓数据、交易数据、行情数据、因子暴露数据和估值数据,形成统一的时间序列面板。
- 指标层:计算拥挤度子指标,包括持仓集中度、收益相关性、换手率分位、估值价差等,并合成综合拥挤度。
- 信号层:设定阈值与分级规则,将连续拥挤度转化为离散预警等级,如正常、关注、预警、高危。
- 动作层:根据预警等级输出组合调整建议,包括降低暴露、增加对冲、暂停因子使用或切换备用因子。
为了更直观地理解四层框架的流转关系,下面给出一个简化的结构示意:
1.4 典型场景与常见误区
先看一个典型场景。某量化机构使用“低波动+高ROE”复合因子构建多头组合。前三年该因子表现稳定,但第四年开始,市场上大量产品采用相似逻辑,导致低波动股票估值被持续推高。此时可以观察到:
- 该因子多头组合的PB中位数相对全市场分位从60%升至92%;
- 因子多空收益的滚动60日相关性从0.3升至0.75;
- 组合换手率下降,但持仓集中度上升,前十大重仓股占比从25%升至48%。
这些信号共同指向拥挤度上升。随后该因子出现连续两个季度的多空回撤,IC均值由0.06降至-0.02。如果机构在拥挤度进入“预警”级别时降低暴露,回撤幅度可显著收窄。
在工程实现上,建议将拥挤度计算封装为可配置的流水线。下面是一个简化的参数配置示例,用于说明后续章节会涉及的配置结构:
crowding_config:
  factor_name: "low_vol_high_roe"
  lookback_window: 252
  sub_indicators:
    - name: "holding_concentration"
      weight: 0.30
      threshold_warn: 0.70
      threshold_high: 0.85
    - name: "return_correlation"
      weight: 0.25
      threshold_warn: 0.60
      threshold_high: 0.80
    - name: "turnover_percentile"
      weight: 0.20
      threshold_warn: 0.75
      threshold_high: 0.90
    - name: "valuation_spread"
      weight: 0.25
      threshold_warn: 0.80
      threshold_high: 0.95
  alert_levels:
    normal: [0.00, 0.50]
    watch: [0.50, 0.70]
    warn: [0.70, 0.85]
    high: [0.85, 1.00]
这份配置体现了本课程后续章节的核心工作方式:每个子指标有独立权重和阈值,综合得分映射到分级预警,最终驱动组合动作。你不需要现在记住所有细节,但需要建立“配置化、可复现、可回测”的工程意识。
1.5 本章小结与学习建议
本章完成了三项导入任务:明确了学习目标,统一了因子拥挤、因子失效、拥挤度、失效预警等核心概念,并给出了“数据—指标—信号—动作”的整体框架。同时,通过典型场景和常见误区,说明了为什么拥挤度监控是因子投资中不可省略的一环。
学习建议如下:
- 先理解概念之间的因果关系,再进入指标计算,避免“会算不会用”。
- 每学完一个指标,尝试在自己的因子池上做一次历史分位数回看,建立直观感受。
- 预警规则不要追求一次完美,先跑通闭环,再用实盘或模拟数据迭代阈值。
- 始终区分“拥挤导致失效”与“逻辑退化导致失效”,两者的应对动作不同。
当你能够用拥挤度解释一次真实的因子回撤,并提前给出可执行的减仓建议时,这门课程的核心价值就真正落地了。