3. Human-in-the-loop核心理念
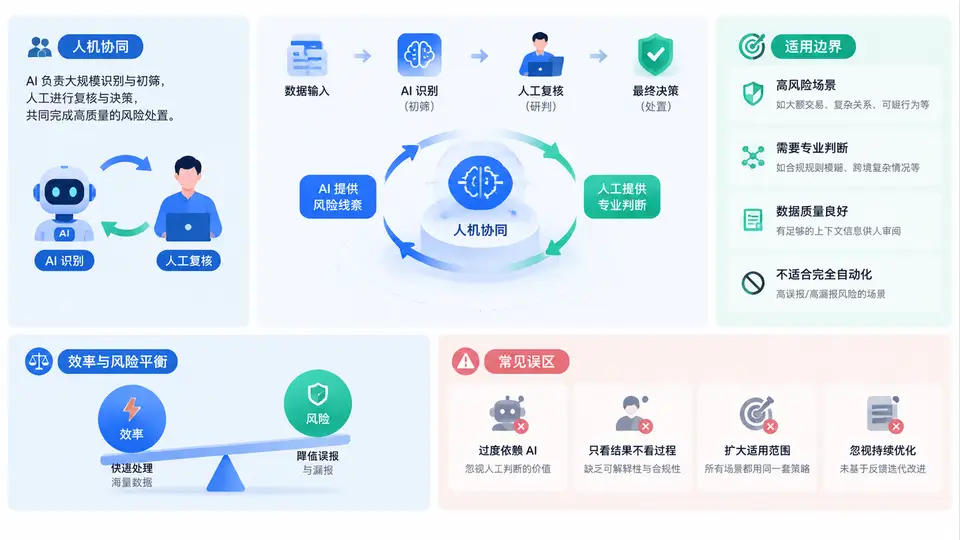
在反洗钱(AML)体系中,Human-in-the-loop(HITL,人在回路)不是“机器先跑、人工兜底”的简单分工,而是一种责任可追溯、判断可干预、模型可进化的协同机制。它的核心问题是:在什么节点让机器决策,在什么节点必须由人确认,以及人机之间如何传递上下文与反馈。
一、人机协同的定义:不是替代,而是分工与闭环
HITL 指在自动化流程中保留人类判断节点,使系统输出在关键环节被人工审核、修正或否决,并将人工结论回流为模型与规则的改进信号。它包含三个层次:
- 决策层协同:机器负责初筛、打分、聚类与排序,人负责最终定性(可疑/不可疑、上报/关闭)。
- 知识层协同:人工复核中发现的边缘案例、新型洗钱手法,被沉淀为规则、特征或标注样本。
- 责任层协同:每一笔预警的处置路径、复核人、时间戳、依据均需留痕,满足监管可解释与可审计要求。
核心公式:HITL = 机器规模化处理 + 人类关键判断 + 反馈闭环。缺少反馈闭环,就退化为“人工兜底”;缺少人类判断,则退化为“黑箱自动化”。
二、适用边界:哪些环节必须有人,哪些可以放手
并非所有环节都适合引入人工。判断边界可依据风险敞口、判断复杂度、监管要求、数据成熟度四个维度。以下清单可作为落地参考:
| 环节 | 机器主导 | 人工主导 | 典型边界条件 |
|---|---|---|---|
| 交易初筛 | 是 | 否 | 规则明确、阈值稳定、误报可容忍 |
| 预警排序 | 是 | 辅助 | 模型评分需可解释,人工可调整优先级 |
| 可疑定性 | 辅助 | 是 | 涉及主观判断、监管上报责任 |
| 客户尽调 | 辅助 | 是 | 高风险客户、复杂股权、政治公众人物 |
| 模型调参 | 是 | 审批 | 需人工确认阈值变更与影响评估 |
| 新型手法识别 | 否 | 是 | 无历史样本、需专家经验 |
边界原则:当错误成本高、判断依赖上下文、监管要求可解释时,必须保留人工节点;当处理量大、规则稳定、错误可快速纠正时,可让机器主导。
三、效率与风险平衡:如何设计复核队列与阈值
HITL 的工程难点在于:人工产能有限,而预警量可能巨大。若全部人工复核,效率崩溃;若全部自动关闭,风险失控。平衡的关键是分层复核 + 动态阈值 + 风险加权。
常见做法是将预警分为三层:
- 自动关闭层:低风险、高置信度、规则明确,机器直接关闭并留痕。
- 快速复核层:中风险,人工在标准化表单中快速确认,平均处理时间控制在分钟级。
- 深度调查层:高风险或模型不确定,进入专家队列,允许跨系统取证与多轮研判。
以下是一个简化的队列分配配置示例,用于说明参数如何影响人机分工:
queue_policy:
  auto_close:
    risk_score_max: 0.25
    confidence_min: 0.90
    rule_hit: ["low_risk_country", "salary_income"]
  fast_review:
    risk_score_range: [0.25, 0.70]
    sla_minutes: 15
    required_fields: ["customer_id", "txn_summary", "alert_reason"]
  deep_investigation:
    risk_score_min: 0.70
    or_conditions:
      - pep_flag: true
      - adverse_media_hit: true
      - model_uncertainty: high
    sla_hours: 48
该配置的核心思想是:让机器处理确定性高的部分,让人处理不确定性高、责任重的部分。同时,SLA(服务级别协议)必须与队列风险等级匹配,避免高风险案件因排队而延误。
风险提示:若自动关闭阈值设置过宽,可能漏报;若过窄,则人工队列积压,导致真正高风险案件被延迟处理。阈值应定期用回溯测试与监管反馈校准。
四、常见误区与复盘:从“有人”到“有效协同”
许多团队声称已实施 HITL,但实际效果不佳,常见误区包括:
- 误区一:把 HITL 等同于人工兜底。机器输出没有上下文,人工只能重复劳动,反馈无法回流,模型永不改进。
- 误区二:所有预警都人工复核。导致分析师疲劳、误判率上升,真正高风险案件被淹没。
- 误区三:人工结论不结构化。复核意见写在自由文本中,无法用于模型训练与规则优化。
- 误区四:忽视人机责任边界。出事后无法判断是模型缺陷还是人工失职,审计追踪断裂。
- 误区五:只关注效率指标,忽视风险指标。如只看“关闭率”和“处理时长”,不看漏报率与监管处罚。
复盘时,建议用以下清单检查 HITL 是否真正闭环:
| 检查项 | 合格标准 |
|---|---|
| 人工结论是否结构化 | 有固定标签、原因码、置信度 |
| 反馈是否回流模型 | 每周/每月有标注样本进入训练或规则库 |
| 责任是否可追溯 | 每笔预警有机器评分、人工操作、时间戳 |
| 阈值是否动态校准 | 基于回溯测试与监管反馈定期调整 |
| 人工负荷是否可控 | 队列积压量、平均处理时长在设定 SLA 内 |
关键结论:HITL 的成功标准不是“有人参与”,而是“人机分工清晰、反馈闭环有效、风险与效率可量化平衡”。只有把人工判断转化为结构化数据,才能让系统持续进化,而不是停留在静态规则加人工补丁的阶段。