3. 实体去重概述
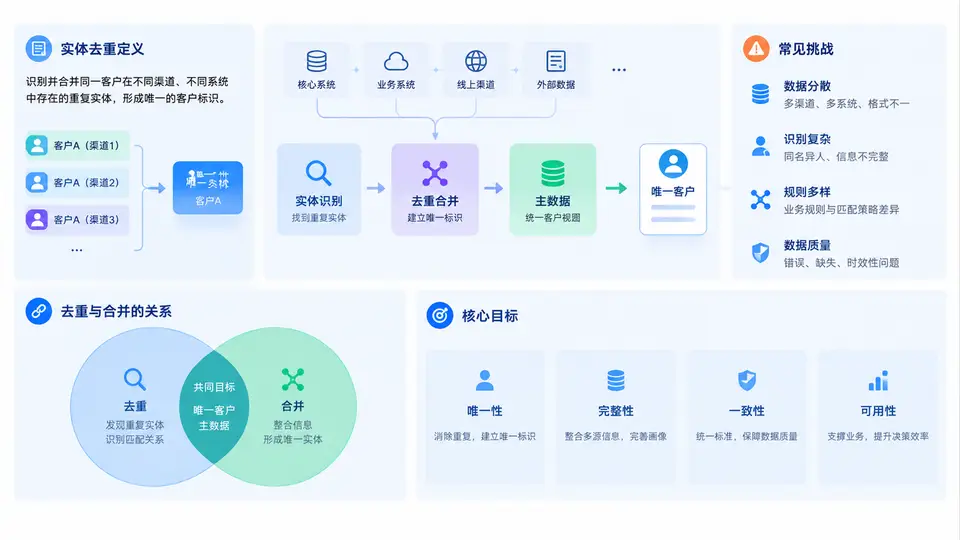
在KYC(Know Your Customer,了解你的客户)体系中,客户主数据往往来自多个业务系统、多个渠道和多个历史阶段。同一个客户可能在开户系统、信贷系统、支付系统、反洗钱系统中分别留下记录,而这些记录的名称、证件号、地址、联系方式等字段并不完全一致。实体去重,就是要在这些看似不同、实则可能指向同一真实主体的记录中,识别出重复实体,并为后续的客户主数据合并提供可靠依据。
3.1 实体去重的定义
实体去重(Entity Deduplication)是指在同一数据集合或跨数据集合中,识别出指向同一真实世界实体(如个人、企业、机构)的多条记录,并判定其重复关系的过程。在KYC场景中,实体通常指客户主体,包括自然人客户、非自然人客户及其关联方。
实体去重不是简单的“字段完全相等”判断。它通常包含三个层次:
- 精确匹配:证件号码、统一社会信用代码等强标识完全一致,可直接判定为同一实体。
- 模糊匹配:姓名存在同音字、简繁体、空格差异,地址存在缩写或层级缺失,需要借助相似度算法判断。
- 概率匹配:多个弱标识组合后,通过评分模型判断两条记录属于同一实体的概率。
因此,实体去重的本质是一个“判定问题”:给定两条或多条记录,判断它们是否指向同一真实主体,并给出置信度。
3.2 典型业务场景
实体去重在KYC与客户主数据管理中无处不在,常见场景包括:
| 业务场景 | 重复来源 | 去重目标 |
|---|---|---|
| 多系统客户整合 | 开户、信贷、理财、支付系统各自建档 | 形成统一客户视图 |
| 渠道数据合并 | 线上APP、线下柜面、第三方渠道 | 识别同一客户多渠道身份 |
| 集团客户识别 | 母子公司、关联企业分别登记 | 构建集团客户树 |
| 反洗钱名单比对 | 内部客户与制裁名单、PEP名单 | 降低误报与漏报 |
| 历史数据迁移 | 旧系统多次迁移、手工补录 | 清理脏数据与重复档案 |
这些场景的共同点是:数据源分散、标准不统一、历史包袱重。如果不去重,客户主数据就会出现“一人多档、一企多码”,直接影响风险计量、监管报送和客户体验。
3.3 去重与合并的关系
去重与合并是客户主数据治理中前后衔接的两个环节,但目标不同。去重回答“哪些记录是同一个实体”,合并回答“如何把这些记录整合成一条高质量主数据”。
去重是判断,合并是行动。没有可靠的去重结果,合并就会把不同客户错误地揉在一起;没有合理的合并策略,去重成果也无法转化为可用的主数据。
在实际工程中,二者通常形成如下流水线:
- 数据标准化:统一姓名、证件、地址、电话等字段格式。
- 候选对生成:通过分块、索引减少需要比较的记录对数量。
- 相似度计算:对候选对进行字段级和记录级评分。
- 重复判定:根据阈值或模型输出重复/非重复/待人工复核。
- 主数据合并:对判定为同一实体的记录,按 survivorship 规则选择或融合字段值。
- 关系维护:保留合并历史、来源系统和审计线索。
可以用一段简化的伪代码表示去重与合并的衔接:
for each candidate_pair in candidate_pairs:
    score = similarity_model(candidate_pair)
    if score >= AUTO_MATCH_THRESHOLD:
        mark_as_duplicate(candidate_pair)
    elif score >= REVIEW_THRESHOLD:
        send_to_manual_review(candidate_pair)
    else:
        mark_as_distinct(candidate_pair)

for cluster in build_clusters(duplicate_pairs):
    golden_record = merge(cluster, survivorship_rules)
    persist(golden_record, lineage=cluster.source_records)
3.4 常见挑战与目标
实体去重看似直观,但在KYC真实数据中挑战非常集中。以下是最常见的几类问题:
- 数据质量差:证件号缺失、姓名错别字、地址不完整、电话变更频繁。
- 标准不统一:不同系统对“客户名称”的定义不同,有的含前缀,有的含后缀。
- 规模大:百万级甚至千万级客户,两两比较不可行,必须依赖分块与索引。
- 误合并风险高:同名同姓、家族企业名称相近,容易把不同实体错误合并。
- 监管要求严:KYC数据涉及隐私与合规,去重过程必须可解释、可审计。
- 动态变化:客户信息随时间变化,今天不重复的记录明天可能重复。
在KYC场景中,漏合并会导致客户视图不完整,误合并则可能引发隐私泄露、错误授信和监管处罚。因此,去重策略必须在召回率与准确率之间取得平衡,并保留人工复核通道。
针对上述挑战,实体去重的核心目标可以归纳为:
- 准确性:尽可能减少误合并和漏合并,尤其是高风险客户。
- 可解释性:每个重复判定都能追溯到具体字段和规则。
- 可扩展性:支持海量数据的批处理和增量处理。
- 可审计性:保留合并前后记录、操作时间和操作人。
- 业务适配性:不同客户类型、不同风险等级可采用差异化阈值。
3.5 一个简化的判断示例
假设两条个人客户记录如下:
记录A:姓名=张伟,证件号=110101199001011234,电话=13800001111
记录B:姓名=张伟,证件号=110101199001011234,电话=13900002222
证件号完全一致,属于强标识精确匹配,可直接判定为同一实体。再看另一组:
记录C:姓名=张伟,证件号=110101199001011234,地址=北京市朝阳区
记录D:姓名=张玮,证件号=110101199001011234,地址=北京朝阳区某路
证件号一致,姓名存在同音字差异,地址存在层级和写法差异。此时强标识仍然起决定作用,但姓名和地址的相似度可以作为辅助证据,提升判定置信度。如果证件号缺失,则必须依赖姓名、电话、地址、出生日期等多字段组合评分。
在KYC实体去重中,建议遵循“强标识优先、弱标识组合、人工复核兜底”的原则。强标识包括证件号、统一社会信用代码、护照号等;弱标识包括姓名、电话、地址、邮箱、出生日期等。
实体去重是客户主数据合并的起点,也是KYC数据治理中最具技术含量和业务敏感性的环节之一。理解其定义、场景、与合并的关系以及核心挑战,是后续设计去重规则、选择算法和落地工程方案的基础。