1. 课程导入
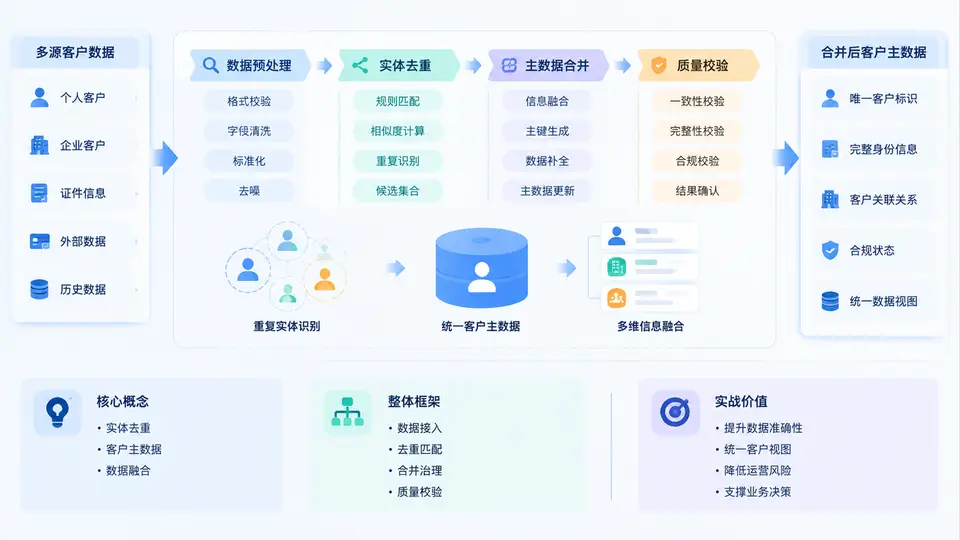
在金融机构、支付平台、跨境电商与大型企业客户管理体系中,KYC(Know Your Customer)不仅是一项合规要求,更是客户数据治理的起点。然而,同一客户在不同系统、不同渠道、不同时间留下的记录往往并不一致:姓名有繁简体差异,证件号码可能带空格或掩码,手机号可能变更,地址可能拆分粒度不同,企业名称可能包含括号、简称或曾用名。若这些记录不能有效识别为同一实体,就会导致重复授信、风险漏判、营销骚扰、监管报送失真。本课程的第一章不急于进入算法细节,而是先建立全局认知:我们究竟要解决什么问题,用什么概念描述问题,按什么框架推进,以及它能为业务带来什么可验证的价值。
一、学习目标:从“会跑脚本”到“能设计合并策略”
本课程的学习目标分为四个层次,建议你在学习过程中不断对照自检:
- 概念层:准确区分实体、记录、标识符、准标识符、匹配键、聚类与合并,理解“去重”与“合并”不是同义词。
- 方法层:掌握规则匹配、精确匹配、模糊匹配、分块索引、相似度计算、阈值判定与聚类合并的完整链路。
- 工程层:能够把匹配策略落地为可配置、可回溯、可监控的数据处理流程,并处理增量与全量场景。
- 治理层:理解合并后的主数据如何保留来源、如何处理冲突、如何支持人工复核与审计追踪。
二、核心概念:实体、记录与主数据
KYC实体去重与客户主数据合并,本质上是在解决“多源记录到唯一实体”的映射问题。为了后续章节沟通一致,先明确几个核心概念。
| 概念 | 含义 | KYC场景示例 |
|---|---|---|
| 实体(Entity) | 现实世界中真实存在的客户,是去重与合并的目标对象 | 张三本人、某科技有限公司 |
| 记录(Record) | 某个系统中保存的一条客户数据行 | 核心系统客户表、APP注册表、反洗钱系统名单表 |
| 标识符(Identifier) | 能唯一确定实体的强标识,如证件号、统一社会信用代码 | 身份证号、护照号、企业注册号 |
| 准标识符(Quasi-identifier) | 单独不唯一,但组合后可提高识别能力的字段 | 姓名+出生日期+手机号+地址 |
| 匹配键(Match Key) | 用于比较记录相似性的字段或字段组合 | 标准化姓名、证件号后六位、手机号 |
| 聚类(Clustering) | 将判定为同一实体的记录划分到同一组 | 把三条“张三”记录归入同一客户簇 |
| 主数据(Master Data) | 合并后形成的权威客户视图,保留来源与版本 | 客户黄金记录(Golden Record) |
需要特别强调:去重是识别重复记录的过程,合并是生成权威主数据的过程。去重回答“哪些记录属于同一人”,合并回答“同一人的哪条信息最可信、如何保留历史”。两者目标不同,工程实现也不同。
三、整体框架:从数据接入到主数据服务
本课程后续章节将围绕一条完整流水线展开。你可以先建立如下整体框架,后续每章都会落在这条链路的某个环节上。
- 数据接入与剖析:收集多源KYC记录,统计字段缺失率、重复率、编码分布与异常模式。
- 标准化与清洗:统一大小写、去除空格与特殊符号、转换繁简体、规范地址与企业名称。
- 分块索引:通过阻塞键减少比较次数,避免全量两两比较带来的平方级开销。
- 相似度计算:对候选对计算字段级相似度,如编辑距离、Jaro-Winkler、余弦相似度。
- 匹配判定:基于规则、阈值或模型判断是否为同一实体,输出匹配对。
- 聚类与合并:将匹配对传递闭包形成实体簇,按可信度规则生成主数据。
- 人工复核与反馈:对高风险或低置信度结果进行人工确认,形成标注闭环。
- 监控与增量更新:持续监控重复率、合并准确率,支持新客户增量去重。
四、实战价值:为什么值得系统学习
KYC实体去重与主数据合并不是纯技术优化,它直接关联合规、风险与收入。以下价值在真实项目中反复出现:
- 合规报送准确性:监管报送要求按客户维度汇总,重复客户会导致大额交易漏报或重复报送。
- 风险识别完整性:同一客户在多个系统分散记录,风险信号无法聚合,可能漏掉制裁名单命中。
- 授信与额度控制:重复客户可能获得超额授信,合并后可按统一视图控制敞口。
- 营销与客户体验:避免同一客户被多次触达,提升客户体验并降低运营成本。
- 数据资产沉淀:主数据成为客户360视图的基础,支撑分析与决策。
五、常见误区与复盘视角
在进入后续技术章节前,先了解初学者最容易踩的坑,可以显著减少返工。
误区二:只做精确匹配。精确匹配会漏掉大量因格式差异导致的重复,KYC数据中模糊匹配往往不可省略。
误区三:阈值一调了之。阈值过低会误合并不同客户,阈值过高会漏合并,必须结合业务容忍度与人工复核。
误区四:合并后丢失来源。主数据必须保留来源记录与合并依据,否则无法审计与回滚。
误区五:忽视增量场景。全量去重跑通不代表增量可用,新客户入库时需要实时或准实时判定。
下面用一个最小示例说明“标准化前后”的差异。假设两条原始记录如下:
记录A:{"name":"张 三","id_no":"110101199001011234","mobile":"138-0000-1234"}
记录B:{"name":"张三","id_no":"11010119900101123X","mobile":"13800001234"}
若直接比较,姓名因空格不同、手机号因分隔符不同、证件号因末位不同,可能被判为不同实体。经过标准化后:
标准化A:name=张三, id_no=110101199001011234, mobile=13800001234
标准化B:name=张三, id_no=11010119900101123X, mobile=13800001234此时姓名与手机号完全一致,证件号仅末位差异,可进入候选匹配并交由规则或人工复核。这个例子说明:去重效果的上限,往往在标准化阶段就已经决定。
六、本章小结与学习准备
本章建立了课程的整体认知:学习目标覆盖概念、方法、工程与治理四个层次;核心概念区分了实体、记录、标识符、匹配键、聚类与主数据;整体框架给出了从数据接入到增量监控的八步链路;实战价值说明了去重与合并对合规、风险、授信与客户体验的直接作用;误区复盘则提醒我们避免把复杂问题简化为单一阈值或精确匹配。