3. 数据来源
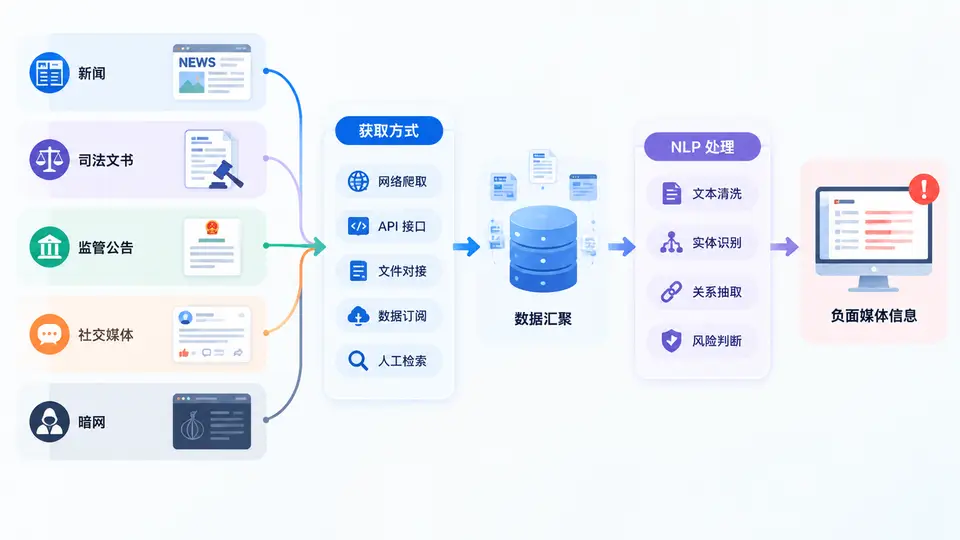
负面媒体筛查的第一道工程难题不是模型,而是数据。模型再强,如果源站覆盖不足、抓取频率过低、正文抽取错误,筛查结果就会同时出现大量漏报与误报。本节把负面媒体源拆成五类,分别说明它们的结构特征、获取方式、更新节奏与合规边界,并给出一套可落地的采集流水线。
一、五类媒体源的结构特征
不同源站的信息密度、噪声水平和法律风险差异极大。理解这些差异,才能决定“抓什么、多久抓一次、抓到后怎么解析”。
| 源类型 | 典型内容 | 结构特征 | 更新频率 | 主要风险 |
|---|---|---|---|---|
| 新闻媒体 | 调查报道、突发新闻、财经曝光 | HTML 为主,RSS/API 部分可用 | 分钟级到小时级 | 转载重复、标题党、付费墙 |
| 司法文书 | 判决书、起诉书、执行信息 | 结构化字段多,PDF/HTML 混合 | 日级到周级 | 同名同姓、隐私脱敏、地域差异 |
| 监管公告 | 处罚决定、警示函、黑名单 | 表格化、字段稳定、权威性高 | 日级到月级 | 机构名称变更、简称歧义 |
| 社交媒体 | 爆料、投诉、舆情发酵 | API 受限,文本短、口语化 | 秒级到分钟级 | 谣言、情绪化、账号伪造 |
| 暗网/深网 | 交易、泄露、非法服务广告 | 非标准协议,需专用入口 | 不定时 | 法律合规、取证合法性 |
从工程视角看,新闻与社交媒体属于“高噪声、高时效”源,适合做实时预警;司法文书与监管公告属于“高权威、低时效”源,适合做名单命中与背景核查;暗网数据则必须经过法务评估后才能纳入,通常只用于特定高风险场景。
二、获取方式:从 RSS 到定向爬取
获取方式按成本与稳定性排序,优先使用官方接口,其次 RSS,最后才是定向爬取。下面是一段典型的采集配置示例,用于定义不同源类型的抓取策略。
sources:
  - name: regulator_penalty
    type: regulator
    entry: "https://example-regulator.gov.cn/penalty"
    schedule: "0 6 * * *"        # 每日 06:00
    parser: table_parser
    fields: [company, decision_no, date, reason]
    rate_limit: 1 req/2s

  - name: court_judgment
    type: judicial
    entry: "https://example-court.gov.cn/search"
    schedule: "0 3 * * 1"        # 每周一 03:00
    parser: pdf_extractor
    fields: [case_no, parties, cause, result]
    rate_limit: 1 req/5s

  - name: news_rss
    type: news
    entry: "https://news.example.com/rss"
    schedule: "*/15 * * * *"     # 每 15 分钟
    parser: rss_parser
    fields: [title, link, pubdate, summary]
    rate_limit: 5 req/min
对于社交媒体,优先使用平台开放 API 或合规数据服务;对于暗网,必须通过法务审批并记录访问日志。任何采集行为都应遵守 robots.txt、服务条款与当地法律,避免因数据来源不合法导致筛查结果不可用。
合规红线:暗网数据、个人隐私数据、未公开司法信息的采集与使用,必须经过法务与合规部门书面确认。筛查系统应记录数据来源、采集时间与授权依据,确保审计可追溯。
三、采集流水线:从原始页面到可筛查文本
采集不是“抓下来就完事”,而是一条包含去重、抽取、清洗、语言识别、实体识别的流水线。下面给出一个最小可用的处理流程。
- 抓取:按源类型调度,记录 HTTP 状态、响应时间与内容哈希。
- 去重:基于 URL 规范化与正文 SimHash,过滤转载与重复报道。
- 正文抽取:新闻用 Readability 类算法,司法文书用 PDF 解析加表格识别。
- 清洗:去除导航、广告、页脚,统一编码与日期格式。
- 语言识别:区分中、英及多语种,决定后续 NLP 模型。
- 实体识别:抽取人名、机构名、地名、案件号,为匹配做准备。
- 入库:写入文档库与倒排索引,保留原始快照与解析结果。
其中“正文抽取”是最容易出错的环节。以新闻为例,很多页面正文被 JavaScript 动态渲染,直接请求 HTML 只能拿到空壳。此时应使用无头浏览器或平台 API,并在日志中记录渲染失败率。
2025-03-11 06:00:12 INFO  fetch regulator_penalty status=200 items=48
2025-03-11 06:00:15 INFO  parse table_parser success=47 fail=1 reason=empty_table
2025-03-11 06:00:18 WARN  dedup removed=12 duplicate_ratio=0.25
2025-03-11 06:00:21 INFO  ner extracted=156 entities=company:88 person:41
2025-03-11 06:00:22 INFO  index write docs=35 index=adverse_media
四、案例与复盘:一次漏报的根因分析
某机构在筛查一家供应商时未命中任何负面记录,但三个月后该供应商因监管处罚被曝光。复盘发现,问题不在模型,而在数据源:该监管公告发布在地方分局子站,未纳入采集范围;同时公告为 PDF 扫描件,未做 OCR。两个环节叠加,导致信息从未进入筛查库。
改进措施包括:
- 建立源站清单与覆盖率监控,定期扫描子站、栏目页与站点地图。
- 对 PDF 与扫描件增加 OCR 分支,并记录 OCR 置信度。
- 对监管公告按“机构名称+处罚决定书编号”做双字段匹配,降低同名歧义。
- 设置源站健康度告警:连续 3 天无新增即触发人工核查。
经验法则:负面媒体筛查的召回率上限由数据源覆盖率决定。先把源站覆盖做全,再优化模型,否则只是在错误的池子里钓鱼。
最后需要强调,数据来源的多样性决定了系统必须支持多模态输入:HTML、PDF、图片、JSON、XML 乃至纯文本日志。采集层应保持松耦合,解析层按源类型插件化,存储层保留原始快照与解析结果,以便在模型迭代或合规审计时回溯。只有把数据来源这一层做扎实,后续的 NLP 筛查才有可靠的基础。