1. 课程导入
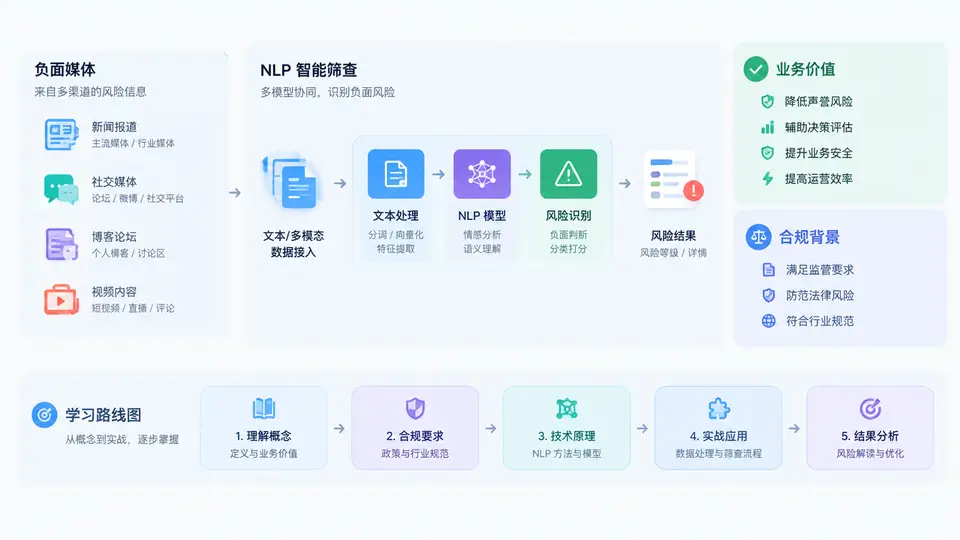
一、什么是负面媒体筛查
负面媒体(Adverse Media)筛查,是指通过自然语言处理与信息检索技术,从公开的新闻、监管公告、司法文书、行业媒体、社交平台等非结构化文本中,识别与特定个人或机构相关的负面事件信息,并将其转化为可用于风控决策的结构化信号。它关注的不是"这个人是谁",而是"这个人是否被公开报道过洗钱、欺诈、腐败、制裁、暴力犯罪、环境违法等风险事件"。
与传统黑名单筛查相比,负面媒体筛查面对的是开放域、非结构化、多语言、高噪声的文本世界。黑名单是"精确匹配"问题,而负面媒体筛查是"语义理解+实体消歧+风险判定"的复合问题。这也是为什么它必须依赖NLP技术,而不能仅靠关键词匹配。
一个典型的负面媒体筛查系统需要回答四个问题:
- 谁:文本中提到的实体,是否与目标客户是同一人/同一机构?
- 什么事:报道的事件是否属于负面风险类别?
- 多严重:事件的性质、时间、地域、可信度如何?
- 怎么办:命中后应触发何种人工复核或业务动作?
二、业务价值:从合规成本到风险护城河
负面媒体筛查最初是金融机构满足反洗钱(AML)与了解你的客户(KYC)监管要求的"规定动作",但成熟机构已将其从合规成本转化为风险识别能力。其业务价值主要体现在三个层面:
- 合规刚需:FATF、巴塞尔委员会、各国监管机构均要求金融机构对客户进行持续尽职调查,负面媒体是其中关键信息源。
- 风险前置:在开户、授信、投资、合作前发现潜在声誉与法律风险,避免与高风险主体建立关系。
- 运营效率:自动化筛查替代人工逐条检索,将分析师从海量信息中解放出来,聚焦高价值判断。
核心观点:负面媒体筛查不是"找到坏新闻",而是"在正确的时间,把正确的风险信号,交给正确的人做判断"。技术目标是降低漏报与误报,业务目标是让风险决策更快、更准、更可解释。
三、合规背景:监管要求与技术挑战
负面媒体筛查的合规要求分散在多个监管框架中。FATF《四十项建议》第10条、第12条要求对政治公众人物(PEP)和高风险客户加强尽职调查;欧盟反洗钱指令(AMLD)明确将负面媒体纳入客户风险画像;美国《银行保密法》与OFAC制裁体系则要求机构持续监控客户与交易对手。中国《反洗钱法》《金融机构客户尽职调查和客户身份资料及交易记录保存管理办法》同样要求关注客户及其受益所有人的负面信息。
这些要求落到技术实现上,带来四个核心挑战:
| 挑战 | 具体表现 | 技术应对方向 |
|---|---|---|
| 实体消歧 | 同名同姓、简称、音译、别名导致误匹配 | 多字段融合、上下文嵌入、图关系校验 |
| 语义多样性 | 同一风险事件有多种表述,关键词覆盖不全 | 语义检索、事件抽取、风险分类模型 |
| 多语言与跨地域 | 新闻来源覆盖数十种语言,翻译质量参差 | 多语言模型、翻译+原文双通道 |
| 时效与规模 | 每日新增海量文本,需近实时更新 | 流式处理、增量索引、优先级队列 |
常见误区:把负面媒体筛查等同于"关键词黑名单"。关键词匹配会带来大量误报(如"张三"是常见名),也会漏掉语义变体(如"因涉嫌洗钱被调查"未出现"洗钱"二字但语义明确)。真正的筛查系统必须建立在语义理解与实体消歧之上。
四、方法流程:从数据到决策的闭环
一个完整的负面媒体NLP筛查流程可以概括为"采集—预处理—实体识别—风险分类—消歧匹配—评分排序—人工复核"七个环节。下图展示了这一闭环的核心结构:
其中,实体识别与消歧是决定系统精度的关键。以下是一个简化的实体匹配配置示例,用于说明筛查规则如何参数化:
{
  "screening_profile": "adverse_media_v1",
  "entity_match": {
    "name_similarity_threshold": 0.85,
    "alias_expansion": true,
    "dob_tolerance_days": 30,
    "country_must_match": false
  },
  "risk_categories": [
    "money_laundering", "fraud", "corruption",
    "sanctions", "terrorism", "organized_crime"
  ],
  "severity_weights": {
    "regulatory_action": 0.9,
    "criminal_charge": 0.8,
    "media_allegation": 0.5
  },
  "review_queue": {
    "high_risk_threshold": 0.75,
    "auto_close_threshold": 0.15
  }
}该配置体现了筛查系统的核心逻辑:相似度阈值控制误报,风险类别定义覆盖范围,严重度权重决定优先级,复核阈值划分人工介入边界。实际生产中,这些参数需要根据机构风险偏好与监管要求持续调优。
五、案例场景:一次典型的筛查命中
假设某银行客户"李伟",在开户后第三个月,系统从某东南亚英文媒体抓取到一条报道:"Li Wei, a Chinese national, was charged with money laundering in Singapore." 系统处理过程如下:
- 实体识别:提取人名"Li Wei",国籍"Chinese",地点"Singapore"。
- 风险分类:命中"money_laundering"类别,事件类型为"criminal_charge",严重度权重0.8。
- 消歧匹配:与客户库中"李伟"进行姓名音译匹配、国籍匹配、年龄与职业辅助校验,相似度0.91,超过阈值0.85。
- 评分排序:综合严重度、来源可信度、时效性,风险分0.82,超过高风险阈值0.75。
- 人工复核:分析师确认报道属实且确为客户本人,触发加强尽职调查流程。
复盘要点:该案例中,如果仅用"李伟"中文关键词匹配,会完全漏掉英文报道;如果仅用姓名匹配而不做国籍与年龄校验,则可能误报同名同姓者。负面媒体筛查的精度来自多信号融合,而非单一字段匹配。
六、学习路线图:本课程将带你掌握什么
本课程共30章,围绕"数据—模型—系统—业务"四条主线展开。第1章建立整体认知后,后续内容将依次深入:
- 数据与语料:负面媒体来源、多语言语料构建、标注体系与质量评估。
- NLP核心技术:命名实体识别、实体消歧、事件抽取、风险文本分类、语义检索与向量召回。
- 系统与工程:筛查流水线设计、索引与检索、评分模型、阈值调优、性能与可扩展性。
- 业务与合规:PEP与制裁交叉筛查、人工复核工作流、审计追踪、模型可解释性与监管沟通。
每章均以真实场景为牵引,配合可运行的代码片段、配置示例与复盘清单。学完本课程,你将具备独立设计、实现与优化负面媒体NLP筛查系统的能力,并能在合规与业务之间找到可落地的平衡点。