3. 存量客户重筛的价值与挑战
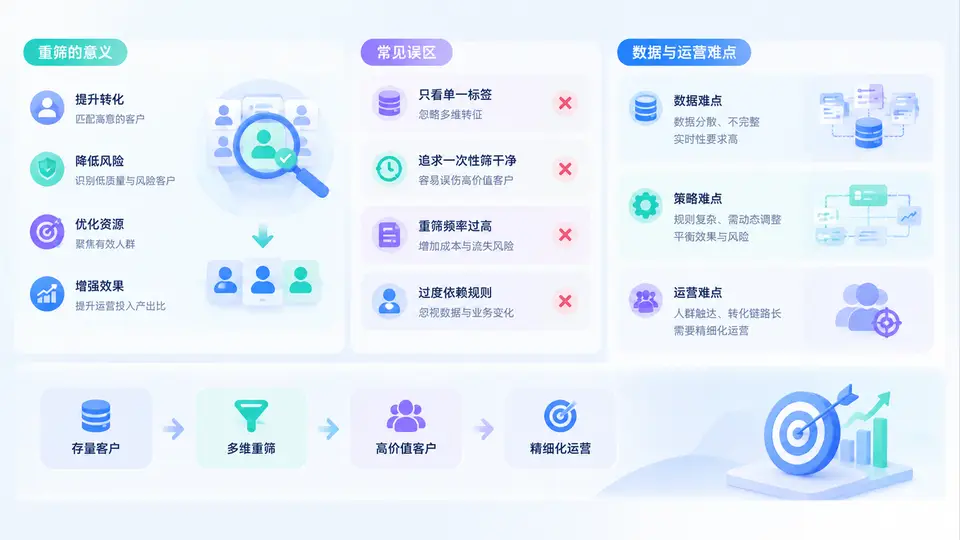
在名单增量更新之后,存量客户重筛是决定名单质量能否真正转化为业务结果的第二道关口。很多团队把重筛理解为“把老名单再跑一遍”,结果投入了大量人力,产出却寥寥。要避免这种低效,必须先理解重筛的本质:它不是重复劳动,而是用新的数据、新的规则和新的业务目标,对已有客户池做一次价值再判断和优先级再排序。
一、重筛的意义:从“名单数量”转向“名单质量”
存量客户重筛的核心价值,可以归纳为四个层面。
- 识别价值迁移:客户的价值不是静态的。过去半年未成交的客户,可能因为预算释放、组织调整或需求变化,重新进入可成交窗口。重筛能捕捉这种迁移。
- 修正历史偏差:早期名单往往依赖单一渠道或粗放规则,存在“高意向被埋没、低质量被高估”的问题。重筛用更完整的标签体系做纠偏。
- 提升运营效率:把有限的人力、触达资源和优惠预算集中到最可能转化的客户上,避免“广撒网”带来的成本浪费。
- 支撑增量更新:重筛结果会反向定义增量名单的筛选标准,让新增量与存量池形成互补,而不是简单叠加。
核心原理:重筛的本质是一次“重新打分 + 重新分层 + 重新分配资源”的决策过程。它的输入是存量客户的历史行为、当前状态和外部信号,输出是带有优先级和行动建议的客户分层结果。
二、方法流程:从数据准备到分层落地
一个可落地的重筛流程通常包含五个步骤,缺一不可。
- 明确重筛目标:是为了提升转化率、唤醒沉默客户,还是为了清理无效名单?目标不同,规则和阈值完全不同。
- 整合数据源:把交易记录、互动行为、服务工单、外部标签等统一到客户主键下,形成可计算的特征宽表。
- 定义评分模型:可以用规则打分,也可以用逻辑回归、树模型等。关键是可解释、可复现、可迭代。
- 分层与阈值设定:把客户分为高优先级、中优先级、观察池和淘汰池,并明确每层的运营动作。
- 小流量验证与全量推广:先在小样本上验证转化率,再逐步放大,避免一次性全量重筛带来的资源错配。
下面是一个简化的重筛评分配置示例,用于说明规则如何落地为可执行参数。
重筛评分配置(示例)
score = 0.35 * 最近30天互动次数
      + 0.25 * 历史成交金额分位
      + 0.20 * 需求匹配度
      + 0.10 * 服务满意度
      + 0.10 * 外部意向信号

分层阈值:
  A层(高优先级):score >= 80
  B层(中优先级):60 <= score < 80
  C层(观察池):40 <= score < 60
  D层(淘汰池):score < 40

运营动作:
  A层:48小时内人工触达
  B层:7天内自动化触达 + 人工跟进
  C层:月度内容培育
  D层:暂不投入,季度复评
三、常见误区:重筛为什么常常“白做”
重筛失败通常不是技术问题,而是认知和协作问题。以下五个误区最为常见。
| 误区 | 典型表现 | 后果 | 纠正方向 |
|---|---|---|---|
| 把重筛当重复跑批 | 用旧规则、旧数据再跑一遍 | 结果与上次几乎一致,无增量价值 | 引入新数据源和新目标,重新定义规则 |
| 只做打分不做分层 | 输出一个分数,没有行动建议 | 运营不知道先跟谁、怎么跟 | 分数必须绑定分层和动作 |
| 阈值拍脑袋 | 凭经验设定80分、60分 | 高优先级过多或过少,资源错配 | 用历史转化数据反推阈值 |
| 忽略数据时效 | 用半年前的行为数据做判断 | 误判客户当前意向 | 设定数据新鲜度要求,过期特征降权 |
| 重筛后无闭环 | 结果只停留在报表里 | 无法验证效果,无法迭代 | 建立“重筛—触达—反馈—再重筛”闭环 |
特别提醒:重筛最大的隐性成本不是计算资源,而是运营团队对错误名单的信任损耗。如果重筛结果连续两次让一线失望,后续再好的模型也很难推动落地。
四、数据与运营难点:重筛落地的真实阻力
即使流程设计正确,重筛在实际执行中仍会遇到三类难点。
数据难点:客户主键不统一、行为数据分散在多个系统、外部标签质量参差不齐、历史数据缺失严重。这些问题会导致特征计算不准确,进而影响评分可信度。解决思路是先做最小可用数据集,优先保证核心特征的准确性和时效性,而不是追求大而全。
运营难点:一线团队习惯按自己的经验跟单,对系统分层结果不信任;重筛后的名单分配涉及利益调整,容易产生抵触;触达动作没有标准化,导致同一层客户被不同方式对待,反馈数据无法比较。
迭代难点:重筛不是一次性项目,而是持续运营机制。如果没有固定的复评周期、反馈采集机制和模型更新流程,重筛结果会迅速老化,重新变成“死名单”。
实践建议:把重筛拆成“小步快跑”的节奏。第一轮只做A层和D层的区分,验证高优先级客户的转化率是否显著高于淘汰池;第二轮再加入B层和C层,逐步细化。这样既能快速拿到业务反馈,也能降低一线团队的抵触情绪。
五、案例场景:一次重筛如何挽回沉默客户
某SaaS团队在季度初做了一次存量客户重筛。原始名单中有12000家客户,其中约4000家在过去90天内没有任何互动,被一线视为“沉默客户”。团队没有直接放弃这批客户,而是引入产品使用频率、工单响应速度和续约到期时间三个新特征,重新计算优先级。
重筛后发现,沉默客户中有约600家其实仍在高频使用产品,只是没有主动联系销售。这批客户被重新划入A层,由客户成功团队在两周内完成触达。最终,这600家中产生了87个续约增购机会,转化率远高于同期新名单。这个案例说明:重筛的价值不在于“筛掉多少人”,而在于“重新发现多少人”。
总结来看,存量客户重筛是一项需要数据、规则和运营三方协同的系统工程。它的意义在于让名单从静态资产变成动态决策依据;它的挑战在于数据质量、组织信任和持续迭代。只有把重筛嵌入日常运营节奏,才能真正释放存量客户池的长期价值。