1. 课程导入
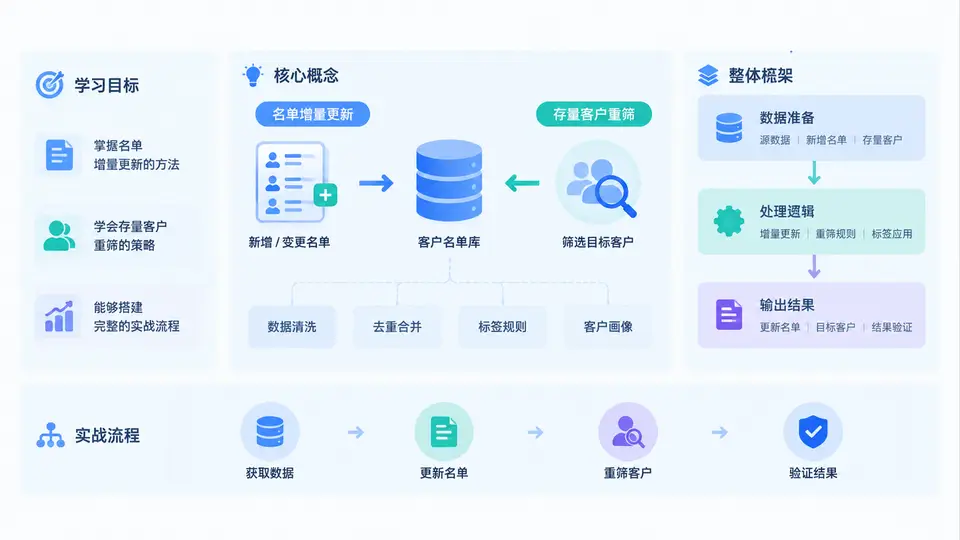
在客户经营、私域运营、销售线索管理和数据驱动增长的实际工作中,很多团队都会遇到同一个问题:名单不是一成不变的。新客户持续进入,老客户状态不断变化,沉睡客户需要重新激活,无效数据需要及时清理。如果只依赖一次性名单,后续动作就会越来越失真。本课程要解决的核心问题,就是如何把名单增量更新与存量客户重筛打通,形成一套可执行、可复盘、可规模化的实战方法。
一、学习目标:学完本课程,你将能够独立完成三件事
本课程不是单纯讲工具操作,也不是只讲数据理论,而是围绕“名单”这一业务资产,建立从数据进入到策略输出的完整能力。具体学习目标如下:
- 理解核心概念:清晰区分增量名单、存量名单、重筛、清洗、分层、优先级等关键术语,避免团队沟通时各说各话。
- 掌握方法流程:能够设计从数据接入、去重合并、标签更新、规则重筛到结果分发的标准流程。
- 落地实战场景:能够针对新客进入、老客沉睡、活动线索、渠道重复等典型场景,制定对应的更新与重筛策略。
- 规避常见误区:识别“只增不筛”“重复触达”“标签僵化”“重筛无标准”等高频问题,并知道如何复盘优化。
一句话概括本课程的价值:让名单从“静态表格”变成“动态资产”,让每一次触达都基于最新、最合适、最值得跟进的人群。
二、核心概念:先统一语言,再谈执行
在进入具体操作之前,必须先明确几个基础概念。很多团队执行效果差,不是能力不够,而是对概念的理解不一致。
| 概念 | 含义 | 常见来源 | 关键动作 |
|---|---|---|---|
| 增量名单 | 新进入系统的客户或线索数据 | 表单、广告、活动、渠道导入、API接入 | 去重、补全、打标签、分配 |
| 存量名单 | 已存在于系统或表格中的历史客户数据 | CRM、企微、订单库、历史活动名单 | 状态更新、分层、重筛、激活 |
| 重筛 | 基于最新规则对存量客户重新判断优先级和适配度 | 业务规则、行为数据、成交阶段 | 重新打分、重新分组、重新分配 |
| 清洗 | 处理无效、重复、缺失、格式错误的数据 | 原始导入数据、多系统合并数据 | 去重、补全、标准化、剔除 |
| 分层 | 按价值、意向、阶段等维度将客户划分为不同层级 | 标签体系、评分模型、业务经验 | 定义层级、制定策略、匹配动作 |
这些概念之间不是孤立的。增量名单进入后,往往需要与存量名单合并;合并之后,才能进行统一重筛;重筛结果又会反过来影响下一轮增量名单的分配规则。理解这个循环,是后续所有实战动作的基础。
三、整体框架:一条主线、四个环节、三类输出
本课程的整体框架可以概括为“一条主线、四个环节、三类输出”。主线是“让正确的人,在正确的时间,被正确地跟进”。四个环节分别是:数据接入、清洗合并、规则重筛、策略分发。三类输出则是:可跟进名单、可分析报表、可复用规则。
数据接入 → 清洗合并 → 规则重筛 → 策略分发
   ↑                                      ↓
   └────────── 复盘反馈与规则迭代 ─────────┘
这个流程看起来简单,但实际执行中,每个环节都有细节。例如,数据接入时如果没有统一字段,后续合并就会大量重复;清洗合并时如果没有主键规则,同一个客户可能被拆成多条记录;规则重筛时如果只依赖人工判断,就无法规模化;策略分发时如果没有优先级,销售或运营就会把时间浪费在低价值客户上。
建议:在开始学习后续章节前,先梳理你当前团队或业务中正在使用的名单来源、字段结构和跟进流程。带着真实问题学习,效果会明显更好。
四、典型场景:为什么必须做增量更新与存量重筛
假设你负责一个教育机构的客户运营。每天有大量新线索通过广告、公众号、转介绍进入,同时系统里还有过去两年积累的几万条老客户数据。如果只做增量更新,老客户会逐渐沉睡,甚至被重复触达;如果只做存量重筛,新进入的高意向客户又可能被延误跟进。更常见的情况是,两个动作都在做,但彼此割裂:新名单用一套规则,老名单用另一套规则,最终导致同一客户在不同名单中状态冲突。
再比如,在B2B销售场景中,一个客户可能同时存在于市场部活动名单、销售个人表格和CRM系统中。如果没有统一的增量更新机制,销售可能今天跟进一个已经成交的客户,明天又收到一条来自市场部的“新线索”提醒。这种体验不仅浪费人力,还会损害客户信任。
常见误区:很多团队把“名单更新”理解为简单追加数据,把“重筛”理解为重新导出一遍表格。实际上,真正的增量更新需要解决身份识别、字段映射和状态同步问题;真正的重筛需要解决规则定义、评分计算和结果可解释问题。
五、案例复盘:一次失败的重筛为什么没有效果
某零售品牌曾做过一次存量客户重筛。运营团队把过去一年有购买记录的客户全部导出,按消费金额分成高、中、低三档,然后给高档客户发送新品推荐,给中档客户发送优惠券,给低档客户发送激活短信。结果打开率和转化率都很低。复盘时发现三个问题:第一,消费金额高不代表当前有需求,有些客户已经流失;第二,没有排除最近已经触达过的客户,导致重复打扰;第三,没有结合最近浏览、加购等行为数据,分层过于粗糙。
这个案例说明,重筛不是简单分组,而是需要结合时间维度、行为维度、价值维度和触达历史进行综合判断。后续章节会逐步展开这些维度的具体用法。
六、本章小结与行动建议
本章作为课程导入,重点建立了三个认知:第一,名单是动态资产,增量更新和存量重筛必须协同;第二,核心概念要统一,否则执行会走偏;第三,整体框架是“接入—清洗—重筛—分发—复盘”的闭环。接下来,你可以先做一件小事:打开你当前使用的客户名单,检查是否存在重复记录、字段缺失或状态过期的问题。这个动作会帮助你更快进入后续实战章节。
- 列出你当前所有名单来源,标注哪些是增量、哪些是存量。
- 检查名单中是否有唯一标识字段,例如手机号、客户ID、企微外部联系人ID。
- 回顾最近一次触达,判断是否基于最新名单和最新规则。
当你能够清晰回答“我的名单从哪里来、现在是什么状态、下一步该给谁”,你就已经具备了进入本课程实战部分的基础。