3. 归一化基础
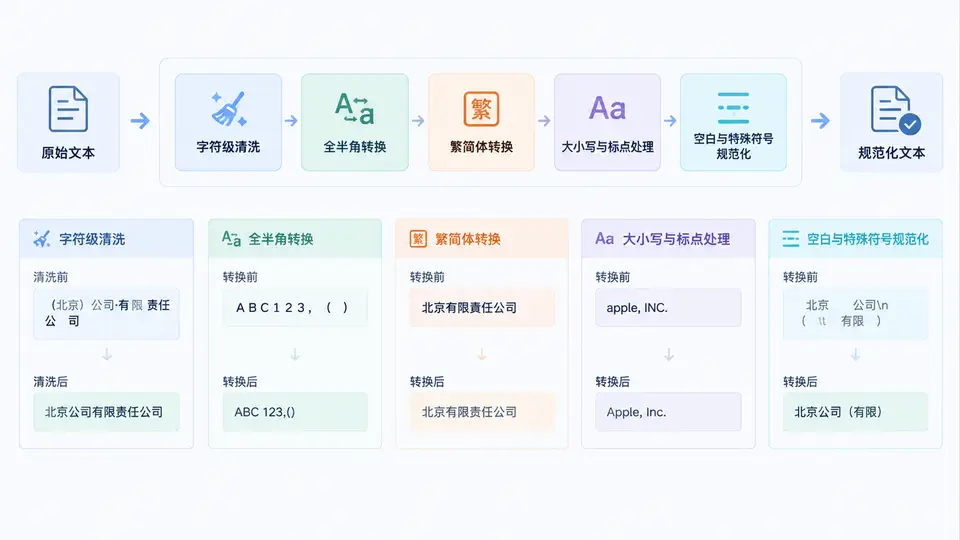
实体解析的第一步不是比对,而是让待比对的两个字符串“长得像”。企业名称天然存在大量书写变体:同一家公司可能被写成“阿里巴巴(中国)有限公司”“阿里巴巴(中国)有限公司”“阿里巴巴(中國)有限公司”,甚至夹杂全角空格、不间断空格、零宽字符。如果直接做相似度计算,这些差异会稀释真实相似度,导致漏配。归一化的目标,就是在不改变语义的前提下,把表层字符差异压缩到最小,让后续的匹配算法只关注真正有区分度的部分。
核心原理:归一化是“保语义、去噪声”的映射
归一化本质上是一组有序的字符级映射函数。它必须满足两个约束:一是语义不变,即“中国”转成“中國”再转回“中国”不改变指称对象;二是可逆性可控,即归一化后的字符串仍能追溯回原始形态,便于人工复核。因此,归一化不是简单地把所有字符都替换掉,而是分层处理:先处理不可见字符,再处理编码宽度,最后处理字形与标点。
一个常见的误区是“一步到位用正则替换所有非中文字符”。这种做法会误删企业名称中具有法律意义的括号、数字和字母,例如“3M中国有限公司”中的“3M”被删掉后,名称就失去了关键识别信息。正确的做法是按风险从低到高逐层清洗,每层只处理一类问题。
方法流程:五层字符级清洗管线
建议将归一化实现为一条可配置的管线,每层输出中间结果,便于调试和回滚。典型顺序如下:
- 空白与不可见字符规范化:将全角空格、制表符、换行符、不间断空格(U+00A0)、零宽空格(U+200B)统一替换为半角空格,再压缩连续空格并去除首尾空格。
- 全半角转换:将全角字母、数字、标点转换为半角,例如“ABC123”转为“ABC123”。中文标点如“,”“。”通常保留或按业务规则映射。
- 繁简体转换:使用成熟的繁简映射表,将繁体字转为简体字。注意“著”“乾”等多对一映射需结合上下文,企业名称中可优先采用通用映射。
- 大小写与标点处理:英文字母统一转为小写或大写;括号、连接符、点号等标点按规则统一,例如全角括号转半角、中文顿号转逗号或直接删除。
- 特殊符号过滤:移除零宽字符、控制字符、表情符号等对匹配无贡献的符号,但保留数字、字母和核心汉字。
管线设计原则:每一层只做一件事,且每层都应可独立开关。这样在遇到误杀时,可以快速定位是哪一层导致的,而不是面对一个黑盒函数无从下手。
代码示例:Python 实现字符级归一化
下面是一个可运行的归一化函数,使用 unicodedata 做全半角转换,用正则处理空白和特殊符号。繁简转换可接入 opencc 或自维护映射表。
import re
import unicodedata

def normalize_company_name(name: str) -> str:
    if not name:
        return ""
    # 1. 统一空白与不可见字符
    name = name.replace("\u00A0", " ").replace("\u200B", "")
    name = re.sub(r"[\t\r\n\f\v]+", " ", name)
    # 2. 全角转半角(NFKC 会同时处理全角字母数字和部分标点)
    name = unicodedata.normalize("NFKC", name)
    # 3. 繁简转换(示例:接入 opencc)
    # from opencc import OpenCC
    # name = OpenCC("t2s").convert(name)
    # 4. 大小写统一
    name = name.lower()
    # 5. 标点与特殊符号规范化
    name = re.sub(r"[()]", lambda m: "(" if m.group() == "(" else ")", name)
    name = re.sub(r"[·•‧]", "", name)
    name = re.sub(r"[^\w\u4e00-\u9fff()&.\- ]", "", name)
    # 6. 压缩空白
    name = re.sub(r"\s+", " ", name).strip()
    return name

# 示例
raw = "阿里巴巴(中國)有限公司\u00A0"
print(normalize_company_name(raw))
# 输出: 阿里巴巴(中国)有限公司
注意 NFKC 归一化会改变部分字符的语义,例如将“①”转为“1”,将“㈱”转为“(株)”。在企业名称场景中,这种转换通常是可接受的,但若名称中包含特殊符号作为品牌标识,则需评估是否保留。
案例与场景:从脏数据到可匹配对
假设我们有两家公司的原始记录:
| 原始名称 | 问题类型 | 归一化后 |
|---|---|---|
| 腾讯科技(深圳)有限公司 | 全角括号 | 腾讯科技(深圳)有限公司 |
| 騰訊科技(深圳)有限公司 | 繁体字 | 腾讯科技(深圳)有限公司 |
| 腾讯科技(深圳)有限公司 | 不间断空格 | 腾讯科技(深圳)有限公司 |
| 腾讯科技(深圳)有限公司 | 全角括号+空格 | 腾讯科技(深圳)有限公司 |
归一化后,四条记录完全一致,实体解析可以直接判定为同一实体。如果没有归一化,仅“腾讯科技(深圳)有限公司”与“騰訊科技(深圳)有限公司”的编辑距离就会因为括号和繁体字而显著增大,可能被误判为不同实体。
场景提示:在工商注册数据中,括号的使用尤其混乱。有的用全角“()”,有的用半角“()”,有的甚至用方括号“[]”。建议在归一化阶段统一为半角圆括号,并在后续匹配中把括号视为可忽略字符,进一步降低噪声。
误区与复盘:归一化不是越狠越好
初学者常犯的错误是“过度归一化”。例如,把“中国”和“中國”统一后,又把“有限公司”和“有限责任公司”也统一,这就改变了法律实体的类型,属于语义层面的改动,不应在字符级归一化中完成。字符级归一化只处理“怎么写”的问题,不处理“是什么”的问题。
另一个误区是忽略归一化的顺序。如果先做大小写转换再做全半角转换,全角大写字母“A”可能无法被正确识别为“A”。正确的顺序是先做编码宽度归一化,再做大小写处理。此外,繁简转换应放在全半角转换之后,因为繁体字通常不涉及全半角问题,但顺序错误可能导致映射表匹配失败。
复盘要点:每次调整归一化规则后,务必用一批已知正例和负例做回归测试。正例是应该被归一化为相同结果的名称对,负例是应该保持差异的名称对。只有正负例都通过,规则才可上线。
归一化检查清单
- 是否处理了所有空白字符,包括全角空格、不间断空格、零宽空格?
- 是否完成了全角字母、数字、标点的半角转换?
- 是否完成了繁体到简体的转换,并验证了多对一映射的准确性?
- 是否统一了英文字母大小写?
- 是否规范了括号、连接符、点号等标点?
- 是否移除了零宽字符、控制字符和表情符号?
- 是否保留了数字、字母和核心汉字,避免误删关键信息?
- 是否对归一化前后的字符串做了可追溯记录?
归一化是实体解析的地基。地基不牢,后续的相似度计算、聚类和人工复核都会事倍功半。把字符级清洗做扎实,才能让真正有区分度的名称差异浮出水面。