1. 课程导入
1.1 从一个真实问题说起
在金融风控、供应链管理、政务数据治理等场景中,我们经常遇到这样的数据:同一家企业,在不同系统里以不同名称出现。例如“阿里巴巴(中国)有限公司”“阿里巴巴(中国)有限公司”“Alibaba (China) Co., Ltd.”“阿里巴巴中国”可能指向同一法律实体;而“北京华信科技有限公司”与“北京华信科技股份有限公司”虽然名称高度相似,却可能是两家独立法人。如果直接按字符串匹配,系统会漏掉大量同一实体,也会把不同实体错误合并。
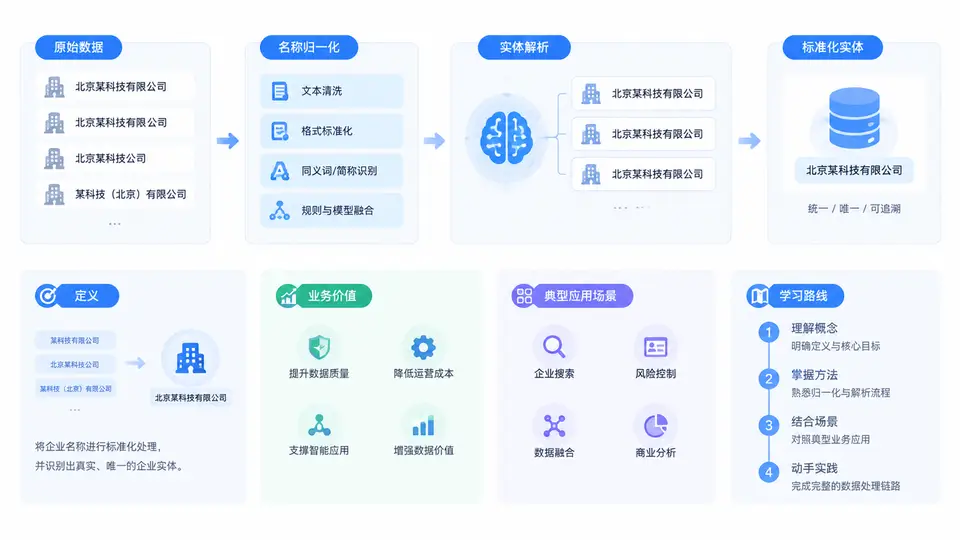
企业名称归一化与实体解析,正是为了解决“名称多样性与实体唯一性”之间的矛盾。归一化关注把名称转成标准、可比较的形式;实体解析关注判断两个名称(或记录)是否指向同一个真实世界实体。两者通常串联使用:先归一化降低表面差异,再通过规则、相似度与模型做实体判定。
1.2 核心定义与边界
企业名称归一化是指对原始名称进行清洗、标准化和结构化处理,使其在字符、词序、缩写、标点、地域、组织形式等维度上趋于一致。典型操作包括:全半角转换、繁简转换、去除多余空格与标点、统一括号、提取行政区划、识别行业词、规范组织形式(如“有限公司”“股份有限公司”“有限责任公司”)。
实体解析(Entity Resolution,也称记录链接、去重、实体对齐)是在归一化结果之上,判断多条记录是否指向同一实体,并给出置信度或合并决策。它不仅是“字符串比较”,还涉及业务规则、上下文证据、图关系与阈值策略。
1.3 业务价值:为什么值得投入
- 提升数据质量:消除重复、补全缺失、统一口径,让主数据可信。
- 降低合规与风控风险:准确识别关联企业、实际控制人、担保圈,避免漏判与误判。
- 提高运营效率:客户、供应商、合同、发票等数据自动对齐,减少人工核对。
- 支撑智能应用:知识图谱、推荐、搜索、反欺诈等上层应用依赖高质量实体底座。
从投入产出看,企业名称归一化与实体解析往往不是一次性项目,而是持续运营能力。名称会变化(更名、迁址、重组),数据源会新增,阈值和规则需要迭代。因此,课程后续会强调“可配置、可评估、可监控”的工程化方法。
1.4 典型应用场景
| 场景 | 核心问题 | 归一化与实体解析的作用 |
|---|---|---|
| 金融风控与反欺诈 | 识别关联企业、担保圈、空壳公司 | 合并同一实体的多源记录,构建企业关系图 |
| 供应链与采购 | 供应商重复、名称不一致、集团与子公司混淆 | 统一供应商主数据,支持集中采购与风险预警 |
| 政务数据治理 | 多部门数据标准不一,企业主体难以对齐 | 建立统一社会信用代码与名称的映射关系 |
| 企业知识图谱 | 实体节点重复、关系错连 | 实体对齐后提升图谱质量与查询准确率 |
| 搜索与推荐 | 用户输入简称、别名、错别字 | 归一化与别名扩展提升召回与排序效果 |
1.5 核心原理:从字符串到实体
企业名称归一化与实体解析的总体流程可以概括为“清洗—标准化—特征—匹配—决策—合并—评估”。下面给出一个可落地的处理链路:
原始名称
  → 字符级清洗(全半角、繁简、去噪)
  → 结构解析(行政区划、字号、行业、组织形式)
  → 标准化输出(标准名称、核心词、缩写、拼音)
  → 候选生成( blocking / 倒排索引 / 规则)
  → 相似度计算(编辑距离、Jaccard、词向量、拼音)
  → 决策融合(规则 + 阈值 + 模型)
  → 实体合并与冲突处理
  → 评估与监控(准确率、召回率、误合并率)
其中,候选生成常被忽视但非常关键。如果对所有名称两两比较,复杂度是 O(n²),在百万级数据上不可行。常用做法包括:按行政区划+行业词分桶、按核心词倒排、按拼音首字母分块、按统一社会信用代码前缀分块等。候选生成的目标是“不漏掉真正匹配的对,同时尽量少产生无关对”。
相似度计算需要多维度证据。例如:字符编辑距离对“有限公司”与“股份有限公司”不敏感;词级 Jaccard 能捕捉词序变化;拼音相似度能处理同音错字;数字与字母差异往往意味着不同实体。实际工程中通常组合多种特征,再通过逻辑回归、梯度提升树或规则引擎做最终判定。
1.6 整体学习路线
本课程共30章,围绕“能理解、能实现、能评估、能上线”四个目标展开。整体路线如下:
- 基础篇:定义、业务价值、场景与路线(本章),以及企业名称的构成规律与数据源特点。
- 归一化篇:字符清洗、繁简与全半角、括号与标点、行政区划识别、行业词与组织形式标准化、别名与简称生成。
- 实体解析篇:候选生成、相似度算法、规则引擎、机器学习与深度模型、阈值调优、图关系辅助判定。
- 工程篇:数据管道、性能优化、增量更新、人工审核闭环、评估指标与监控告警。
- 实战篇:金融、供应链、政务等场景的综合案例与复盘。
学习建议:每章都动手实现一个小模块,并保留可复用的函数与配置。企业名称归一化与实体解析不是“背算法”,而是“理解业务约束下的工程权衡”。当你能清晰回答“为什么这样归一化”“为什么这个阈值”“误合并的代价是什么”,就已经具备了实战能力。