1. 课程导入
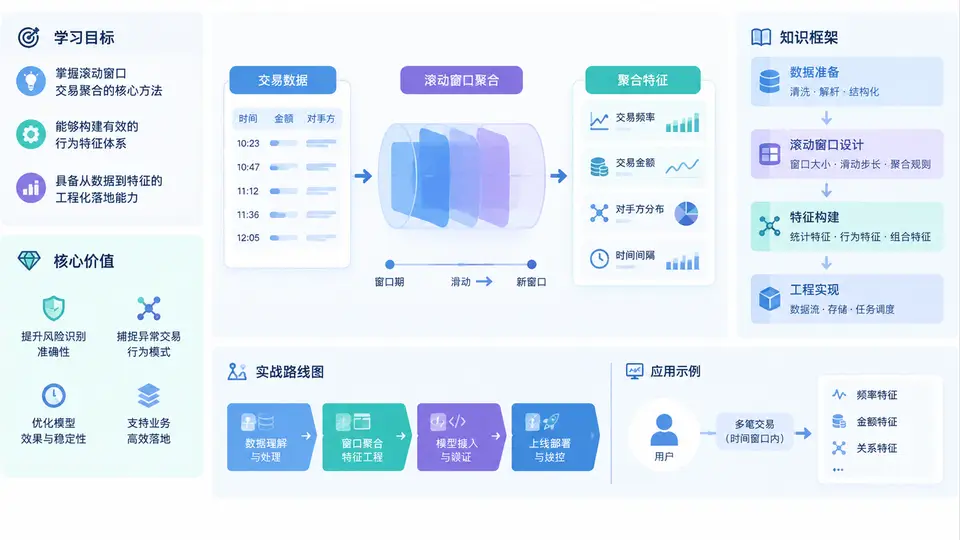
在反洗钱(Anti-Money Laundering, AML)风控体系中,交易数据本身往往只是“原材料”,真正驱动模型识别可疑行为的,是从时间维度上对交易进行聚合后形成的行为特征。单笔转账金额、单笔交易对手、单笔渠道,很难直接说明问题;但“过去7天内同一账户向多少个新对手方转账”“过去30天内夜间交易金额占比是否突然升高”“滚动3天内资金快进快出比例是否超过阈值”,这些由滚动窗口聚合出来的指标,才更接近洗钱行为的真实画像。本课程的第一章不急于写代码,而是先建立完整的学习地图:我们要学什么、为什么值得学、知识框架如何组织、实战路线如何推进。
一、学习目标:从“会算指标”到“会设计特征体系”
本课程的目标不是教会大家调用某个聚合函数,而是让大家具备独立设计AML滚动窗口特征工程方案的能力。具体可分为四个层次:
- 概念层:理解滚动窗口、滑动步长、事件时间与处理时间、窗口边界、冷启动等核心概念,能区分滚动窗口、扩展窗口与滚动统计量的差异。
- 方法层:掌握按账户、对手方、渠道、地区、交易类型等维度进行分组聚合的方法,能计算计数、求和、均值、方差、最大值、最小值、去重计数、时间间隔、趋势斜率等特征。
- 工程层:能够使用Python(pandas、polars或PySpark)实现高效滚动聚合,处理时间戳排序、缺失窗口、数据倾斜与内存控制问题,并输出可供模型训练使用的特征表。
- 业务层:能够把可疑交易报告(STR)、监管规则与模型特征对应起来,解释每个特征的反洗钱含义,避免“为了算而算”的特征堆砌。
二、核心价值:为什么滚动窗口聚合是AML特征工程的主战场
AML场景与普通推荐、广告场景有一个根本区别:负样本极少、正样本定义模糊、行为具有强时间演化性。洗钱者不会永远保持同一种模式,他们会在短时间内集中转账、分散转出、跨渠道拆分、利用节假日或夜间操作。静态的全量统计(如“账户历史总交易额”)会把这些时间模式抹平,而滚动窗口恰好保留了“最近一段时间内发生了什么”。
其核心价值体现在三方面:
- 捕捉突变:滚动窗口能对比“当前窗口”与“历史窗口”,发现交易频率、金额、对手方数量的突然跃升,这是可疑活动最直接的信号。
- 控制泄漏:在训练模型时,如果使用未来数据计算特征,会造成严重的数据泄漏。滚动窗口按时间顺序只使用窗口内历史数据,天然符合生产环境下的特征可用性约束。
- 支撑解释:监管和审计要求模型可解释。滚动窗口特征通常带有明确的时间范围和业务含义,例如“过去7天夜间交易笔数”,比黑盒嵌入更容易向合规团队说明。
下面这张表对比了静态聚合与滚动窗口聚合在AML场景中的差异,帮助大家建立直观判断:
| 对比维度 | 静态全量聚合 | 滚动窗口聚合 |
|---|---|---|
| 时间敏感性 | 低,历史行为被平均 | 高,突出近期突变 |
| 数据泄漏风险 | 高,容易混入未来信息 | 低,按时间边界截断 |
| 业务解释性 | 一般,含义过于笼统 | 强,可对应具体时间范围 |
| 计算复杂度 | 较低,一次分组即可 | 较高,需按时间滑动 |
| 适用场景 | 账户画像、静态分层 | 可疑行为监测、实时预警 |
三、整体知识框架:四层结构贯穿课程
为了避免大家把滚动窗口特征工程学成零散技巧,本课程用四层框架组织全部内容:
- 数据层:交易流水表、账户表、对手方表、时间字段、金额字段、渠道字段的清洗与对齐;事件时间与处理时间的区分;时区与节假日处理。
- 窗口层:窗口长度选择(1天、3天、7天、30天、90天)、滑动步长、窗口对齐方式、最小观测数、冷启动策略。
- 特征层:计数类、金额类、离散度类、时间间隔类、趋势类、交叉维度类特征的设计与命名规范。
- 应用层:特征回填、训练集/验证集时间切分、特征重要性分析、与规则引擎和模型评分卡的融合。
四、实战路线图:从单账户到全量特征表
本课程的实战路线遵循“先小后大、先慢后快、先正确后高效”的原则。整体推进步骤如下:
- 构造最小样例:用几十条模拟交易数据,手工验证滚动窗口的边界与聚合结果,确保理解窗口开闭区间。
- 单账户单窗口:对单个账户计算过去7天交易笔数、金额总和、对手方去重数,观察结果随时间的变化。
- 多窗口并行:同时计算1天、7天、30天窗口,形成多尺度特征,并处理窗口不足时的缺失值。
- 多维度扩展:按交易类型、渠道、地区、对手方属性分组,生成交叉聚合特征。
- 工程化提速:使用polars或PySpark替代逐行循环,处理百万级以上交易数据,控制内存与运行时间。
- 特征质量复盘:检查特征覆盖率、时间泄漏、异常值、特征漂移,并输出最终特征表。
在进入代码之前,先看一段伪代码,理解滚动窗口聚合的基本形态。后续章节会逐步替换为真实可运行的实现:
# 伪代码:按账户计算过去7天滚动聚合特征
for each account_id:
    transactions = load_transactions(account_id).sort_by("event_time")
    for each transaction_time t:
        window = transactions[
            (event_time > t - 7天) & (event_time <= t)
        ]
        feature["txn_count_7d"] = count(window)
        feature["amount_sum_7d"] = sum(window.amount)
        feature["counterparty_distinct_7d"] = distinct_count(window.counterparty)
        feature["night_amount_ratio_7d"] = sum(window.amount where hour in [0,6)) / sum(window.amount)
五、常见误区与复盘提醒
初学者在AML滚动窗口特征工程中容易踩以下几类坑,提前了解可以少走弯路:
- 误区一:窗口越大越好。窗口过大虽然样本充足,但会稀释近期突变信号,且计算成本高。应根据业务节奏选择多尺度组合。
- 误区二:忽略事件时间与处理时间差异。交易可能延迟入账,若按处理时间排序,窗口内实际发生的交易顺序会被打乱,导致特征失真。
- 误区三:用未来数据填充缺失窗口。冷启动阶段窗口内交易很少是正常现象,强行用全局均值填充会引入泄漏。
- 误区四:只算金额不算结构。洗钱常通过拆分金额、增加对手方数量来规避阈值,因此去重计数、时间间隔、金额离散度同样关键。
- 误区五:特征命名混乱。没有统一命名规范会导致后续特征管理和模型迭代困难,建议采用“维度_指标_窗口”的命名方式。
本章作为课程导入,已经为大家建立了学习目标、核心价值、知识框架和实战路线图。接下来,我们将从交易数据的结构解析与时间字段处理开始,逐步进入滚动窗口特征工程的完整实战。请记住:AML特征工程的核心不是算法复杂度,而是对时间、行为和业务语义的准确表达。