3. 关键术语
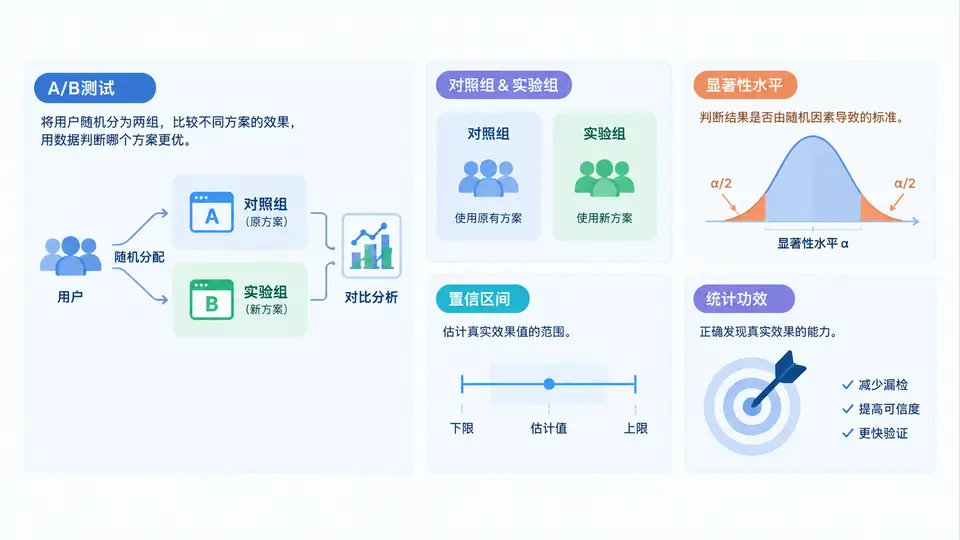
在策略验证的日常工作中,术语混乱是导致沟通成本飙升、结论被误读的首要原因。很多团队在评审会上争论得面红耳赤,最后发现双方对“显著性”的理解根本不在一个层面。本章把A/B测试中最核心的七个术语逐一拆解,目标是让你在阅读实验报告、撰写结论、与数据团队对话时,能够准确使用每一个词,并且知道每个词背后的数学含义与业务边界。
一、核心原理:从“对比”到“可置信的对比”
A/B测试的本质是一次受控实验。它把用户随机分成两组,一组看到现有策略(对照组),另一组看到新策略(实验组),然后比较两组在某个指标上的表现差异。但“有差异”不等于“策略有效”,因为随机波动、样本偏差、时间效应都可能制造假象。统计学术语的作用,就是帮我们判断:这个差异是真实效应,还是噪声。
理解这些术语,可以抓住一条主线:我们想回答的问题是“新策略是否真的更好”,而统计工具负责量化“我们有多确定”。显著性水平控制“误报”的风险,置信区间给出效应大小的范围,统计功效决定“真有效时能否被发现”,对照组和实验组则是整个比较的基石。
一句话串联:对照组与实验组提供数据,显著性水平设定判断门槛,置信区间描述效应范围,统计功效保证实验有足够“视力”发现真实差异。
二、七个关键术语逐一解析
1. A/B测试
A/B测试是一种随机对照实验,将用户随机分配到两个或多个版本,通过比较指标差异来评估策略效果。它的核心前提是随机分配和单一变量。如果同时改了按钮颜色和推荐算法,就无法归因到底是哪个改动起了作用。
2. 对照组(Control Group)
对照组是保持原有策略不变的那组用户。它代表“基准线”,没有对照组,实验组的数据就失去了参照。例如,现有转化率是5%,实验组是5.5%,这0.5个百分点是否值得上线,必须依赖对照组的稳定表现来判断。
3. 实验组(Treatment Group)
实验组是接受新策略的那组用户。实验组与对照组除了被测试的变量外,其他条件应尽量一致。若实验组用户恰好来自一线城市,而对照组来自三线城市,那么差异可能来自地域而非策略本身。
4. 显著性水平(Significance Level,α)
显著性水平是我们允许“误报”的概率上限,通常取0.05或0.01。α=0.05意味着:如果新策略其实没有效果,我们仍有5%的概率错误地认为它有效。它不衡量效应大小,只控制犯第一类错误的门槛。
5. 置信区间(Confidence Interval,CI)
置信区间给出效应大小的一个范围。95%置信区间表示:如果重复实验很多次,约95%的区间会包含真实效应值。相比单纯的p值,置信区间更有业务价值,因为它同时告诉我们“方向”和“幅度”。例如“转化率提升2%~6%”比“p<0.05”更能指导决策。
6. 统计功效(Statistical Power,1-β)
统计功效是当策略真实有效时,实验能够检测出这个效果的概率。通常要求达到80%以上。功效不足,实验就像近视眼,真实差异存在却看不见,导致“假阴性”。功效受样本量、效应大小、显著性水平和数据波动共同影响。
7. p值(p-value)
p值是在原假设成立的前提下,观察到当前或更极端结果的概率。p值越小,说明数据与原假设越不兼容。但p值不是“策略有效的概率”,也不是“效应很大的证明”。把p值误读为效果大小,是最常见的统计误用之一。
| 术语 | 核心含义 | 常见取值/标准 | 业务误读风险 |
|---|---|---|---|
| A/B测试 | 随机对照实验,比较两个版本 | 随机分流、单一变量 | 多变量同时改动导致无法归因 |
| 对照组 | 保持原策略的基准组 | 与实验组同质 | 忽略对照组导致基准漂移 |
| 实验组 | 接受新策略的组 | 仅被测变量不同 | 样本偏差污染结果 |
| 显著性水平α | 允许误报的概率上限 | 0.05或0.01 | 认为α越小效果越好 |
| 置信区间 | 真实效应的估计范围 | 95% CI | 只看p值不看区间宽度 |
| 统计功效 | 真有效时能检测出的概率 | ≥80% | 样本不足导致假阴性 |
| p值 | 原假设下出现当前结果的概率 | <0.05视为显著 | 误读为效果大小或策略正确概率 |
三、方法流程:一次规范实验的术语落地
把术语放进流程,才能看出它们如何协作。下面是一个典型的策略验证流程,每一步都对应具体术语。
- 定义假设与指标:明确新策略预期提升哪个指标,例如“新推荐算法使点击率提升”。
- 计算样本量与功效:根据预期效应大小、α=0.05、功效=80%,估算所需样本量。
- 随机分流:将用户随机分配到对照组和实验组,确保两组同质。
- 运行实验并监控:收集数据,检查是否有样本比例失衡或异常波动。
- 计算p值与置信区间:判断差异是否显著,并估计效应范围。
- 决策与复盘:结合业务成本、置信区间下限和长期影响决定是否上线。
# 示例:使用Python计算双样本t检验与置信区间
from scipy import stats
import numpy as np

control = np.array([0.05, 0.06, 0.04, 0.05, 0.07])   # 对照组转化率
treatment = np.array([0.06, 0.07, 0.05, 0.08, 0.07]) # 实验组转化率

t_stat, p_value = stats.ttest_ind(treatment, control)
ci = stats.t.interval(0.95, len(treatment)-1,
                      loc=np.mean(treatment)-np.mean(control),
                      scale=stats.sem(treatment-control))

print(f"p值: {p_value:.4f}")
print(f"95%置信区间: {ci}")
四、案例/场景:一次“显著但无效”的实验
某电商团队测试新的结算页按钮颜色。实验组转化率提升1.2%,p=0.03,团队兴奋地准备全量上线。但复盘时发现:实验组样本量只有800,置信区间为[0.1%, 2.3%],下限接近0;同时统计功效仅55%,远低于80%。这意味着如果真实效应较小,实验很可能只是碰巧捕捉到一次正向波动。
团队随后扩大样本量重跑实验,结果p=0.21,置信区间跨0,效应消失。这个案例说明:显著不等于可靠,p值小不等于效应大,功效不足的实验容易制造“假阳性”惊喜。
看到p<0.05先别急着庆祝。请同时检查:样本量是否足够、置信区间下限是否远离0、统计功效是否达标、实验组与对照组是否同质。四项都过关,结论才值得进入决策。
五、误区与复盘:术语使用中的高频陷阱
- 把p值当作效果大小:p=0.001只说明差异不太可能是噪声,不说明差异很大。大样本下微小差异也能显著。
- 忽略置信区间:只报p值不报区间,决策者无法判断效应是否具有业务价值。
- 功效不足就下结论:样本量不够时,不显著不等于无效,可能只是没检测出来。
- 对照组被污染:对照组用户受到实验组策略的溢出影响,比较基础被破坏。
- 多重比较不校正:同时看十几个指标,总有一个“显著”,需用Bonferroni等方法校正α。
- 提前偷看结果:反复查看p值并随时停止实验,会大幅提高假阳性率。
复盘时建议固定一张“术语检查清单”:对照组是否同质?样本量是否满足功效?p值与置信区间是否一致?效应是否有业务意义?把这张清单贴在实验报告模板里,能减少大量无效争论。
掌握这些术语,不是为了成为统计学家,而是为了在策略验证中做出更稳健的判断。下一次看到实验报告时,先找对照组和实验组,再看置信区间和功效,最后才看p值。这个顺序本身,就是专业与业余的分界线。