1. 课程导入
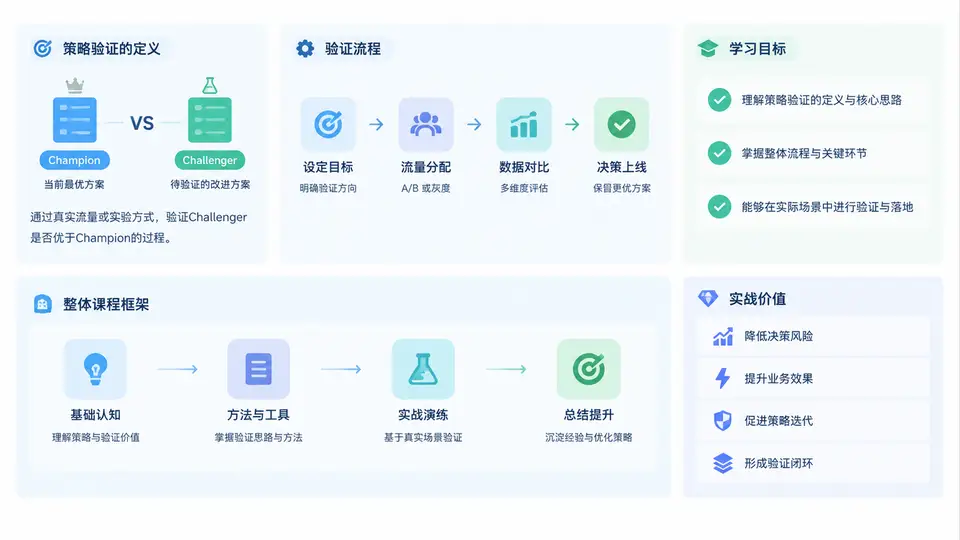
在数据驱动的产品与运营体系中,任何一次改版、推荐算法调整、定价策略变化或增长实验,最终都要回答一个朴素但关键的问题:新方案真的比旧方案更好吗?Champion Challenger策略验证,正是为回答这个问题而设计的一套工程化方法。它通过将当前稳定运行的策略(Champion)与候选新策略(Challenger)置于同一评估框架下进行对比,用可复现的数据证据决定是否切换、回滚或继续迭代。
本课程不是单纯讲A/B测试的统计公式,而是围绕“策略验证”这一完整闭环展开:从指标定义、流量切分、实验设计,到数据采集、显著性判断、灰度发布与复盘归档。第1章作为导入,将帮助你建立全局认知,明确后续29章的学习路径与实战落点。
一、核心原理:Champion与Challenger的对照逻辑
Champion Challenger模式的核心思想是受控对照。Champion代表当前生产环境中被验证过、承担主要流量的策略;Challenger代表待验证的新策略。两者在同一时间窗口、同一用户群体特征下并行运行,唯一系统性差异是策略本身。这样,观察到的指标差异才能被归因于策略变化,而非季节、渠道或用户结构波动。
从工程视角看,它包含三个基本要素:
- 分流单元:以用户ID、设备ID或会话为最小随机化单位,确保同一用户稳定落入同一组。
- 评估指标:分为主指标(如转化率、GMV、点击率)与护栏指标(如延迟、错误率、退款率)。
- 决策规则:预先定义显著性水平、最小样本量、实验周期和停止条件,避免“看数据看到显著为止”的peeking偏差。
关键认知:Champion Challenger不是“谁数字大谁赢”,而是在统计置信度与业务约束下,判断差异是否真实、是否可持续、是否值得承担切换成本。
下面用一个简化的分流配置示例说明实验组与对照组的参数定义方式:
experiment:
  name: "checkout_button_color"
  champion:
    traffic_ratio: 0.5
    strategy_version: "v1.3.2"
  challenger:
    traffic_ratio: 0.5
    strategy_version: "v2.0.0-rc1"
  metrics:
    primary: "checkout_conversion_rate"
    guardrail:
      - "page_load_p95_ms"
      - "payment_error_rate"
  decision:
    alpha: 0.05
    power: 0.80
    min_sample_per_group: 20000
    max_duration_days: 14
该配置明确了流量比例、指标口径与决策阈值。实际工程中,这些参数通常由实验平台统一管理,但理解其含义是后续所有验证工作的基础。
二、方法流程:从假设到决策的六步闭环
一个可落地的策略验证流程,通常遵循以下六个步骤。它们构成后续章节反复演练的主线。
- 提出假设:明确“改变什么、预期影响哪个指标、为什么”。例如:将结算按钮从灰色改为橙色,预期提升点击率。
- 设计实验:确定分流单元、样本量、实验周期、主指标与护栏指标,并写入实验文档。
- 实施分流:通过实验平台或配置中心将流量随机分配至Champion与Challenger。
- 采集与监控:实时观察样本量、指标趋势与系统健康度,设置异常告警。
- 统计判断:在达到预定样本量或周期后,进行显著性检验与置信区间估计。
- 决策与归档:根据结果选择全量、回滚或迭代,并记录实验结论供后续复用。
为便于对照,下表总结了每个阶段的核心产出与常见风险:
| 阶段 | 核心产出 | 常见风险 |
|---|---|---|
| 提出假设 | 可检验的假设陈述 | 假设过于宽泛,无法量化 |
| 设计实验 | 实验配置文档 | 样本量不足、指标口径不一致 |
| 实施分流 | 分流规则与版本映射 | 分流不均、用户串组 |
| 采集与监控 | 指标看板与告警记录 | 数据丢失、埋点错误 |
| 统计判断 | 显著性结论与置信区间 | 多重比较、peeking偏差 |
| 决策与归档 | 决策记录与复盘报告 | 结论未沉淀、重复踩坑 |
三、案例/场景:一次推荐策略的Challenger验证
假设某内容平台当前使用Champion策略:基于协同过滤的推荐列表。团队开发了Challenger策略:引入实时行为序列的深度学习模型。业务目标是提升人均阅读时长,同时不能显著增加接口延迟。
实验设计如下:分流单元为用户ID,Champion与Challenger各占50%流量,主指标为人均阅读时长,护栏指标为推荐接口P95延迟与崩溃率。实验周期预定14天,最小样本量每组5万用户。
运行第7天时,Challenger的人均阅读时长提升约3.2%,但P95延迟从180ms上升至260ms。此时不能简单宣布Challenger胜出,因为护栏指标已接近风险阈值。团队决定继续观察至第14天,并同步优化模型推理性能。最终第14天数据显示:阅读时长提升4.1%,延迟回落至210ms,错误率无显著变化。统计检验p值小于0.05,置信区间不包含0。团队决定先灰度20%流量上线,再逐步扩量。
场景启示:策略验证不仅要看主指标是否提升,还要看护栏指标是否可接受。一个“有效但昂贵”的策略,可能需要先优化工程成本,再谈全量。
四、误区与复盘:新手最容易踩的五个坑
在进入后续章节前,先建立对常见误区的警觉,可以显著减少无效实验。
- 误区一:实验中途反复看显著性。每次查看都会增加假阳性概率,应预先固定分析时点或使用序贯检验。
- 误区二:忽略护栏指标。主指标提升但延迟、成本或投诉率恶化,长期可能得不偿失。
- 误区三:分流单元与指标口径不匹配。例如按会话分流却按用户统计,导致组间污染。
- 误区四:样本量不足就下结论。小样本下的波动容易被误读为策略效果。
- 误区五:实验结束不归档。结论未沉淀,同类策略重复验证,浪费资源。
复盘原则:无论实验成功还是失败,都应记录假设、配置、数据、结论与后续动作。失败实验同样是重要资产,它能缩小未来探索空间。
为帮助你在本课程中建立清晰的学习路径,下面给出整体课程框架的四个模块:
- 基础篇:策略验证的定义、统计基础、指标设计与实验平台认知。
- 设计篇:分流机制、样本量计算、实验周期与护栏指标设置。
- 实战篇:推荐、定价、增长、搜索等场景的Champion Challenger完整演练。
- 进阶篇:序贯检验、多重比较、因果推断与实验文化构建。
通过本课程,你将能够独立设计并执行一次策略验证,读懂实验报告中的关键统计量,识别常见偏差,并在业务决策中平衡收益与风险。Champion Challenger不仅是一套技术方法,更是一种用证据说话的工作习惯。掌握它,意味着你在面对“要不要改”的问题时,不再依赖直觉,而是拥有可复现、可解释、可审计的决策依据。