1. 课程导入
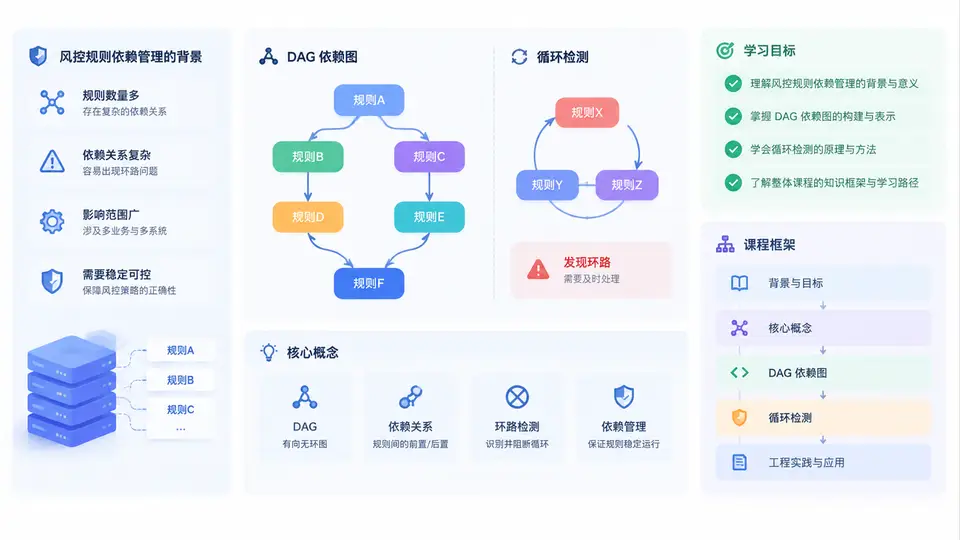
在信贷风控、反欺诈、交易安全等系统中,规则从来不是孤立存在的。一条“拒绝授信”的决策,往往要先经过身份核验、设备指纹、黑名单命中、多头借贷评分、行为序列异常检测等多个规则节点的计算;而这些节点之间又存在先后依赖、条件分支与数据传递关系。当规则数量从几十条增长到几百条、上千条时,依赖关系会迅速演化为一张复杂的有向图。如果缺少对这张图的显式建模与治理,系统就会陷入“改一条规则,崩一片链路”的困境。
本课程围绕风控规则DAG依赖图与循环检测展开,目标不是停留在概念层面,而是让学员能够把规则依赖抽象为可计算、可校验、可可视化的工程对象,并掌握循环依赖的检测、定位与修复方法。第1章作为导入,先建立背景认知、学习目标、核心概念与整体框架,为后续30章的实战推进打下共同语言。
一、为什么风控规则需要依赖管理
传统风控规则常以“规则列表”形式配置:每条规则独立判断,命中则输出分数或标签。这种模式在规则少、逻辑简单时有效,但一旦出现规则复用、规则组合、规则优先级和规则间数据引用,问题就会暴露。典型痛点包括:
- 执行顺序不确定:规则A依赖规则B的输出,但调度器按配置顺序执行,导致A读到空值或旧值。
- 循环依赖隐蔽:规则A引用B,B引用C,C又引用A,系统在运行时反复计算或直接栈溢出。
- 变更影响面不可控:修改一条底层规则,无法快速知道哪些上层规则会受影响。
- 测试与回滚困难:缺少依赖图,无法做精准的回归范围圈定和灰度发布。
- 性能瓶颈难定位:重复计算、串行等待、无效分支在图中清晰可见,但在列表里被掩盖。
依赖管理的本质,是把“规则之间谁先谁后、谁依赖谁、谁影响谁”从隐式约定变成显式结构。而DAG(有向无环图)正是表达这种结构最自然的数学工具:节点表示规则或规则组,有向边表示依赖方向,无环保证执行顺序可拓扑排序。一旦图中出现环,就说明依赖关系存在逻辑矛盾,必须检测并修复。
核心判断:风控规则依赖图的价值不在于“画得好看”,而在于它能否支撑拓扑排序、影响分析、循环检测、并行调度和变更评审。图是手段,可执行的治理能力才是目的。
二、学习目标与能力地图
完成本课程后,学员应具备以下能力:
- 能够把业务规则依赖抽象为节点、边、入度、出度、路径等图结构要素。
- 能够使用拓扑排序确定规则执行顺序,并识别无法排序的循环场景。
- 能够实现基于DFS、Kahn算法和并查集的循环检测方案,并比较其适用条件。
- 能够对规则图做影响分析,回答“改这条规则会影响哪些决策结果”。
- 能够设计规则图的存储、版本管理、可视化与线上监控方案。
- 能够处理真实工程中的复杂情况:条件依赖、动态参数、规则组嵌套、跨系统引用。
这些目标对应一条清晰的能力进阶路径:先理解图结构,再掌握排序与检测算法,然后进入工程实现,最后落到风控场景的治理与优化。
三、核心概念速览
在进入后续章节前,先统一关键术语。下表给出本课程最常用的概念及其在风控规则场景中的含义:
| 概念 | 含义 | 风控场景示例 |
|---|---|---|
| 节点(Node) | 图中的一个规则、规则组或计算单元 | “设备指纹黑名单命中”规则 |
| 有向边(Edge) | 表示依赖方向,A→B 表示A依赖B或B先于A执行 | “多头评分”依赖“近7天申请次数” |
| 入度(In-degree) | 指向该节点的边数,表示它依赖多少前置节点 | 入度为3表示该规则需要3个前置结果 |
| 出度(Out-degree) | 从该节点出发的边数,表示它被多少后续节点依赖 | 出度高说明该规则是热点基础规则 |
| 拓扑排序 | 把DAG节点排成线性序列,保证依赖在前 | 生成规则执行顺序 |
| 循环依赖 | 图中存在环,无法拓扑排序 | A依赖B,B依赖C,C依赖A |
| 强连通分量 | 任意两节点互相可达的最大子图 | 定位循环依赖的具体规则集合 |
理解这些概念时,要特别注意方向约定。工程中常见两种约定:一种边表示“依赖”,A→B 表示A依赖B;另一种边表示“执行顺序”,A→B 表示A先执行。两种约定都能工作,但必须在整个系统中保持一致,否则拓扑排序和循环检测都会得出相反结论。本课程统一采用A→B 表示A依赖B,B必须先执行。
四、整体课程框架与实战路线
本课程共30章,按“认知—算法—工程—治理”四层推进。第1章建立背景与概念;第2至第8章聚焦图建模与拓扑排序,解决“怎么表示、怎么排序”;第9至第16章深入循环检测,覆盖DFS、Kahn、Tarjan、并查集等算法及其工程取舍;第17至第24章进入实战,包括规则图存储、版本管理、可视化、影响分析、灰度发布与线上监控;第25至第30章面向复杂场景与复盘,讨论条件依赖、动态参数、跨系统引用、性能优化和典型故障案例。
为了让框架更直观,下面给出一个简化的规则依赖图示例。图中节点为规则,箭头方向为依赖方向,整体构成DAG;若在“多头评分”和“行为异常”之间误加一条反向依赖,就会形成环,导致无法排序。
从图中可以看到,身份核验是设备指纹和黑名单的前置,设备指纹和黑名单又分别支撑多头评分和行为异常,最终汇聚到授信决策。这个结构天然适合拓扑排序:先算身份核验,再算设备指纹与黑名单,然后算多头评分与行为异常,最后算授信决策。如果某条边方向被写反,或者两个节点互相引用,拓扑排序就会失败,循环检测模块必须立即报警。
学习建议:在后续章节中,每学一个算法,都回到这张图或你自己业务中的真实规则图上做一遍手工推演。图算法只有落到具体节点和边上,才会真正变成工程直觉。
五、常见误区与提前复盘
在正式进入算法细节前,先指出几个高频误区,避免后续走弯路:
- 误区一:把依赖图当成文档图。图如果只用于评审展示,不参与调度和校验,就失去了治理价值。依赖图必须可执行、可校验、可版本化。
- 误区二:认为无环是天然成立的。业务人员配置规则时,很容易出现“A引用B、B引用A”的隐蔽环,尤其在规则组嵌套和跨团队复用时。
- 误区三:只检测环,不定位环。知道“有环”不够,必须输出环上的具体节点路径,才能让规则维护者快速修复。
- 误区四:忽略条件依赖。有些依赖只在特定条件下成立,静态图可能无法完全表达,需要结合运行时信息做动态校验。
- 误区五:拓扑排序一次就够。规则图会随版本变化,每次发布前都应重新排序和检测,不能依赖历史结果。
工程提醒:循环依赖在测试环境可能因为数据巧合而不触发,但在生产环境高并发下会表现为重复计算、响应超时甚至服务雪崩。循环检测必须作为规则发布流水线的强制门禁,而不是可选的监控项。
本章完成了课程导入:明确了风控规则依赖管理的背景与痛点,给出了学习目标与能力地图,统一了节点、边、入度、出度、拓扑排序、循环依赖等核心概念,并展示了30章的整体推进框架。接下来,课程将进入图建模与拓扑排序的具体实现,从最基础的节点与边定义开始,逐步构建可运行的风控规则依赖图。