3. 设备信息采集
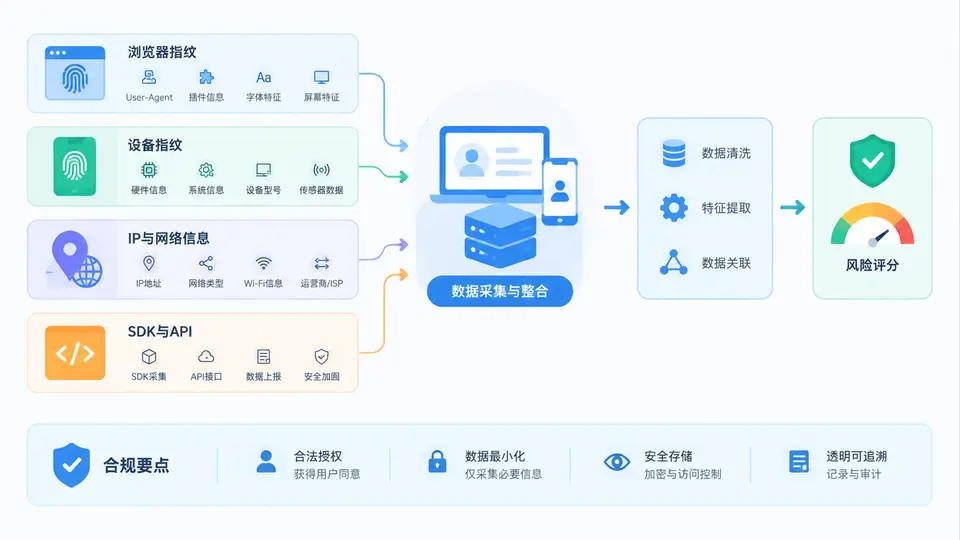
设备信息采集是3DS(3-Domain Secure)风险评分体系中最基础、也最容易踩坑的一环。风险评分模型需要回答一个核心问题:“当前发起支付的,究竟是一台什么样的设备、处在什么样的网络环境、由谁在操作?” 只有把设备维度、网络维度、行为维度的信息采集准确,后续的特征工程才有可靠的原料。本节围绕四类采集对象展开:浏览器指纹、设备指纹、IP与网络信息、SDK与API采集方式,并给出合规边界。
一、核心原理:为什么设备信息能反映风险
设备信息的风险价值来自三个基本假设。第一,稳定性假设:同一台真实设备在短时间内,其硬件、系统、浏览器特征组合具有较高稳定性,而欺诈者批量伪造设备时往往出现特征矛盾。第二,关联性假设:设备指纹、IP、账号、卡号之间存在关联网络,异常关联(如一个设备指纹关联上百张卡)是团伙欺诈的强信号。第三,可观测性假设:越接近硬件层、越难被脚本篡改的信息,其可信度越高。因此采集设计要遵循“由浅入深、由易篡改到难篡改”的分层原则。
L1 网络层:IP、ASN、代理类型、时区、语言
L2 浏览器层:User-Agent、Canvas、WebGL、字体、插件、屏幕参数
L3 设备层:设备ID、机型、OS版本、传感器、Root/越狱状态
L4 行为层:触摸轨迹、输入节奏、页面停留(通常由SDK采集)
二、浏览器指纹采集
浏览器指纹(Browser Fingerprint)是在Web/H5场景下,通过JavaScript读取浏览器暴露的各类属性,组合成一个高熵标识。常见采集项包括:
- 基础属性:User-Agent、Accept-Language、时区、屏幕分辨率、色深、设备像素比。
- Canvas指纹:绘制文本与图形后读取像素数据,不同GPU/驱动/字体渲染结果存在差异。
- WebGL指纹:读取GPU厂商、渲染器字符串及扩展列表。
- 字体与插件:检测已安装字体列表、PDF/Flash等插件。
- 音频指纹:通过AudioContext处理音频信号,读取硬件差异。
下面是一段典型的Canvas指纹采集代码,注意其输出需要做哈希后再上报,避免明文传输:
function getCanvasFingerprint() {
  const canvas = document.createElement('canvas');
  const ctx = canvas.getContext('2d');
  ctx.textBaseline = 'top';
  ctx.font = '14px Arial';
  ctx.fillStyle = '#f60';
  ctx.fillRect(0, 0, 100, 30);
  ctx.fillStyle = '#069';
  ctx.fillText('3DS-risk,设备指纹', 2, 2);
  const data = canvas.toDataURL();
  // 简单哈希,实际生产建议使用SHA-256
  let hash = 0;
  for (let i = 0; i < data.length; i++) {
    hash = (hash << 5) - hash + data.charCodeAt(i);
    hash |= 0;
  }
  return 'canvas_' + Math.abs(hash).toString(16);
}
浏览器指纹的优点是无需安装、覆盖广;缺点是易受浏览器版本升级、隐私模式、反指纹插件影响,稳定性弱于原生设备指纹。因此它更适合作为辅助特征,而非唯一主键。
三、设备指纹与SDK/API采集方式
设备指纹(Device Fingerprint)通常由原生SDK在App内采集,能拿到更底层的标识:IDFA/GAID、Android ID、Boot ID、机型、系统版本、CPU架构、是否Root/越狱、是否模拟器、传感器列表等。SDK采集的一般流程如下:
- 初始化SDK,申请必要权限(注意最小必要原则)。
- 采集设备静态特征与动态特征,生成设备唯一ID。
- 对采集字段做本地加密与签名,防止中间人篡改。
- 通过HTTPS上报至风控服务端,服务端做去重、聚类与黑名单匹配。
- 返回设备风险标签(如“模拟器”“Root”“改机”“群控”)。
API采集方式则适用于服务端无法直接获取设备信息的场景,例如商户通过服务端接口回传订单与设备关联信息。典型请求参数如下:
POST /risk/device/report
{
  "merchantId": "M20240001",
  "deviceId": "dfp_9a3c...",
  "ip": "203.0.113.45",
  "userAgent": "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0)",
  "timestamp": 1710000000,
  "sign": "sha256(...)"
}四、IP与网络信息采集
IP与网络信息是判断地理位置与代理风险的关键。采集内容包括:公网IP、IP归属地、ASN、运营商、是否数据中心IP、是否代理/VPN/Tor、时区与语言是否与IP一致。常见风险信号包括:
- IP归属地与账单地址、收货地址严重不符。
- 使用数据中心IP或已知代理池IP。
- 同一IP短时间内关联大量设备或卡号。
- 时区、语言与IP地理位置矛盾(如IP在美国,浏览器时区为东八区)。
下表汇总了四类采集对象的关键对比,便于在方案设计时取舍:
| 采集对象 | 典型字段 | 稳定性 | 主要风险信号 | 合规敏感度 |
|---|---|---|---|---|
| 浏览器指纹 | Canvas、WebGL、字体、UA | 中 | 指纹频繁变化、特征矛盾 | 中 |
| 设备指纹 | 设备ID、机型、Root状态 | 高 | 模拟器、改机、群控 | 高 |
| IP与网络 | IP、ASN、代理类型 | 低 | 代理、地理矛盾、IP聚集 | 中 |
| SDK/API | 上报通道与签名 | — | 篡改、重放、伪造上报 | 高 |
五、案例与误区复盘
案例:某商户在3DS风控中发现一批订单集中在凌晨,设备指纹显示为同一机型但设备ID每次不同,IP来自同一数据中心段。进一步分析发现,攻击者使用改机工具批量修改Android ID,但未修改传感器列表与CPU架构,导致这些“新设备”在传感器维度高度一致。风控据此将该批设备聚类为同一团伙,拦截率显著提升。这说明单一标识易被篡改,多维度交叉验证才是关键。
常见误区:
- 误区一:把设备指纹当作绝对唯一ID。 实际上设备指纹是概率性标识,应配合置信度与聚类使用。
- 误区二:采集字段越多越好。 过度采集既增加合规风险,也拖慢SDK性能,应遵循最小必要原则。
- 误区三:忽略合规与用户授权。 设备信息多属于个人信息,采集前需明确告知、取得授权,并支持用户撤回。
- 误区四:只采集不校验。 采集到的字段需做一致性校验(如时区与IP、语言与地区),否则脏数据会污染特征。
综上,设备信息采集不是简单的字段堆砌,而是一套分层、交叉验证、合规可控的工程体系。只有把浏览器指纹、设备指纹、IP网络信息与SDK/API通道协同设计,才能为后续风险评分提供高质量、可解释、可追溯的特征输入。