1. 课程导入
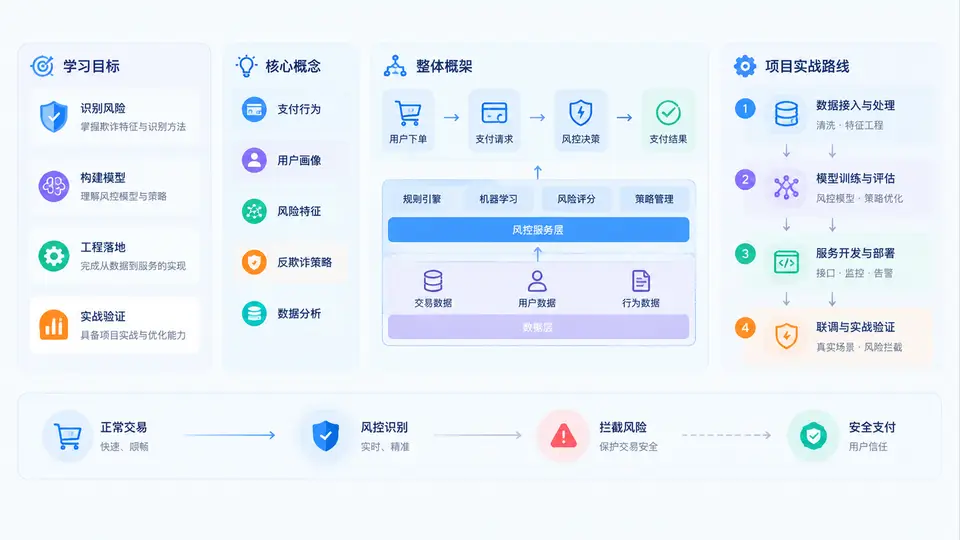
欢迎进入《电商支付反欺诈完整项目实战》。在开始写第一行规则、第一段特征代码之前,我们需要先建立一张“全局地图”:我们究竟要解决什么问题,系统由哪些关键部件构成,数据如何流动,模型与规则如何协同,以及一个完整的反欺诈项目从需求到上线要经历哪些阶段。本章不追求技术细节,而是帮助你形成正确的工程直觉,避免后续陷入“只会调模型、不懂业务闭环”的常见困境。
一、学习目标:从业务问题到可上线的风控能力
本课程的目标不是让你记住某个算法的公式,而是让你具备独立设计并落地一套电商支付反欺诈系统的能力。具体来说,完成课程后你应当能够:
- 理解业务:说清电商支付链路中的关键节点、资金流向、参与方角色,以及欺诈者如何在这些节点上获利。
- 定义问题:把模糊的“防欺诈”转化为可量化的目标,例如在误杀率可控的前提下降低资损,而不是单纯追求召回率。
- 构建数据与特征:从订单、支付、设备、账户、行为日志中提取有判别力的特征,并处理时间窗口、标签延迟等工程难题。
- 设计策略体系:掌握规则引擎、名单系统、评分卡、机器学习模型与人工审核的分层协作方式。
- 完成工程闭环:能够部署实时决策服务、监控指标、处理误杀申诉,并持续迭代策略。
一句话概括学习目标:用可解释、可监控、可迭代的工程手段,在用户体验与资金安全之间找到动态平衡点。
二、核心概念:先统一语言,再谈技术
反欺诈领域有一套自己的“行话”。如果概念不清,后续讨论规则命中、模型分数和案件复盘时就会各说各话。以下是最核心的几组概念。
| 概念 | 含义 | 在项目中的典型体现 |
|---|---|---|
| 欺诈(Fraud) | 以非法获利为目的,故意利用支付链路漏洞的行为 | 盗卡支付、虚假交易、恶意拒付、套现 |
| 资损(Financial Loss) | 因欺诈成功而实际造成的资金损失 | 拒付金额、退款损失、赔付成本 |
| 误杀(False Positive) | 将正常用户判定为欺诈而拦截 | 正常订单被拒绝,用户流失与客诉 |
| 规则(Rule) | 基于专家经验或统计结论的确定性判断 | 同一设备短时间多账号下单则拦截 |
| 模型分数(Score) | 机器学习模型输出的风险概率或风险等级 | 0~1 的欺诈概率,用于分层决策 |
| 名单(List) | 黑名单、白名单、灰名单等人工维护集合 | 已知欺诈设备直接拒绝,可信用户放行 |
| 决策(Decision) | 综合规则、模型、名单后给出的最终动作 | 通过、拒绝、人工审核、二次验证 |
其中,资损与误杀是一对天然矛盾。拦截越严格,资损越低,但误杀越高;放行越宽松,体验越好,但资损风险上升。反欺诈工程的核心,就是在这条曲线上找到业务可接受的平衡点,而不是追求单一指标的极致。
三、整体框架:一个完整的反欺诈系统长什么样
从工程视角看,电商支付反欺诈系统可以划分为五层。理解这五层,你就理解了后续所有章节的位置。
- 数据接入层:接入订单、支付、账户、设备、行为埋点等数据,完成清洗、对齐与实时/离线分流。
- 特征与画像层:构建用户、设备、IP、商户等多维画像,生成统计特征、时序特征与关系特征。
- 策略与模型层:规则引擎负责确定性拦截,模型负责概率预测,名单系统负责快速处置已知风险。
- 决策引擎层:按优先级编排规则、模型与名单,输出通过、拒绝、审核、验证等动作。
- 监控与运营层:监控资损率、误杀率、命中率、审核效率,支撑策略迭代与案件复盘。
一个常见误区是“先上模型,再补规则”。实际上,规则与名单往往能在项目初期快速止血,模型则用于覆盖规则无法表达的复杂模式。二者是互补关系,不是替代关系。
四、项目实战路线图:从零到一的关键阶段
本课程将以一个模拟电商支付场景为主线,贯穿全部 30 章。整体路线图如下:
阶段一:业务与数据理解
  - 支付链路梳理、欺诈场景分类、标签定义
阶段二:数据探索与特征工程
  - 订单/支付/设备日志清洗、时间窗口特征、用户行为序列
阶段三:规则与名单体系
  - 规则引擎设计、名单管理、规则优先级与冲突处理
阶段四:模型开发与评估
  - 逻辑回归/树模型/集成模型、类别不平衡处理、AUC/KS/PR曲线
阶段五:决策引擎与实时服务
  - 规则+模型融合、在线推理、延迟与吞吐优化
阶段六:监控、复盘与迭代
  - 资损率/误杀率监控、案件复盘、策略灰度与回滚
这条路线图不是线性瀑布,而是带有反馈回路的迭代过程。例如,监控阶段发现某类新型欺诈,可能需要回到特征工程补充新特征,再重新训练模型并更新规则。
五、案例场景:一次典型的盗卡支付是如何被拦截的
假设攻击者窃取了一张信用卡信息,在电商平台下单购买高价值商品。系统在支付请求到达时会依次经过以下判断:
- 名单检查:该卡号或设备是否已在黑名单中?若是,直接拒绝。
- 规则命中:该设备在 10 分钟内关联了 5 个不同账号,且收货地址频繁变更,触发“设备聚集”规则。
- 模型评分:模型综合设备指纹、IP 归属、历史行为、订单金额等特征,输出欺诈概率 0.87。
- 决策融合:规则命中高风险 + 模型高分,决策引擎输出“拒绝并记录案件”。
- 事后复盘:运营人员确认该案件为盗卡,将设备与卡号加入黑名单,并评估规则是否误伤正常用户。
注意:单条规则或单个模型分数都不应直接决定最终动作。真实系统中,决策引擎需要综合多路信号,并设置人工审核兜底,避免因单一信号异常导致大规模误杀。
六、常见误区与学习建议
在正式进入技术细节前,先了解几个高频误区,可以让你少走弯路:
- 误区一:只关注模型指标,忽略业务成本。 AUC 提升 0.01 可能远不如把误杀率降低 0.5% 更有业务价值。
- 误区二:忽视标签延迟。 拒付标签往往在交易后数周才确认,训练集构建必须处理这种延迟。
- 误区三:规则越多越好。 规则膨胀会导致冲突、维护困难和误杀上升,需要定期清理与优先级管理。
- 误区四:上线即结束。 欺诈手法持续演变,没有监控与迭代的反欺诈系统会在数月内失效。
学习建议:每学完一个模块,都回到“资损—误杀—体验”三角中思考它的位置。技术是手段,业务平衡才是目标。
至此,你已经拥有了本课程的全局地图。接下来,我们将从电商支付链路与欺诈场景分类开始,逐步进入数据、特征、规则、模型与工程实现的完整实战。