3. 数据基础与日志体系
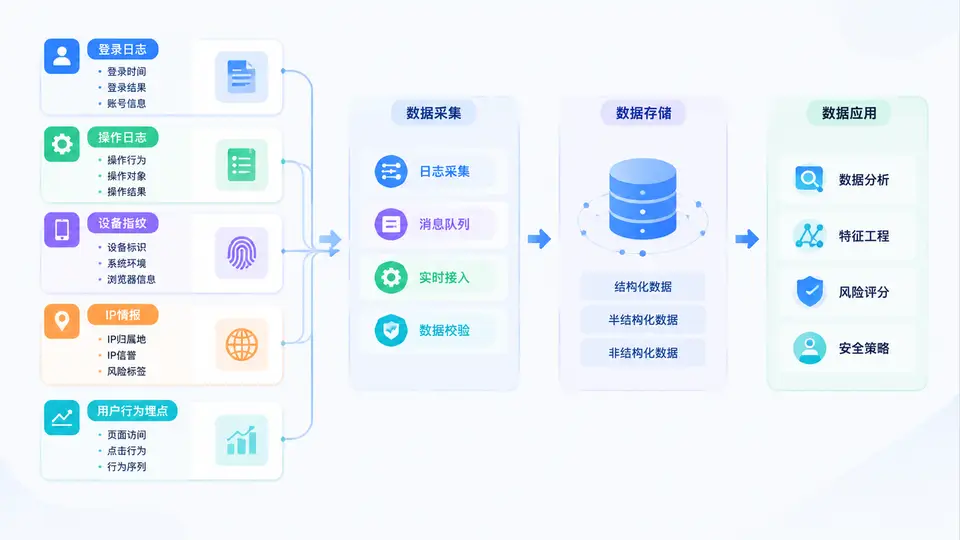
账户接管(ATO)风险评分不是“算法先行”,而是“数据先行”。没有稳定、可追溯、字段语义一致的数据源,再复杂的模型也只能在噪声上做拟合。本章聚焦 ATO 特征工程所依赖的五类核心数据:登录日志、操作日志、设备指纹、IP 情报、用户行为埋点,并给出可落地的采集规范与字段设计原则。
一、核心原理:ATO 检测依赖“身份—环境—行为”三元组
ATO 的本质是攻击者用非法手段获得合法凭证后,冒充真实用户完成登录或敏感操作。因此,任何有效的特征都来自对以下三元组的刻画:
- 身份维度:账号、凭证类型、认证方式、MFA 状态、历史绑定关系。
- 环境维度:设备指纹、IP、ASN、地理、代理/VPN/Tor 属性、TLS 指纹。
- 行为维度:登录时间、频率、失败序列、操作路径、页面停留、输入节奏。
五类数据源分别承担不同职责:登录日志提供“入口事件”,操作日志提供“落点事件”,设备指纹提供“环境稳定性”,IP 情报提供“外部风险上下文”,行为埋点提供“人机差异与意图强度”。它们必须在同一时间轴、同一用户主键下可关联,否则特征无法跨源拼接。
关键原则:ATO 特征的时间窗口通常以“秒—分钟—天”三级展开。登录日志与行为埋点要求秒级精度;设备与 IP 情报要求分钟级更新;操作日志要求与业务事务 ID 对齐。任何数据源缺失统一时间戳与用户主键,都会导致窗口特征失效。
二、五类数据源的字段设计与采集规范
下表给出每类数据源的最小可用字段集与采集要求。实际落地时可按业务扩展,但最小集不可省略。
| 数据源 | 核心字段 | 采集方式 | 更新频率 | 典型 ATO 特征 |
|---|---|---|---|---|
| 登录日志 | user_id、event_time、login_result、auth_method、mfa_flag、device_id、ip、session_id、fail_reason | 服务端埋点,同步写入消息队列 | 实时 | 短时失败次数、异地首登、MFA 绕过、会话复用 |
| 操作日志 | user_id、event_time、action_type、target_id、amount、result、trace_id、device_id、ip | 业务系统 AOP 切面或事务钩子 | 实时/准实时 | 改密后转账、批量导出、异常时段敏感操作 |
| 设备指纹 | device_id、fingerprint_hash、os、browser、canvas_hash、字体列表、时区、语言、首次出现时间 | 前端 SDK + 服务端校验 | 每次会话 | 设备复用率、指纹突变、模拟器/群控识别 |
| IP 情报 | ip、asn、geo、is_proxy、is_vpn、is_tor、risk_score、更新时间 | 第三方情报 API + 本地缓存 | 分钟级/小时级 | 高风险 IP 登录、代理跳变、地理速度异常 |
| 行为埋点 | user_id、session_id、event_time、page、action、dwell_time、input_rhythm、scroll_depth | 前端 SDK 批量上报 | 准实时 | 输入节奏异常、页面停留过短、路径偏离基线 |
三、方法流程:从采集到可关联的日志体系
采集规范的核心不是“记下来”,而是“可关联、可回放、可审计”。建议按以下流程建设:
- 统一事件模型:所有数据源必须包含
user_id、event_time(毫秒级)、device_id、ip、trace_id五个关联键。 - 统一时间标准:服务端统一使用 UTC 毫秒时间戳,前端上报时携带客户端时区偏移,避免跨时区窗口错位。
- 写入消息队列:登录、操作、埋点事件先入 Kafka,再由消费程序分别落库与写入特征存储,保证削峰与可重放。
- 设备指纹服务化:前端采集原始信号,服务端生成稳定
fingerprint_hash,并维护设备—账号绑定关系表。 - IP 情报本地化:高频 IP 走本地缓存,低频或未知 IP 调用外部情报,结果回写缓存并记录版本号。
- 特征回填与校验:离线任务按小时回填窗口特征,与实时特征做一致性比对,偏差超过阈值触发告警。
{
  "event_type": "login",
  "user_id": "u_10293",
  "event_time": 1717041600123,
  "device_id": "d_88f3a1",
  "ip": "203.0.113.45",
  "login_result": "success",
  "auth_method": "password",
  "mfa_flag": false,
  "session_id": "s_9f2c",
  "trace_id": "t_7a1b"
}采集规范要点:登录日志必须记录失败原因枚举(密码错误、验证码错误、MFA 失败、账号锁定),否则无法区分“撞库”与“真实用户忘记密码”。操作日志必须携带业务事务 ID,便于将“改密—转账—提现”串联为同一攻击链。
四、案例与场景:一次典型 ATO 的数据链路复盘
某电商平台发现一批账号在凌晨被登录后立即发起提现。复盘数据链路如下:
- 登录日志:同一 IP 段在 3 分钟内登录 47 个账号,全部
login_result=success,mfa_flag=false。 - 设备指纹:47 次登录的
fingerprint_hash仅 3 个,且均为首次出现的新设备。 - IP 情报:该 IP 段被标记为
is_proxy=true,risk_score=92。 - 操作日志:登录后 20 秒内触发
withdraw,金额接近账户余额上限。 - 行为埋点:页面停留时间中位数 1.2 秒,输入节奏方差极低,明显偏离真人基线。
若缺少设备指纹或行为埋点,仅靠登录日志只能看到“成功登录”,无法识别群控特征;若缺少 IP 情报,则无法解释“为何同一 IP 高频登录”是代理而非正常办公网络。五类数据源在此形成完整证据链。
五、误区与复盘:采集规范中最容易犯的错
误区一:只采集不治理。字段命名不一致(如 userId 与 user_id 混用)、时间戳单位不统一(秒与毫秒混存),会导致跨源关联失败。必须在采集入口做 schema 校验。
误区二:设备指纹过度依赖前端。前端可被篡改,必须结合服务端 TLS 指纹、HTTP 头顺序等信号做交叉验证,否则群控可批量伪造 device_id。
误区三:IP 情报只查不缓存。每次登录都调用外部 API 会造成延迟与成本失控,且情报版本不一致会导致特征漂移。应本地缓存并记录情报版本号。
误区四:行为埋点采集过细。采集键盘每个按键会带来隐私合规风险。应采集节奏统计量(如输入间隔方差)而非原始按键内容。
复盘结论:ATO 特征工程的数据基础,重点不在“数据量”,而在“关联键完整、时间标准统一、字段语义稳定、采集合规”。只有这四点成立,后续的窗口特征、图特征与模型评分才有可靠输入。