3. 指纹生成与稳定性
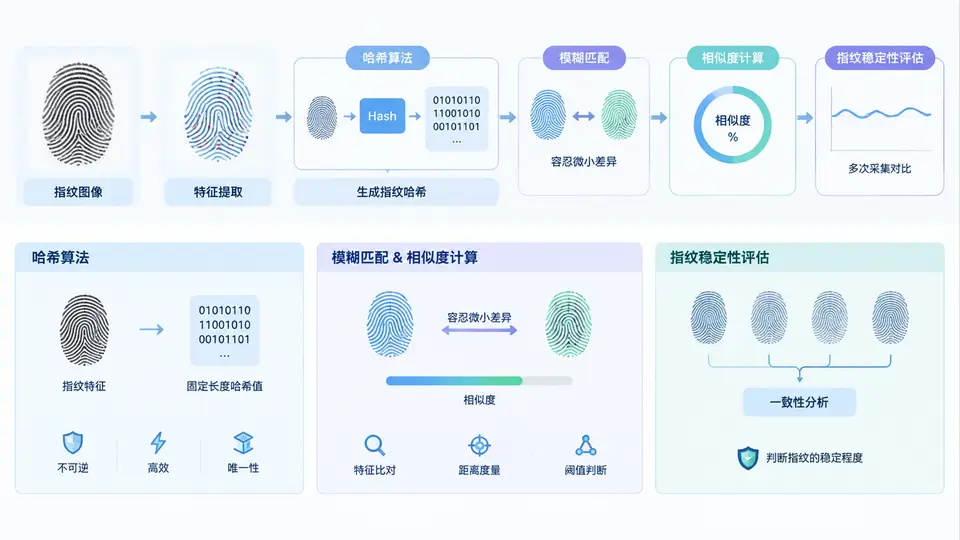
设备指纹的生成不是“把采集字段拼起来做一次哈希”这么简单。真正可用的指纹系统,需要在唯一性、稳定性、可解释性三者之间取得平衡。本节聚焦指纹生成的核心算法与稳定性评估方法,帮助你建立从原始特征到稳定指纹的完整工程链路。
一、核心原理:哈希、模糊匹配与相似度
指纹生成通常分为两个阶段:特征编码与指纹聚合。特征编码把设备属性(如屏幕分辨率、时区、字体列表、Canvas 渲染结果)转换为可比较的向量或字符串;指纹聚合则通过哈希或相似度计算生成最终标识。
哈希算法在指纹中承担两种角色:一是确定性压缩,如 SHA-256 将任意长度特征串映射为固定长度摘要;二是局部敏感哈希(LSH),如 SimHash 或 MinHash,使相似输入产生相近哈希值,从而支持模糊匹配。普通哈希对输入极其敏感,一个字符变化就会导致摘要完全不同,因此不适合直接用于“允许轻微漂移”的设备识别场景。
模糊匹配与相似度计算解决的是“同一设备因环境变化导致指纹轻微变化”的问题。常用方法包括:
- Jaccard 相似度:适合集合型特征,如字体列表、插件列表。
- 余弦相似度:适合数值向量,如 Canvas 像素统计、WebGL 参数向量。
- 编辑距离:适合字符串型特征,如 User-Agent 片段。
- SimHash 汉明距离:适合高维稀疏特征,计算效率高。
二、方法流程:从特征到稳定指纹
一个可落地的指纹生成流程通常包含以下步骤:
- 特征分组:将特征分为强稳定组(如 GPU 型号、平台架构)、中稳定组(如屏幕分辨率、时区)、弱稳定组(如 Canvas 噪声、字体渲染差异)。
- 归一化处理:对数值做分桶,对字符串做小写化与去版本号,对集合做排序去重。
- 分组哈希:每组独立计算哈希,避免单点变化污染整体指纹。
- 相似度聚合:对弱稳定组使用 SimHash 或 MinHash,生成可比较的局部指纹。
- 稳定性评分:基于历史观测计算每个特征的漂移率,动态调整权重。
- 指纹输出:生成主指纹(强稳定组哈希)与辅助指纹(相似度向量),共同用于匹配。
下面是一个简化的 Python 示例,展示分组哈希与 SimHash 的基本实现思路:
import hashlib
from simhash import Simhash

def group_hash(features):
    # 强稳定组:直接 SHA-256
    strong = "|".join(sorted(features["strong"]))
    strong_hash = hashlib.sha256(strong.encode()).hexdigest()[:16]

    # 弱稳定组:SimHash
    weak_tokens = features["weak"]
    weak_simhash = Simhash(weak_tokens).value

    return {
        "strong_hash": strong_hash,
        "weak_simhash": weak_simhash
    }

# 示例输入
features = {
    "strong": ["gpu:apple-m1", "platform:macos", "arch:arm64"],
    "weak": ["canvas:abc123", "font:arial", "font:helvetica", "tz:asia/shanghai"]
}
print(group_hash(features))
输出中,strong_hash用于精确匹配,weak_simhash用于计算汉明距离。当汉明距离小于阈值(如 3)时,可判定为同一设备。
三、案例/场景:浏览器指纹的稳定性评估
假设你正在为一个风控系统设计浏览器指纹。采集字段包括:User-Agent、屏幕分辨率、时区、语言、Canvas 哈希、WebGL 渲染器、字体列表。你需要评估这些字段在 30 天内的稳定性。
评估方法如下:
- 对同一设备每天采集一次指纹,记录各字段值。
- 计算每个字段的漂移率:字段值发生变化的次数 / 总观测次数。
- 计算整体指纹的匹配准确率:在允许相似度阈值下,正确关联同一设备的比例。
- 绘制稳定性曲线,识别哪些字段是“噪声源”。
下表是一个模拟评估结果,展示了各字段的漂移率与建议权重:
| 特征字段 | 漂移率 | 稳定性等级 | 建议权重 |
|---|---|---|---|
| GPU 型号 | 0.02 | 高 | 0.25 |
| 平台架构 | 0.01 | 高 | 0.20 |
| 屏幕分辨率 | 0.08 | 中 | 0.15 |
| 时区 | 0.12 | 中 | 0.10 |
| Canvas 哈希 | 0.35 | 低 | 0.10 |
| 字体列表 | 0.28 | 低 | 0.10 |
| User-Agent | 0.45 | 低 | 0.10 |
四、误区/复盘:稳定性评估中的常见陷阱
在实际工程中,以下误区会直接导致指纹系统失效:
- 误区一:追求绝对唯一性而忽略稳定性。 把 Canvas 噪声、随机种子等易变特征作为主指纹,会导致同一设备每天生成不同 ID。
- 误区二:只用单一哈希。 对全部特征做一次 SHA-256,任何字段变化都会导致指纹完全改变,无法模糊匹配。
- 误区三:相似度阈值拍脑袋。 阈值过高会误合并不同设备,阈值过低会漏匹配同一设备。应基于历史数据绘制 ROC 曲线确定阈值。
- 误区四:忽略特征采集时间。 同一设备在不同时间采集的特征可能因系统更新而变化,评估时必须对齐时间窗口。
稳定性评估的最终目标,是让指纹系统在“设备不变”时保持高匹配率,在“设备变化”时仍能通过相似度关联,而在“不同设备”之间保持足够区分度。这需要哈希算法、相似度计算与权重策略三者协同,而非依赖单一技术点。