3. 数据采集与预处理
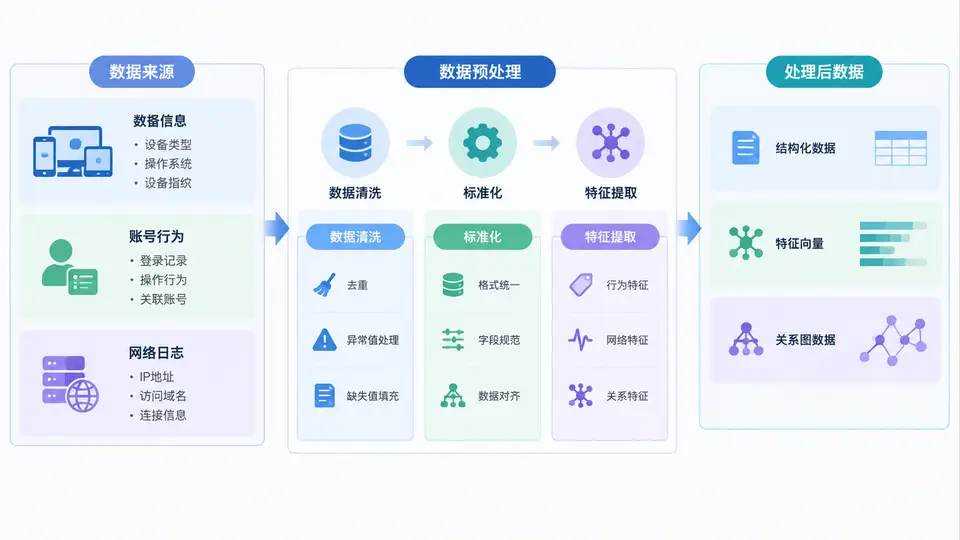
设备关系图谱与多账号团伙识别的效果,七成取决于数据底座。设备指纹、账号行为、网络日志三类数据分别回答“这是哪台机器”“这个账号做了什么”“它和谁通信”,只有把三者对齐到统一实体与时间轴上,图谱才能稳定表达团伙关系。本节围绕数据来源、清洗、标准化与特征提取四个环节展开,并给出可落地的工程方法。
一、核心原理:三类数据源与实体对齐
设备信息通常来自客户端 SDK、浏览器指纹、系统 API 与风控探针,核心字段包括设备 ID、IMEI/OAID/IDFA、MAC、机型、系统版本、分辨率、传感器特征、Root/越狱状态、模拟器标识等。账号行为来自注册、登录、改密、绑卡、下单、发帖等业务埋点,核心字段是账号 ID、事件类型、时间戳、IP、设备 ID、渠道、结果码。网络日志来自网关、代理、DNS、CDN 与安全设备,核心字段是源 IP、目的 IP、端口、协议、UA、请求路径、响应码、流量大小。
三类数据的关联键是“账号—设备—IP—时间”。设备 ID 是强关联键,但存在被篡改或重置的风险;IP 是弱关联键,受 NAT、代理、基站切换影响;时间窗口是约束条件,同一设备在极短时间内切换多个账号,或同一账号在极短时间内切换多台设备,都是团伙信号。实体对齐的目标是生成统一的 entity_id,把设备、账号、IP 映射到同一张图上。
核心原则:先做实体归一,再做关系计算。没有统一实体 ID,后续图谱会出现大量重复节点和虚假边,团伙识别准确率会显著下降。
二、方法流程:采集、清洗、标准化、特征提取
完整流程可分为五步:采集接入、数据清洗、标准化、特征提取、质量校验。每一步都需要可观测指标,否则脏数据会静默污染图谱。
- 采集接入:客户端埋点采用批量上报与实时上报结合,服务端日志通过 Kafka、Flume 或 Filebeat 采集,网络日志通过镜像流量或 NetFlow 获取。采集时保留原始字段与采集时间,便于回溯。
- 数据清洗:处理缺失值、重复值、异常值与格式错误。例如设备 ID 为空、时间戳为未来时间、IP 格式非法、UA 为空等。
- 标准化:统一时间格式为 UTC 毫秒时间戳,统一 IP 为 IPv4/IPv6 规范格式,统一设备 ID 大小写与哈希算法,统一账号 ID 的命名空间。
- 特征提取:从原始字段派生统计特征、时序特征、图特征与文本特征,如设备关联账号数、账号登录频次、IP 段聚集度、UA 相似度等。
- 质量校验:监控字段完整率、实体对齐率、重复率、时间偏差,设置阈值告警。
下面是一段典型的数据清洗与标准化伪代码,展示如何把原始记录转换为统一实体:
def normalize_record(raw):
    # 1. 时间标准化
    ts = parse_time(raw.get("event_time"))
    if ts is None or ts > now_ms() + 300000:
        return None  # 丢弃未来时间或非法时间

    # 2. 设备 ID 归一
    device_id = raw.get("device_id", "").strip().lower()
    if not device_id:
        device_id = fallback_fingerprint(raw)  # 用机型+系统+分辨率生成兜底指纹
    device_id = sha256(device_id)

    # 3. IP 标准化
    ip = normalize_ip(raw.get("ip"))
    if ip is None:
        return None

    # 4. 账号 ID 命名空间
    account_id = f"acct:{raw.get('app_id')}:{raw.get('account_id')}"

    return {
        "entity_device": f"dev:{device_id}",
        "entity_account": account_id,
        "entity_ip": f"ip:{ip}",
        "event_type": raw.get("event_type"),
        "ts": ts,
        "channel": raw.get("channel", "unknown")
    }
三、特征提取:从字段到团伙信号
特征提取要围绕“设备—账号—IP”关系展开,常见特征可分为四类:
| 特征类别 | 示例特征 | 团伙识别意义 |
|---|---|---|
| 设备聚合特征 | 设备关联账号数、设备关联 IP 数、设备首次出现时间 | 一机多号、新设备批量注册 |
| 账号行为特征 | 登录频次、注册到首单时长、改密次数、操作间隔方差 | 机器化操作、异常节奏 |
| 网络环境特征 | IP 段聚集度、ASN 分布、代理标识、DNS 请求模式 | 同一代理池、同一机房 |
| 图结构特征 | 节点度、社区发现、连通分量大小、边权重 | 团伙规模与核心节点 |
以“一机多号”为例,可计算设备维度账号数 account_cnt_per_device,若某设备在 24 小时内关联超过 5 个新注册账号,且这些账号的注册 IP 落在同一 /24 网段,则形成高置信团伙边。再结合账号行为特征,如注册后 1 分钟内发起登录、登录后立即下单,可进一步区分正常多账号与恶意团伙。
工程建议:特征提取尽量在离线数仓完成宽表构建,在线侧只做轻量拼接与实时更新。设备关系图谱的边权重可设计为“设备—账号”共现次数、“账号—IP”共现次数、“设备—IP”共现次数,再通过时间衰减函数降低历史行为影响。
四、案例与误区复盘
某电商风控团队曾遇到“同一设备关联 200 个账号”的告警,初期直接判定为团伙,但复盘发现该设备是商场体验机,被大量真实用户轮流使用。问题出在数据采集阶段没有区分“设备所有者”与“设备使用者”,且未引入时间窗口和地理围栏。修正方案是:对体验机、公共设备打标,在特征中加入“设备类型”与“登录地点稳定性”,并将设备—账号边的时间窗口缩短到 30 分钟。调整后误报率下降约 60%。
常见误区还包括:
- 只清洗不标准化:设备 ID 大小写不一致、IP 带端口、时间戳时区混乱,导致同一实体被拆成多个节点。
- 过度依赖单一字段:仅用 IMEI 或 MAC 做关联,遇到篡改或重置就失效,应结合多指纹与行为特征。
- 忽略数据时效:设备关系会随时间变化,长期不衰减的边权重会让图谱越来越“粘”,影响新团伙发现。
- 特征穿越:离线训练时使用了未来信息,如用“最终是否封禁”反推注册时的特征,导致线上效果骤降。
复盘要点:数据采集与预处理不是一次性任务,而是持续迭代的管道。每次团伙识别效果波动,都应先检查实体对齐率、字段完整率和时间偏差,再怀疑模型或规则。