1. 课程导入
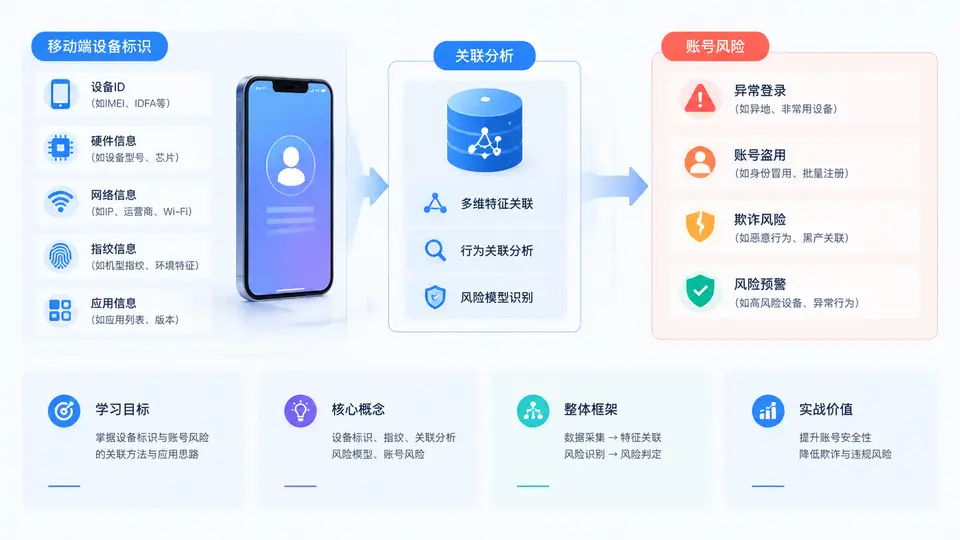
在移动端风控与反欺诈工作中,账号往往只是“表面身份”,设备才是更稳定的“物理载体”。黑产可以批量注册账号、频繁更换昵称与头像,却很难在短时间内彻底改变设备指纹、系统参数、网络环境与行为习惯。因此,把设备标识与账号行为关联起来,是识别批量注册、盗号登录、营销作弊、支付欺诈等风险的关键切入点。本课程面向风控研发、数据分析、安全运营与反欺诈策略人员,围绕“设备标识如何采集、如何稳定、如何与账号风险关联、如何落地为策略与模型”展开,共 30 章,从概念到工程实现逐步推进。
一、学习目标:从“看懂标识”到“落地关联”
完成本课程后,你应当具备四项可验证的能力。第一,能够解释移动端设备标识的层次结构,区分硬件标识、系统标识、应用级标识与可重置标识,并说明各自的稳定性与合规边界。第二,能够设计一套设备指纹采集与生成方案,在 Android 与 iOS 上处理权限限制、系统版本差异与厂商定制问题。第三,能够把设备维度与账号维度进行关联建模,构建“设备—账号—行为—环境”的关联图谱,并输出可解释的风险特征。第四,能够把关联结果转化为风控策略、规则引擎配置与模型特征,并通过日志与指标持续复盘误报与漏报。
核心判断标准:一个设备标识方案是否合格,不取决于它能否“唯一识别每一台设备”,而取决于它在业务可接受的稳定性、可重置性与合规性之间是否取得平衡,并且能否支撑账号风险关联的决策。
二、核心概念:设备标识不是单一 ID,而是一组证据
移动端设备标识通常分为四层。第一层是硬件与系统级标识,例如 Android 的 Build 属性、CPU 架构、屏幕参数、传感器列表,iOS 的硬件型号、系统版本、部分系统能力开关。这类信息稳定性高,但受权限与隐私政策限制,不能直接作为唯一 ID。第二层是应用级标识,例如应用安装后生成的 UUID、Keychain 或 SharedPreferences 中持久化的值。它们可被清除或重置,但在同一安装周期内稳定。第三层是网络与环境标识,例如 IP、Wi-Fi 名称、基站信息、代理与 VPN 特征。第四层是行为标识,例如点击节奏、输入习惯、页面停留分布。四层证据组合后,才能形成可用的设备指纹。
账号风险关联的核心,是建立“设备—账号”的多对多关系。一个设备可以登录多个账号,一个账号也可以在多台设备上出现。风险往往藏在关系结构里:同一设备短时间注册大量账号,或同一账号在异常设备集合中频繁切换,都是典型信号。因此,设备标识不是孤立字段,而是关联图谱中的节点属性。
| 标识层次 | 典型来源 | 稳定性 | 可重置性 | 主要风险用途 |
|---|---|---|---|---|
| 硬件/系统级 | Build 属性、硬件型号、屏幕与传感器 | 高 | 低 | 设备聚类、模拟器识别 |
| 应用级 | UUID、Keychain、本地存储 | 中 | 中 | 安装级追踪、账号绑定 |
| 网络环境 | IP、Wi-Fi、基站、代理特征 | 低 | 高 | 团伙聚集、地理位置异常 |
| 行为特征 | 点击、输入、滑动节奏 | 中 | 低 | 机器行为识别、盗号检测 |
三、整体框架:采集、生成、关联、决策、复盘
本课程的整体框架可以概括为一条闭环流水线。第一步是采集,在合规前提下获取设备与账号相关字段,并处理权限拒绝与字段缺失。第二步是生成,把原始字段归一化、哈希化、分桶,生成稳定的设备指纹 ID。第三步是关联,把设备 ID 与账号 ID、行为事件、网络环境写入关联存储,形成可查询的关系网络。第四步是决策,基于关联特征输出风险分、规则命中与处置建议。第五步是复盘,通过日志、指标与样本回查,持续修正指纹算法与策略阈值。
设备指纹生成伪代码示例:
raw = collect_device_fields()
normalized = normalize(raw)          # 去除版本噪声、统一大小写
hashed = stable_hash(normalized)     # 对关键字段加盐哈希
device_id = bucketed_fingerprint(hashed, version="v2")
relation = link(device_id, account_id, event_time, network_env)
risk_score = evaluate(relation, rules, model)
log_decision(device_id, account_id, risk_score, action)
工程建议:设备指纹算法必须带版本号。每次调整字段权重或哈希方式,都应保留旧版本一段时间,避免历史关联断裂导致策略误判。
四、案例与场景:关联视角如何发现单点看不到的风险
场景一:营销活动作弊。单看账号,每个账号都像正常新用户;但把设备 ID 聚合后,发现同一设备在 10 分钟内注册了 30 个账号,且 IP 段集中、行为节奏高度相似。此时设备关联直接暴露团伙特征。场景二:盗号登录。账号本身历史正常,但登录设备从未出现过,且该设备同时关联多个异常账号,网络环境使用代理。设备关联为盗号判定提供强证据。场景三:支付欺诈。同一设备在短时间内切换多个账号发起小额支付,单账号金额不高,但设备维度呈现集中攻击。场景四:模拟器与群控。硬件字段异常、传感器缺失、Build 属性矛盾,结合行为特征可识别自动化环境。
这些场景的共同点是:账号维度信息不足,设备维度提供交叉验证。风控策略如果只依赖账号历史,很容易被“养号”绕过;引入设备关联后,攻击成本显著上升。
五、误区与复盘:避免把设备 ID 当成“绝对真相”
常见误区有四个。第一,追求绝对唯一。移动端隐私限制越来越强,任何单一 ID 都可能被重置或伪造,正确做法是多证据融合与置信度分级。第二,忽略合规边界。采集设备信息必须遵循最小必要原则,明确告知与授权,避免触碰隐私红线。第三,不做版本管理。指纹算法一旦变更,历史关联可能断裂,必须保留版本与灰度切换。第四,只看设备不看行为。设备可以被模拟,行为节奏与关系结构更难伪装,二者结合才可靠。
复盘要点:当策略误报升高时,优先检查设备指纹是否因系统升级、权限变更或算法调整而漂移;当漏报升高时,优先检查黑产是否通过重置应用数据、改机工具或代理网络规避了原有字段。