3. 核心概念解析
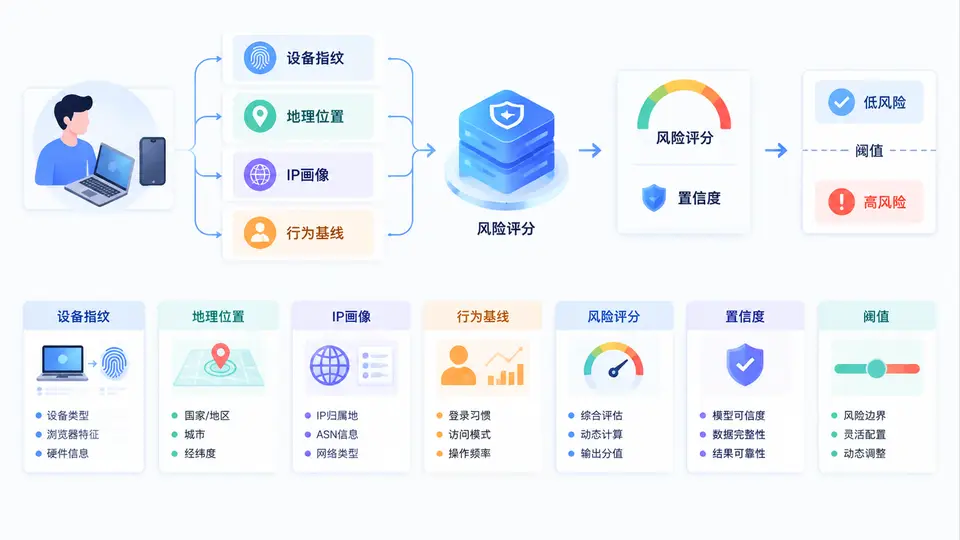
在构建新设备与新地点登录风险评分系统之前,必须先厘清七个基础概念。它们不是孤立术语,而是一条从“采集信号”到“输出决策”的完整链路。理解每个概念的定义、边界与相互关系,才能避免后续建模时把不同层次的信息混为一谈。
一、核心原理:从原始信号到风险决策
风险评分的本质,是把多源弱信号聚合成一个可比较、可解释、可执行的数值。设备指纹回答“这是哪台设备”,地理位置回答“从哪里来”,IP画像回答“这个网络出口是否可疑”,行为基线回答“这个人的正常模式是什么”。四者构成输入层;风险评分是聚合层;置信度与阈值则是决策层。
一句话理解:设备指纹、地理位置、IP画像、行为基线是“证据”,风险评分是“判决建议”,置信度是“判决的把握程度”,阈值是“执行动作的开关”。
二、七个概念的基本定义
| 概念 | 基本定义 | 典型输出 | 常见误区 |
|---|---|---|---|
| 设备指纹 | 通过浏览器、系统、硬件、网络等特征组合,稳定标识一台设备 | device_id、指纹相似度 | 认为指纹永久不变 |
| 地理位置 | 登录发生时的物理或网络位置,含经纬度、城市、精度半径 | 城市、坐标、距离 | 把IP定位当精确GPS |
| IP画像 | 对IP的属性刻画:运营商、代理、IDC、历史风险、共享程度 | IP风险标签、信誉分 | 只看IP是否黑名单 |
| 行为基线 | 用户历史登录、操作、时间、频率的统计正常范围 | 均值、方差、分位数 | 用全局基线替代个人基线 |
| 风险评分 | 将多特征映射为统一量纲的风险数值,通常0~100或0~1 | risk_score | 把评分当概率 |
| 置信度 | 对当前判断准确性的把握,反映数据完整性与模型稳定度 | confidence | 与风险评分混为一谈 |
| 阈值 | 触发不同处置动作的评分分界点 | 放行、验证、拦截 | 一刀切固定阈值 |
三、方法流程:概念如何协同工作
一次新设备新地点登录的评分流程可以拆成五步:
- 采集:获取设备指纹、IP、地理位置、时间、账号历史行为。
- 比对:判断设备是否首次出现、地点是否偏离常用范围、IP是否属于高风险网段。
- 打分:各特征按权重贡献分数,形成原始风险评分。
- 校准:根据数据完整度和模型历史表现计算置信度。
- 决策:结合置信度与阈值,选择放行、二次验证或拦截。
risk_score = w1 * device_novelty
           + w2 * geo_distance_score
           + w3 * ip_reputation_score
           + w4 * behavior_deviation

confidence = f(data_completeness, model_stability, signal_agreement)

if risk_score >= threshold_high and confidence >= min_confidence:
    action = "block"
elif risk_score >= threshold_mid:
    action = "challenge"
else:
action = "allow"这段伪代码揭示了关键点:风险评分高不等于一定拦截,还要看置信度是否足够。如果数据缺失严重,即使评分很高,也可能只触发验证而非直接拦截。
四、案例/场景:新设备新地点登录
假设用户张三平时在北京用一台Windows笔记本登录,某天凌晨3点,一台全新的Mac设备从新加坡IP登录,且该IP被标记为数据中心代理。系统各维度表现如下:
- 设备指纹:完全陌生,device_novelty = 0.9
- 地理位置:北京到新加坡,距离约4500公里,geo_distance_score = 0.85
- IP画像:IDC代理,信誉分低,ip_reputation_score = 0.8
- 行为基线:凌晨3点非活跃时段,behavior_deviation = 0.7
若权重分别为0.3、0.25、0.25、0.2,则风险评分为:
risk_score = 0.3*0.9 + 0.25*0.85 + 0.25*0.8 + 0.2*0.7
           = 0.27 + 0.2125 + 0.2 + 0.14
           = 0.8225  (约82分)
此时若高阈值设为80,且置信度为0.9,系统应直接拦截或强制二次验证。但如果设备指纹采集失败、地理位置仅能定位到国家级别,置信度可能只有0.5,此时更合理的动作是要求短信或人脸验证,而不是直接封禁。
教学提示:新设备与新地点同时出现时,风险不是简单相加,而是存在耦合放大效应。很多系统会对“新设备+新地点”组合额外加权,因为单独一个新设备可能只是换手机,单独一个新地点可能只是出差,两者同时发生则异常概率显著上升。
五、误区与复盘
误区一:把风险评分当概率。风险评分82分不代表82%的概率是攻击,它只是模型输出的相对风险量纲。概率需要经过校准,而评分通常未校准。
误区二:忽略置信度。低置信度下的高分往往意味着数据缺失或模型不确定,直接拦截会误伤大量正常用户。置信度低时,应优先选择挑战式验证。
误区三:阈值长期不变。业务淡旺季、用户行为迁移、攻击手法变化都会影响评分分布。阈值应定期基于历史数据回测调整,而不是一次设定永久使用。
误区四:行为基线用全局代替个人。全局基线会把夜班用户、跨国出差用户误判为异常。行为基线必须尽量个性化,至少按用户或用户群分层。
复盘要点:当拦截率上升但投诉率也上升时,优先检查置信度是否被忽略、阈值是否过低、行为基线是否过于粗糙。风险评分系统的目标不是“抓出所有异常”,而是在可接受的误伤范围内,把高风险事件识别出来。
六、概念关系小结
设备指纹、地理位置、IP画像、行为基线是四个输入维度,它们各自有噪声和盲区。风险评分负责融合,置信度负责标注可信程度,阈值负责把连续分数转成离散动作。四者缺一不可:没有置信度的评分是盲目的,没有阈值的评分是无法执行的,没有多源输入的评分是脆弱的。