3. 图数据表示
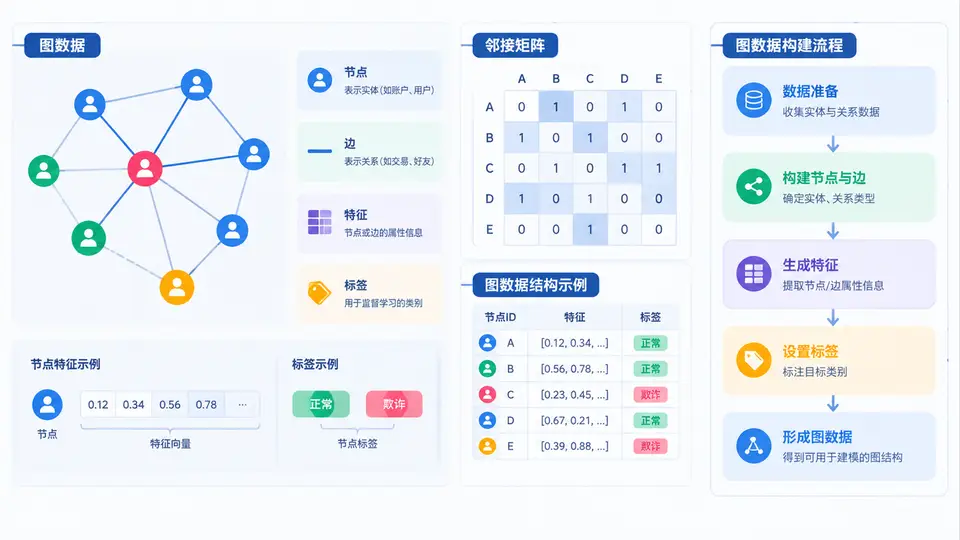
在欺诈检测任务中,图神经网络能否发挥作用,首先取决于我们是否把业务对象和它们之间的关系正确地表达成图。图数据表示不是简单的数据格式转换,而是把“谁和谁有关、关系有多强、每个对象有什么属性、哪些对象已知是欺诈”这些业务语义,映射为节点、边、特征、标签和邻接矩阵。只有表示正确,后续的消息传递、节点分类和阈值优化才有意义。
核心原理:图由什么构成
一张图通常记为 G = (V, E)。其中 V 是节点集合,E 是边集合。在欺诈场景中,节点可以表示用户、商户、设备、银行卡、IP 地址或订单;边可以表示转账、登录、共享设备、同收货地址等关系。每个节点还可以带一个特征向量 x_i,每个节点还可能有一个标签 y_i,例如 0 表示正常,1 表示欺诈。
邻接矩阵 A 是图结构的数值化表达。对于无向图,若节点 i 与 j 之间有边,则 A[i][j] = A[j][i] = 1,否则为 0。对于带权图,矩阵元素可以表示交易金额、频次或相似度。节点特征矩阵 X 的第 i 行对应节点 i 的特征,标签向量 y 则只对部分节点已知,这正是半监督节点分类的典型设定。
方法流程:从原始数据到可训练图
构建图数据通常遵循以下流程:
- 确定节点类型:明确预测目标是谁。若预测用户是否欺诈,则用户是主节点;设备、IP 可作为辅助节点或特征来源。
- 定义边关系:根据业务规则建立边,例如“用户 A 向用户 B 转账”“用户与设备在同一时间登录”。边可以是有向、无向、带权或带时间戳。
- 抽取节点特征:包括数值特征、类别特征、统计特征和图结构特征,如注册时长、交易金额均值、入度、出度、PageRank 等。
- 标注标签:将已确认的欺诈样本标为 1,正常样本标为 0,未标注样本保留为未知,用于半监督学习。
- 构建邻接矩阵与特征矩阵:将边列表转为稀疏邻接矩阵,将特征表转为
X,并保证节点索引一致。 - 划分数据集:按时间或随机方式划分训练、验证、测试节点,避免标签泄漏。
下面是一个使用 PyTorch Geometric 构建图数据的简化示例:
import torch
from torch_geometric.data import Data

# 边列表:每一列是一条边 (source, target)
edge_index = torch.tensor([
    [0, 1, 1, 2, 3, 4],
    [1, 0, 2, 1, 4, 3]
], dtype=torch.long)

# 节点特征:5 个节点,每个节点 3 维特征
x = torch.tensor([
    [0.2, 1.0, 0.0],
    [0.9, 0.1, 1.0],
    [0.4, 0.7, 0.2],
    [0.1, 0.3, 0.8],
    [0.8, 0.6, 0.5]
], dtype=torch.float)

# 标签:-1 表示未知,0 正常,1 欺诈
y = torch.tensor([0, 1, -1, 0, 1], dtype=torch.long)

# 训练/验证/测试掩码
train_mask = torch.tensor([True, True, False, False, False])
val_mask   = torch.tensor([False, False, True, False, False])
test_mask  = torch.tensor([False, False, False, True, True])

data = Data(x=x, edge_index=edge_index, y=y,
            train_mask=train_mask,
            val_mask=val_mask,
            test_mask=test_mask)

print(data)
运行后可以看到 Data 对象中包含节点数、边数、特征维度等信息。实际工程中,边列表往往来自 Hive 表或图数据库,特征来自特征平台,标签来自风控案件库,最终通过 ETL 统一到节点 ID 空间。
案例/场景:交易欺诈图构建
假设我们要预测用户是否参与欺诈交易。可以构建一张异构图:用户节点、设备节点、IP 节点、商户节点。用户与用户之间有转账边,用户与设备之间有登录边,用户与商户之间有消费边。主节点是用户,标签是是否欺诈。设备节点和 IP 节点没有标签,但可以通过消息传递把风险信号传给用户。
| 图元素 | 业务含义 | 数据示例 | 注意事项 |
|---|---|---|---|
| 节点 | 用户、设备、商户、IP | user_id=1001 | 需统一 ID 映射,避免冲突 |
| 边 | 转账、登录、消费 | 1001 -> 2003 | 区分方向、权重和时间 |
| 特征 | 注册时长、交易频次、设备数 | [0.2, 1.0, 0.0] | 训练与推理特征口径一致 |
| 标签 | 是否欺诈 | 1 / 0 / 未知 | 未知不能当负样本 |
| 邻接矩阵 | 节点连接关系 | A[i][j]=1 | 大规模图用稀疏存储 |
误区与复盘
- 把未知标签当负样本:未标注节点可能只是尚未被发现欺诈,直接标 0 会引入噪声,应使用掩码或半监督策略。
- 节点索引与特征行不对齐:边列表中的 ID 必须映射为连续整数索引,否则消息会传到错误节点。
- 忽略时间泄漏:用未来交易构建的边预测过去节点,会导致离线指标虚高,应按时间切分图。
- 边定义过粗:所有关系都建成同一种边,会稀释风险信号,应区分关系类型或使用异构图。
- 邻接矩阵过密:全连接或高频关系会导致计算爆炸,需要采样、截断或加权。
总结来说,图数据表示是把业务关系转化为可计算结构的第一步。节点定义预测对象,边定义信息传播路径,特征提供个体描述,标签提供监督信号,邻接矩阵承载结构信息。只有这些元素在索引、时间、语义上保持一致,图神经网络才能稳定地学习欺诈模式,并为后续阈值优化提供可靠基础。