1. 课程导入
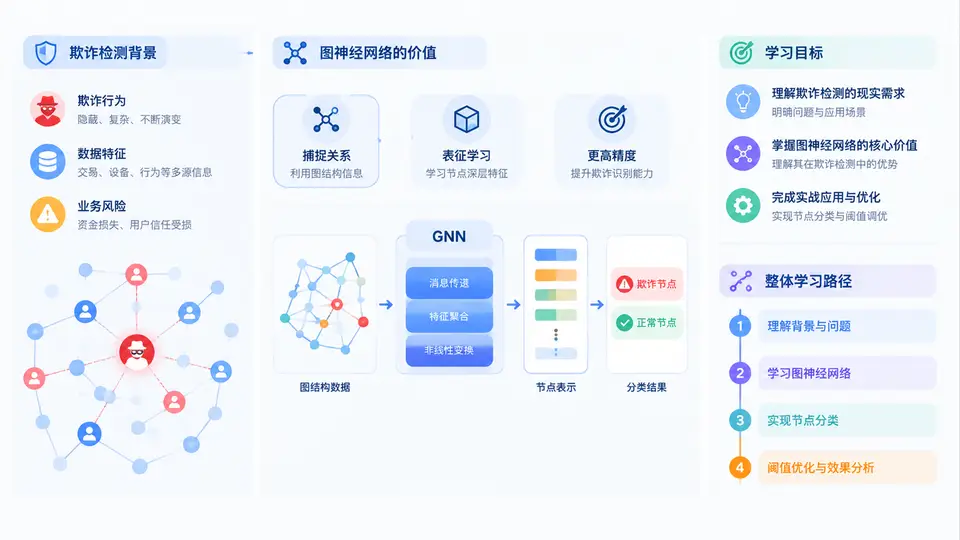
在真实的互联网业务中,欺诈行为从来不是孤立事件。无论是电商刷单、金融盗刷、营销薅羊毛,还是虚假账号批量注册,欺诈者往往会通过多个账号、设备、IP、银行卡、收货地址等实体相互关联,形成一张隐蔽而复杂的“欺诈网络”。传统基于单条样本的机器学习模型,通常把每个用户或每笔交易当作独立个体,只依赖该样本自身的特征进行判断,因此很难捕捉“这伙人彼此关联”“这个账号和已知黑产共享设备”这类关键信号。图神经网络(Graph Neural Network,GNN)正是为解决这类关系型问题而生:它把实体建模为节点,把实体之间的交互建模为边,通过消息传递机制聚合邻居信息,从而让模型在判断一个节点是否欺诈时,能够同时利用该节点自身的特征和它在网络中的结构位置。
为什么欺诈检测天然适合图方法
欺诈检测的核心难点可以归纳为三点:第一,标签极度不平衡,欺诈样本通常只占万分之一到千分之一;第二,欺诈模式持续对抗演化,规则和单点特征很快失效;第三,欺诈者会刻意伪装个体特征,但难以完全隐藏关系结构。图方法的价值恰好体现在第三点:即使一个账号的资料看起来非常“正常”,只要它与多个已知欺诈账号共享设备指纹或收款账户,图模型就能通过邻居聚合提高其风险评分。换句话说,图神经网络把“孤立的异常检测”升级为“上下文中的风险传播”。
下面这张图展示了从原始交易数据到图结构,再到GNN欺诈节点分类的基本流程。它帮助我们在进入具体算法之前,先建立整体认知:数据如何变成图,图如何被模型学习,输出又如何服务于风控决策。
课程目标与整体学习路径
本课程不是单纯讲解GNN公式,而是围绕“欺诈节点分类”这一真实任务,构建一条从数据到决策的完整工程链路。学完本课程,你应该能够独立完成以下工作:把业务数据构建成异构图或同构图;选择合适的GNN模型进行节点分类;处理极端类别不平衡;在验证集上优化分类阈值;并用业务指标解释模型效果。整体学习路径分为四个阶段:
- 基础与数据阶段:理解欺诈检测问题定义、图的基本概念、节点分类任务形式,完成图数据构建与特征工程。
- 模型与训练阶段:掌握GCN、GraphSAGE、GAT等主流GNN的原理与实现,理解消息传递、邻居采样、多层堆叠的影响。
- 不平衡与阈值阶段:针对欺诈场景的类别不平衡,学习重采样、损失函数设计、阈值移动与代价敏感决策。
- 评估与实战阶段:使用AUC、PR-AUC、KS、召回率@固定精度等指标,完成端到端项目复盘与调优。
核心观点:在欺诈检测中,模型输出的概率并不是最终决策。真正决定业务效果的是“阈值”。同一个模型,阈值从0.5调整到0.9,可能让召回率下降一半,也可能让误杀率降低一个数量级。因此,本课程把“阈值优化”提升到与“模型训练”同等重要的位置。
核心原理:GNN如何做欺诈节点分类
GNN的核心思想是消息传递。以经典的GraphSAGE为例,每个节点在每一层都会从邻居节点收集信息,经过聚合函数(如均值、最大池化、LSTM)得到邻居表示,再与自身表示拼接或相加,经过线性变换和非线性激活,得到新的节点表示。经过K层传播,每个节点就能看到K跳范围内的邻居信息。对于欺诈检测,这意味着一个账号的风险评分会间接受到其“邻居的邻居”的影响,从而识别出团伙性欺诈。
# GraphSAGE单层消息传递的简化逻辑
h_self = W_self @ h[v]
h_neigh = aggregate({h[u] for u in neighbors(v)})
h_new[v] = relu(h_self + W_neigh @ h_neigh)

# 节点分类输出
logits = classifier(h_new[v])
prob = sigmoid(logits)          # 欺诈概率
pred = 1 if prob >= threshold else 0
在实际工程中,我们通常把问题建模为二分类节点分类任务:每个节点有一个标签(欺诈/正常),模型输出欺诈概率。训练时使用交叉熵损失,但会面临正负样本极度不平衡的问题。此时可以引入类别权重、Focal Loss或阈值优化来缓解。
案例场景:电商刷单团伙识别
假设我们有一个电商平台,需要识别刷单团伙。原始数据包括:用户表、订单表、设备表、收货地址表。我们可以构建一张异构图:用户、设备、地址、商品作为节点,下单、登录、收货等行为作为边。标签来自历史人工标注和风控确认的刷单账号。模型训练后,对每个用户节点输出刷单概率。业务方希望在高精度下尽可能提高召回率,因为误杀正常用户成本很高。此时,阈值优化就成为关键:我们可以绘制PR曲线,选择满足“精度≥95%”前提下召回率最大的阈值。
| 阶段 | 关键任务 | 常用方法/指标 | 常见风险 |
|---|---|---|---|
| 图构建 | 定义节点、边、特征、标签 | 异构图、同构图、特征归一化 | 边定义错误导致信息泄漏 |
| 模型训练 | 学习节点表示并分类 | GCN、GraphSAGE、GAT | 过平滑、过拟合、邻居采样偏差 |
| 不平衡处理 | 缓解正负样本比例失衡 | 类权重、Focal Loss、重采样 | 重采样破坏图结构 |
| 阈值优化 | 选择业务最优决策阈值 | PR曲线、代价敏感、KS | 在测试集上调阈值造成泄漏 |
| 业务评估 | 验证实际风控效果 | 召回率@精度、误杀率、拦截金额 | 只看AUC忽略业务成本 |
误区与复盘:初学者最容易踩的坑
在进入后续章节之前,有必要先明确几个常见误区。第一,把图神经网络当成“更复杂的XGBoost”,只关注节点特征,忽略边和邻居结构,这样GNN的优势无法发挥。第二,在划分训练集和测试集时随机打乱节点,导致同一团伙的节点同时出现在训练集和测试集,造成严重的信息泄漏,指标虚高。第三,只关注AUC,忽略PR-AUC和业务阈值。在极端不平衡场景下,AUC可能看起来不错,但模型在实际阈值下召回率极低。第四,直接在测试集上选择阈值,正确做法是在验证集上选择阈值,再在测试集上评估。
特别提醒:欺诈检测中的时间维度非常重要。训练集应使用过去时间窗口的数据,测试集使用未来时间窗口的数据,模拟真实上线场景。随机划分会高估模型效果,导致上线后效果大幅下降。
本课程后续将沿着“图构建—模型训练—不平衡处理—阈值优化—业务评估”这条主线逐步展开。每一章都会结合可运行的代码片段和真实场景参数,帮助你把GNN从理论落到欺诈检测的工程实践中。现在,你已经建立了整体认知:欺诈检测的本质是关系型风险识别,GNN通过消息传递聚合邻居信息,而阈值优化则决定模型最终的业务价值。