3. 不平衡样本问题
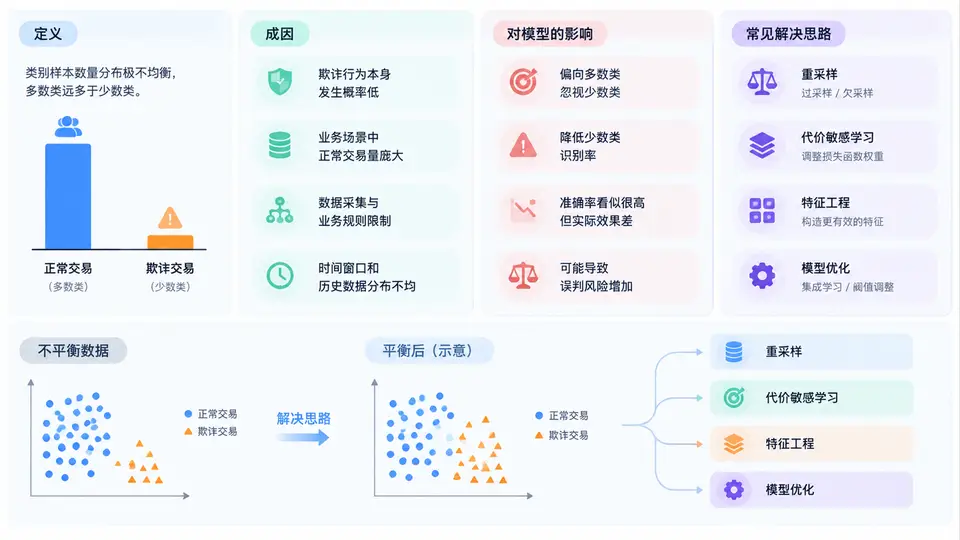
在交易欺诈识别场景中,我们面对的数据往往不是“正常交易与欺诈交易各占一半”的理想分布。真实业务中,欺诈样本可能只占总交易的千分之一、万分之一,甚至更低。这种类别分布严重偏斜的现象,就是不平衡样本问题。它不是一个单纯的数据统计问题,而是会直接影响模型训练目标、评估方式和最终业务效果的核心工程问题。
一、什么是不平衡样本问题
不平衡样本问题,通常指分类任务中不同类别的样本数量差异显著。以二分类为例,设多数类为正常交易,少数类为欺诈交易,若少数类占比低于10%,甚至低于1%,就可以认为存在明显不平衡。更严谨地说,不平衡不仅是数量比例问题,还包括类内不平衡、边界样本稀少和概念漂移下的分布变化。
在欺诈交易中,常见的数据形态是:
- 正常交易:数量巨大,模式稳定,但内部差异也很大;
- 欺诈交易:数量极少,手法变化快,单笔金额、时间、设备、商户等特征分布与正常交易重叠严重;
- 标签获取滞后:很多欺诈行为在交易发生时并未被确认,导致训练集中存在漏标和错标。
因此,不平衡样本问题不能简单理解为“少数类样本少”,而应理解为:在有限且嘈杂的少数类信号中,模型难以学到稳定、可泛化的决策边界。
二、不平衡问题的成因
交易欺诈数据的不平衡并非偶然,而是业务机制自然导致的结果。主要成因可以归纳为以下几类:
| 成因类别 | 具体表现 | 对建模的影响 |
|---|---|---|
| 业务本质 | 欺诈行为本身是低频异常事件,正常交易占绝对多数 | 模型倾向于预测多数类,少数类召回率低 |
| 风控拦截 | 已有规则会提前拦截部分欺诈,导致进入模型的欺诈样本更少 | 训练数据不能代表真实攻击分布,存在选择偏差 |
| 标签延迟 | 欺诈确认依赖人工审核、投诉、拒付等后续流程 | 训练集标签不完整,少数类被进一步低估 |
| 攻击演化 | 欺诈手法不断变化,旧样本无法覆盖新攻击 | 模型泛化能力下降,概念漂移加剧 |
| 采样偏差 | 数据采集、存储、抽样过程偏向正常交易 | 少数类样本多样性不足,边界模糊 |
理解成因的意义在于:解决不平衡问题不能只靠“调采样比例”,还要结合业务拦截逻辑、标签质量和攻击演化规律综合处理。
三、不平衡对模型的影响
不平衡样本对模型的影响,首先体现在损失函数被多数类主导。以逻辑回归、XGBoost等常见模型为例,训练目标通常是最小化整体损失。当正常交易占99.9%时,模型只要全部预测为正常,就能获得99.9%的准确率,但欺诈召回率为0。这种模型在业务上毫无价值。
具体影响包括:
- 决策边界偏移:模型为了降低整体误差,倾向于把靠近边界的少数类样本判为多数类;
- 概率估计失真:输出概率偏向多数类,导致阈值难以直接使用;
- 评估指标误导:准确率、AUC在某些极端不平衡下仍可能虚高,无法反映欺诈识别能力;
- 特征学习不充分:少数类样本太少,树模型难以在少数类上形成有效分裂;
- 阈值选择困难:业务需要在召回率、误杀率和人工审核成本之间权衡,不平衡会放大这种矛盾。
常见误区:很多人认为“只要上采样少数类就能解决不平衡”。实际上,随机过采样容易导致少数类过拟合,随机欠采样会丢失多数类中的重要信息,SMOTE在类别重叠严重时可能生成噪声样本。不平衡处理必须与模型、阈值和业务成本联合设计。
四、常见解决思路分类
针对不平衡样本,常见方法可以分为四大类:数据层、算法层、评估层和业务层。它们不是互斥的,实际项目中往往组合使用。
1. 数据层方法
数据层方法直接调整训练集分布,包括过采样、欠采样和混合采样。随机过采样复制少数类,简单但易过拟合;随机欠采样减少多数类,可能丢失信息;SMOTE及其变体通过插值生成少数类样本,适合特征空间连续且类别边界清晰的情况。
# 以 imblearn 为例的 SMOTE 过采样
from imblearn.over_sampling import SMOTE
from collections import Counter

print("原始分布:", Counter(y_train))
smote = SMOTE(random_state=42, k_neighbors=5)
X_res, y_res = smote.fit_resample(X_train, y_train)
print("过采样后分布:", Counter(y_res))
2. 算法层方法
算法层方法不改变原始数据分布,而是调整模型训练过程。典型做法包括:
- 类别权重:在XGBoost中设置
scale_pos_weight,提高少数类损失权重; - 焦点损失:降低易分类样本权重,让模型关注难分样本;
- 代价敏感学习:为误判少数类设置更高代价;
- 集成方法:如EasyEnsemble、BalanceCascade,通过多个子模型平衡训练。
# XGBoost 中设置类别权重
# scale_pos_weight 通常设为 负样本数 / 正样本数
params = {
    "objective": "binary:logistic",
    "eval_metric": "aucpr",
    "scale_pos_weight": neg_count / pos_count,
    "max_depth": 6,
    "eta": 0.05,
    "subsample": 0.8,
    "colsample_bytree": 0.8
}
3. 评估层方法
不平衡场景下,评估指标必须从准确率转向PR-AUC、召回率、F1、KS、欺诈捕获率等。尤其推荐使用PR曲线,因为它在少数类极度稀少时比ROC曲线更敏感。阈值也不应固定为0.5,而应基于业务成本曲线选择。
4. 业务层方法
业务层方法包括调整审核策略、分层抽样、引入专家规则、延迟标签回补、在线学习等。例如,在交易欺诈中,可以将“高概率欺诈”直接拦截,“中概率”转人工审核,“低概率”放行,从而把模型输出转化为可执行的业务动作。
实战建议:在XGBoost欺诈建模中,优先尝试scale_pos_weight和PR-AUC评估,再考虑SMOTE等重采样方法。若少数类样本极少且噪声大,重采样可能不如代价敏感学习稳定。最终方案应通过时间外验证和业务成本矩阵确认。
五、案例复盘:某支付场景的欺诈建模
某支付平台日均交易1000万笔,欺诈交易约500笔,正负样本比约1:20000。初期模型使用准确率和AUC评估,准确率高达99.99%,但欺诈召回率不足15%。复盘发现:模型几乎全部预测为正常,少数类信号被淹没。
调整方案分三步:第一,将评估指标改为PR-AUC和Top-K召回率;第二,在XGBoost中设置scale_pos_weight,并加入eval_metric="aucpr";第三,对少数类进行SMOTE与欠采样组合,同时保留原始验证集不重采样。最终在相同误杀率下,欺诈召回率提升到62%,人工审核量下降约30%。
这个案例说明:不平衡问题的解决不是单一技巧,而是数据、算法、评估、业务四层协同的结果。只有把模型指标翻译成业务收益,才算真正解决了不平衡问题。