1. 课程导入
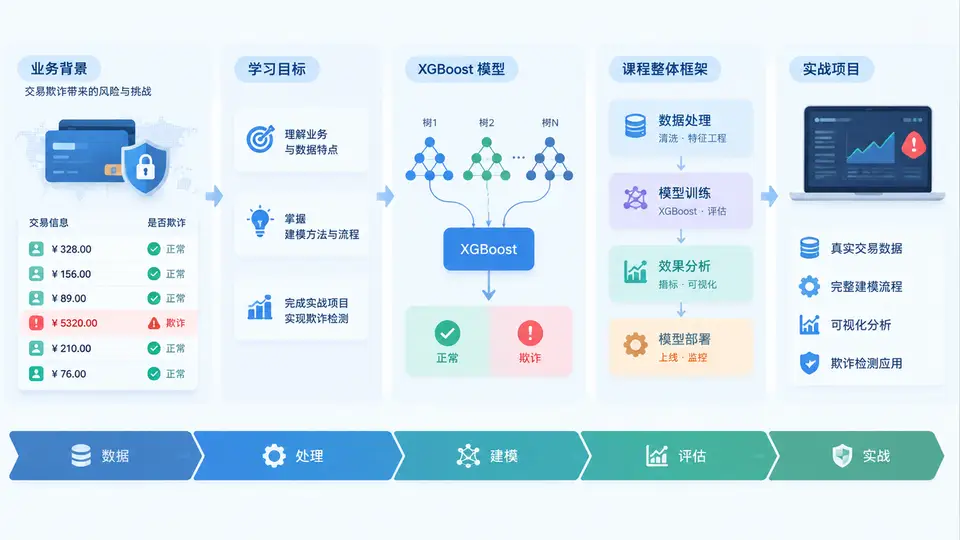
一、业务背景:为什么交易欺诈检测值得单独建模
在支付、电商、消费金融、虚拟账户与跨境结算等场景中,交易欺诈是直接吞噬利润、破坏用户信任并引发监管风险的核心问题。欺诈者会利用盗卡、撞库、账户接管、虚假注册、优惠券套现、洗钱拆分等手段,在极短时间内完成批量攻击。对业务方而言,漏判一笔欺诈可能带来资金损失与拒付罚款,误判一笔正常交易则可能造成用户体验下降、客服成本上升甚至客户流失。因此,交易欺诈检测不是单纯的分类问题,而是在极端不平衡样本下,对风险召回、误杀成本与人工审核容量进行综合权衡的决策系统。
真实交易数据通常呈现三个显著特征:第一,欺诈样本占比极低,常见在0.1%到2%之间,极端场景甚至低于0.05%;第二,欺诈行为具有对抗性与漂移性,攻击模式会随风控规则升级而快速变化;第三,业务对时效性要求高,很多场景需要在毫秒级完成评分与拦截。传统规则引擎可解释、响应快,但难以覆盖复杂组合模式;逻辑回归等线性模型稳定但表达能力有限;XGBoost凭借对非线性关系、特征交互与不平衡数据的良好适应性,成为交易欺诈建模中的主流强基线。
二、学习目标:从“会调包”到“能交付”
本课程不是简单的API教学,而是围绕真实项目交付链路设计。完成课程后,你应能够独立完成以下任务:
- 理解业务与指标:区分欺诈检测中的准确率、召回率、精确率、F1、AUC、PR-AUC与业务成本指标,明确为何不平衡场景下PR-AUC比ROC-AUC更具参考价值。
- 处理不平衡样本:掌握类别权重、scale_pos_weight、过采样、欠采样、SMOTE及其变体的适用边界,避免在时间序列交易数据中错误使用随机过采样导致标签泄漏。
- 构建特征体系:能够设计交易金额、频次、时间窗口、设备指纹、地理位置、商户类别、用户行为序列等特征,并处理缺失值、异常值与高基数类别特征。
- 训练与调优XGBoost:理解booster、eta、max_depth、subsample、colsample_bytree、min_child_weight、gamma、lambda、alpha等参数对不平衡学习的影响,并能使用早停与交叉验证控制过拟合。
- 评估与解释模型:使用混淆矩阵、KS、PR曲线、SHAP值、特征重要性与部分依赖图,向风控、运营与合规团队解释模型决策。
- 完成工程落地:将模型封装为可复现的训练流水线与推理服务,设计阈值策略、人工审核队列与模型监控方案。
三、课程整体框架:30章如何组织
课程按“业务理解—数据准备—特征工程—模型训练—评估解释—工程落地—项目复盘”的主线推进,共30章。前6章建立业务与数据基础,中间12章深入XGBoost建模与不平衡处理,后12章聚焦评估、解释、部署、监控与完整项目实战。整体结构如下表所示:
| 阶段 | 章节范围 | 核心内容 | 阶段产出 |
|---|---|---|---|
| 业务与数据基础 | 第1–6章 | 欺诈业务背景、数据探索、不平衡诊断、时间切分、基线模型 | 数据理解报告与基线方案 |
| 特征与不平衡处理 | 第7–14章 | 窗口特征、行为序列、类别编码、采样策略、代价敏感学习 | 特征宽表与采样实验结论 |
| XGBoost建模与调优 | 第15–22章 | 目标函数、树生长策略、超参搜索、早停、交叉验证、集成 | 可复现训练流水线与最优模型 |
| 评估、解释与部署 | 第23–30章 | PR-AUC、KS、SHAP、阈值优化、推理服务、监控与项目复盘 | 上线方案与完整项目报告 |
四、实战项目介绍:一个可复现的交易欺诈检测系统
课程贯穿一个完整实战项目:基于某支付平台的脱敏交易流水,构建XGBoost欺诈检测模型。数据集包含用户ID、商户ID、交易金额、交易时间、设备信息、IP归属地、历史行为统计与标签is_fraud。项目要求最终输出可解释的欺诈概率、可配置的拦截阈值以及人工审核建议。
项目流程分为七步:
- 数据加载与质量检查:确认时间范围、标签分布、缺失率与重复交易。
- 时间切分:按时间划分训练集、验证集与测试集,严禁随机切分造成未来信息泄漏。
- 特征工程:构造金额偏离度、近1小时交易频次、设备更换次数、异地交易标识等。
- 不平衡处理:对比scale_pos_weight、欠采样与SMOTE在验证集上的PR-AUC与召回率。
- 模型训练:使用XGBoost二分类,配合早停与网格/贝叶斯调参。
- 评估与解释:输出混淆矩阵、PR曲线、KS与SHAP摘要图。
- 阈值与部署:根据误杀成本与审核容量确定阈值,封装推理接口。
# 项目核心训练入口示例
import xgboost as xgb
from sklearn.metrics import average_precision_score

dtrain = xgb.DMatrix(X_train, label=y_train)
dvalid = xgb.DMatrix(X_valid, label=y_valid)

params = {
    "objective": "binary:logistic",
    "eval_metric": ["aucpr", "auc"],
    "eta": 0.05,
    "max_depth": 6,
    "subsample": 0.8,
    "colsample_bytree": 0.8,
    "scale_pos_weight": neg_count / pos_count,
    "seed": 42
}

model = xgb.train(
    params,
    dtrain,
    num_boost_round=2000,
    evals=[(dvalid, "valid")],
    early_stopping_rounds=100,
    verbose_eval=100
)

y_prob = model.predict(dvalid, iteration_range=(0, model.best_iteration + 1))
print("PR-AUC:", average_precision_score(y_valid, y_prob))
五、常见误区与复盘提示
- 误区一:只看准确率。在0.5%欺诈率下,全部预测为正常即可获得99.5%准确率,但召回为0。必须使用PR-AUC、召回率与业务成本指标。
- 误区二:随机过采样后再切分。这会让同一用户的复制样本同时出现在训练与验证集,造成严重标签泄漏。应先按时间切分,再在训练集内采样。
- 误区三:盲目追求高召回。召回提升往往伴随误杀上升,需结合人工审核容量与单笔误杀成本确定阈值。
- 误区四:忽略特征时间窗口。使用未来统计量作为特征会在线下评估中虚高,上线后迅速失效。