3. 交易序列数据基础
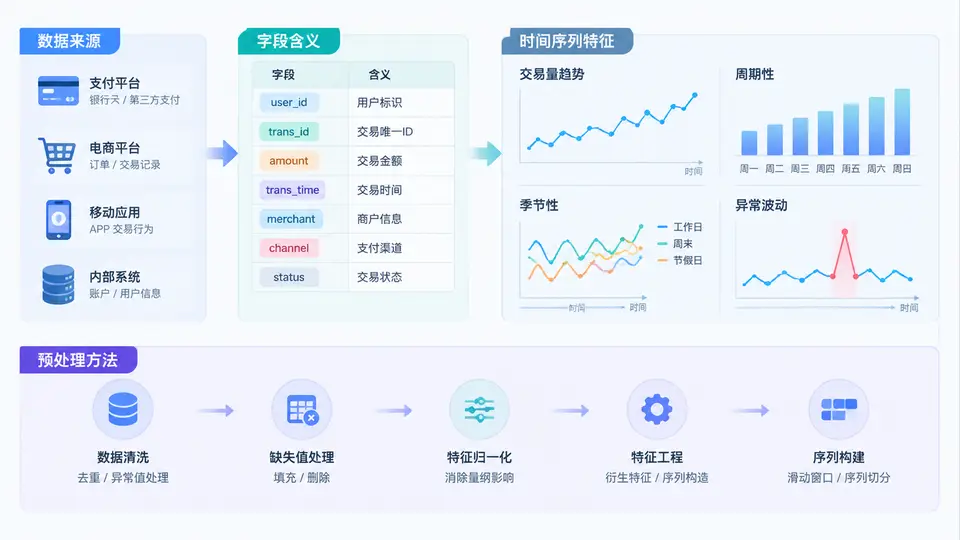
在把 Transformer 用于欺诈识别之前,必须先回答一个更基础的问题:模型到底“吃”进去的是什么。交易序列数据不是一张静态表,而是“用户—时间—行为”的三维切片。理解数据来源、字段语义与时间结构,决定了后续特征工程与模型上限。本节围绕四个模块展开:数据来源与字段、时间序列特征、预处理流程、常见误区与复盘。
一、核心原理:交易序列的本质结构
一笔交易可抽象为事件元组 (uid, ts, amount, type, counterpart, device, geo, label)。欺诈识别的关键不在于单笔交易是否异常,而在于该笔交易在用户历史行为序列中的位置与偏离程度。因此,原始数据需要被组织成“按用户分组、按时间排序”的序列样本,再切分为固定或变长窗口输入 Transformer。
时间序列特征通常分为三类:
- 静态属性:用户注册时长、KYC 等级、账户类型,不随时间变化。
- 动态行为:近 1 小时交易笔数、金额均值、夜间交易占比,随时间滑动。
- 序列上下文:相邻交易的时间间隔、金额变化率、商户类别转移,体现行为模式。
欺诈信号往往藏在“变化”里:金额突增、设备切换、地理位置跳跃、交易频率骤升。Transformer 的自注意力机制正是为捕捉这类长距离依赖而设计,但前提是输入序列已经正确编码了时间与行为语义。
二、数据来源与字段含义
真实项目中,交易数据通常来自多个系统:核心交易库、风控事件流、设备指纹服务、第三方征信接口。下表列出常见字段及其在欺诈识别中的用途。
| 字段 | 类型 | 含义 | 欺诈识别用途 |
|---|---|---|---|
| uid | string | 用户唯一标识 | 序列分组键 |
| ts | timestamp | 交易发生时间 | 排序、时间间隔、周期特征 |
| amount | float | 交易金额 | 金额突变、离群检测 |
| type | category | 交易类型(转账/消费/提现) | 类型转移模式 |
| counterpart | string | 对手方账户 | 团伙关联、环路检测 |
| device_id | string | 设备指纹 | 设备切换、多账号共用 |
| geo | string | 交易地理位置 | 地理跳跃、异地登录 |
| label | 0/1 | 是否欺诈 | 监督学习目标 |
需要注意:label 往往极度不平衡,欺诈占比可能低于 0.1%。此外,标签存在延迟确认问题——一笔交易可能在数天后才被确认为欺诈,这会影响训练集构建的时间切分策略。
三、时间序列特征工程与预处理流程
预处理的目标是把原始事件流转换为模型可消费的张量。推荐流程如下:
- 清洗:去除重复交易、修正时间戳时区、处理缺失的设备与地理字段。
- 排序与分组:按
uid分组,按ts升序排列,确保序列因果性。 - 时间特征构造:计算相邻交易时间差
delta_t、小时、星期、是否节假日。 - 滑窗统计:对每个时间点计算过去 1h/24h/7d 的金额均值、笔数、方差。
- 类别编码:对
type、geo等做 embedding 或 one-hot。 - 数值归一化:金额做 log 变换后标准化,时间差做分桶或对数变换。
- 序列截断与填充:设定最大长度 L,超长截断、不足填充,并生成 attention mask。
# 示例:按用户构造交易序列窗口
import pandas as pd
import numpy as np

df = df.sort_values(["uid", "ts"])
df["delta_t"] = df.groupby("uid")["ts"].diff().dt.total_seconds().fillna(0)
df["amount_log"] = np.log1p(df["amount"])

# 滑窗统计:过去24小时交易笔数与金额均值
df["cnt_24h"] = (
    df.groupby("uid")
      .rolling("24h", on="ts")["amount"]
      .count().reset_index(drop=True)
)
df["amt_mean_24h"] = (
    df.groupby("uid")
      .rolling("24h", on="ts")["amount"]
      .mean().reset_index(drop=True)
)

# 截断为固定长度序列
MAX_LEN = 50
def build_sequence(g):
    g = g.tail(MAX_LEN)
    return g[["amount_log", "delta_t", "cnt_24h", "amt_mean_24h"]].values

sequences = df.groupby("uid").apply(build_sequence)
时间差
delta_t 建议做对数变换或分桶,因为原始秒级差值跨度极大,直接输入会干扰注意力权重分布。金额同理,log1p 能显著缓解长尾。四、案例场景与误区复盘
场景:某支付平台发现一批账户在凌晨 2–4 点集中发生小额转账,单笔金额正常,但序列呈现“高频、短间隔、固定对手方”模式。若只看单笔交易,模型难以识别;但将 delta_t、cnt_24h 与对手方 embedding 组成序列后,Transformer 能通过注意力捕捉到这种周期性团伙行为。
常见误区:
- 时间泄漏:用未来交易统计当前特征,导致离线指标虚高。必须严格按时间切分训练/验证集。
- 忽略因果性:随机划分样本会破坏序列顺序,使模型“偷看”未来。
- 填充值污染:用 0 填充缺失时间差,可能被模型误读为“瞬时连续交易”。应使用 mask 或特殊标记。
- 标签延迟未处理:近期样本标签不完整,直接训练会引入噪声。可采用时间衰减权重或延迟窗口。
预处理阶段最容易被低估的是时间对齐。不同数据源的时间戳精度可能不同(秒级 vs 毫秒级),设备与地理信息可能滞后到达。建议统一到同一时区与精度,并为每个字段记录“事件时间”与“入库时间”,以便排查泄漏。